 Anthropic 团队
在应用级 AI 领域,提示词工程(Prompt Engineering)已经占据了数年的聚光灯;而如今,一个全新的概念正走向台前:上下文工程(Context Engineering)。用大语言模型(LLM)构建系统的核心难题,正在从「如何为提示词找到最巧妙的字词与句式」,转向回答一个更宏大的工程问题:「怎样的上下文配置,最有可能让模型稳定产生我们期望的行为?」
上下文(Context),指的是在向大语言模型采样推理时一并送入模型的全部 Token(模型处理文本的最小切分单位)集合。摆在我们面前的工程问题,是在大语言模型固有的能力约束下,最大化这些 Token 的效用,从而稳定、一致地达成预期结果。想要真正驯服大语言模型,往往需要建立起**「以上下文为中心(thinking in context)」**的思维方式——换句话说,就是时刻审视模型在任意时间点所能看到的完整全局状态,并预判这一状态可能诱导出怎样的行为表现。
在本文中,我们将深入探索上下文工程这门新兴技艺,并为你提供一套经过实战打磨的心智模型,帮助你构建出可精准驾驭、高效可靠的 AI Agent。
导读:如何把这篇 Anthropic 官方「上下文工程」方法论用到日常 Agent 开发中? 这篇文章是 Anthropic 整个 Agent 工程体系的「底层总纲」——我们在精选中收录的《Agent Skills 最佳实践》、《为长时间运行的 Agent 构建高效 Harness》以及《长周期应用开发中的 Harness 设计》,本质上都是本文方法论在具体场景下的延伸。无论你在写
CLAUDE.md、封装 Skill,还是设计多 Agent 工作流,都可以直接记住这 4 条黄金法则:
- 把上下文当成「边际收益递减的有限注意力预算」:窗口大不代表可以随便塞。每多塞入一段无关历史或冗余文档,都会稀释模型对关键指令的注意力(即「上下文腐化 Context Rot」)。
- 系统提示词要找准「黄金颗粒度」:既不要写满脆弱的
if-else硬编码死规矩,也不要只写空洞的口号;先用最强模型测极简版提示词,再针对真实翻车案例补齐清晰的行为准则与结构化分节。- 用「按需即时检索(Just-in-time)」替代「开局一股脑全塞」:把轻量级索引(文件路径、目录层级、命名规范)留在外面,让 Agent 像人类查资料一样通过
glob、grep和文件读取实现渐进式披露(Progressive Disclosure)——这正是 Skill 三层渐进加载机制的理论源头。- 长周期任务靠「压缩 + 外部笔记 + 子 Agent 隔离」三板斧:对话变长时及时清理历史工具调用的原始返回结果;用
NOTES.md或feature_list.json把关键状态持久化到窗口之外;遇到需要翻阅海量资料的支线任务,派发给拥有独立干净窗口的子 Agent(Sub-agent)去探索,只把一两千 Token 的浓缩结论交回主 Agent。
上下文工程 vs. 提示词工程(Context engineering vs. prompt engineering)
在 Anthropic,我们将上下文工程视为提示词工程顺理成章的演进方向。提示词工程聚焦于如何编写和组织大语言模型的指令以获得最佳输出(可参阅我们的官方提示词工程文档了解核心概览与实用策略);而上下文工程则是指在大语言模型推理过程中,围绕「如何筛选、策展并维护最优 Token(信息)集合」所采取的一整套策略——这不仅包括提示词本身,还涵盖了提示词之外所有会进入上下文窗口的信息。
在大语言模型工程落地早期,编写提示词占据了 AI 工程工作的绝大部分比重,因为当时除了日常聊天之外,绝大多数应用场景都是针对单轮分类(one-shot classification)或单次文本生成任务做提示词调优。顾名思义,提示词工程的核心关注点在于如何写出高效的提示词,尤其是系统提示词(System Prompt)。然而,随着我们迈向工程化构建能力更强的 Agent——它们需要跨越数十乃至数百轮推理循环、在更长的时间跨度上持续运行——我们就必须拥有一套能够管理完整上下文状态的策略,这其中包括:系统指令、工具定义、模型上下文协议(Model Context Protocol,简称 MCP)、外部数据以及不断增长的消息历史(Message History)等。
一个在循环(Loop)中持续运转的 Agent,每走一步都会源源不断地产生可能对下一轮推理有用的新数据;这些信息必须经过周而复始的筛选与提炼。上下文工程,正是从那个不断膨胀演化的潜在信息宇宙中,精心策展「哪些内容应该进入有限上下文窗口」的科学与艺术。
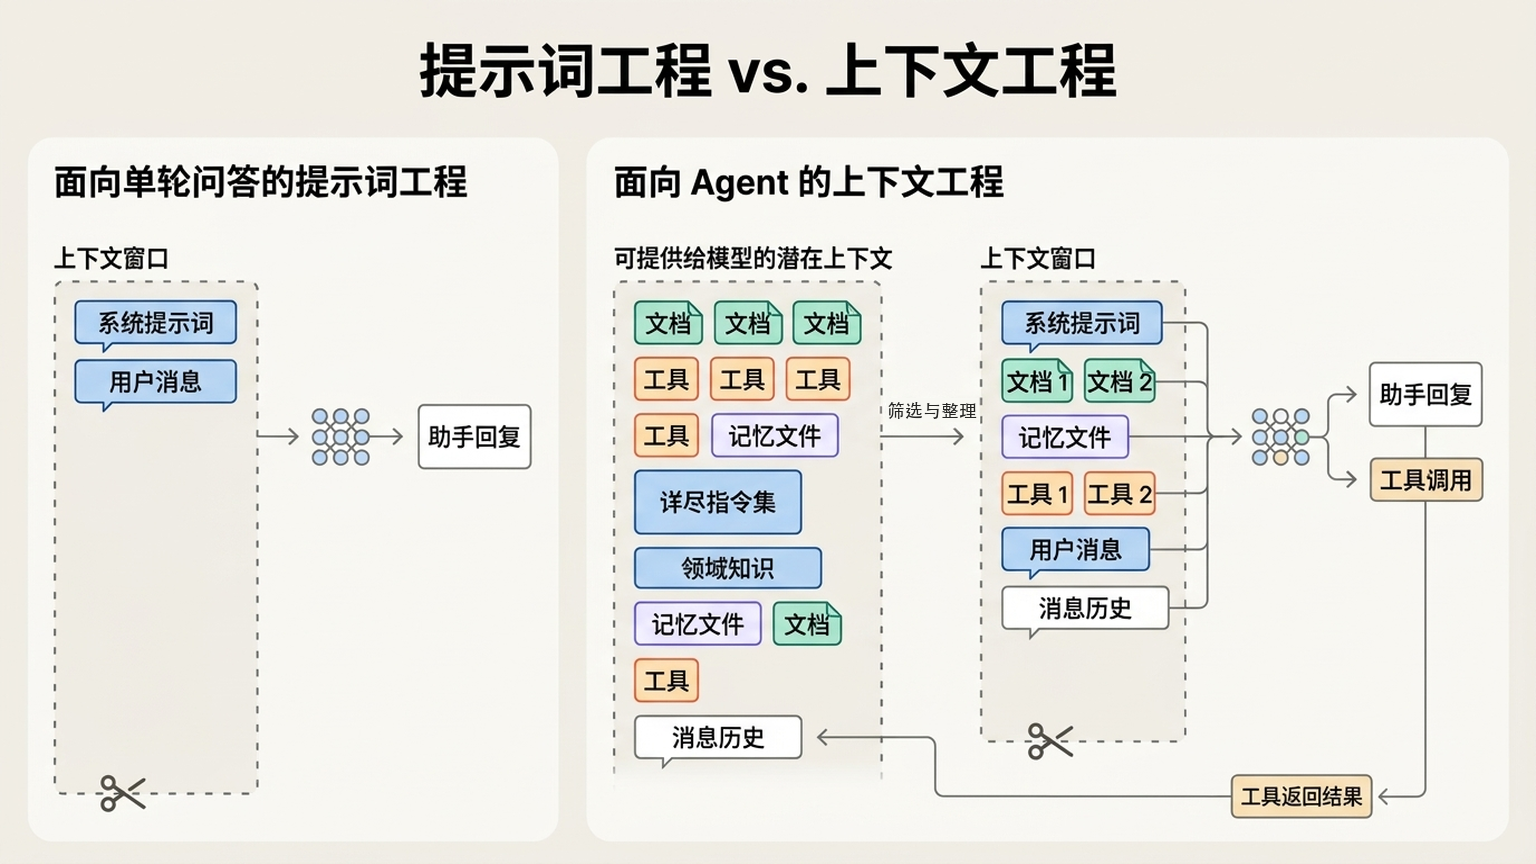
与编写单条提示词这种一次性、离散的任务不同,上下文工程是一个持续迭代的过程——每当我们决定下一步要把哪些信息传给模型时,这一轮「筛选与策展(Curation)」阶段就会重新发生一次。
为什么上下文工程对构建强力 Agent 至关重要(Why context engineering is important to building capable agents)
尽管大语言模型处理数据的速度极快、能够容纳的数据体量也越来越大,但我们观察到,大语言模型和人类一样,一旦信息量超过某个临界点,就会开始失焦或陷入混乱。针对「大海捞针(needle-in-a-haystack)」类基准测试的多项研究,揭示了**「上下文腐化(Context Rot)」**这一现象(详见 Chroma 团队关于 Context Rot 的研究报告):随着上下文窗口内的 Token 数量不断增加,模型从该上下文中准确回忆并提取信息的能力会随之下降。
虽然不同模型的性能衰减曲线有陡有缓,但这一特征在所有模型身上都会普遍出现。因此,上下文必须被视为一种边际收益递减的有限资源。就像人类的工作记忆容量有限一样,大语言模型在解析海量上下文时,同样依赖一笔有限的**「注意力预算(Attention Budget)」**。每引入一个新的 Token,都会在一定程度上消耗这笔预算,这就迫使我们必须精打细算地筛选送入模型的每一个 Token。
这种「注意力稀缺」源于大语言模型底层的架构约束。大语言模型建立在 Transformer 架构之上,该架构允许整个上下文中的每一个 Token 与其他所有 Token 建立注意力关联(attend to every other token)。这意味着,对于 $n$ 个 Token,模型需要计算并维护 $n^2$ 个成对关系(pairwise relationships)。
随着上下文长度不断增加,模型捕捉这些成对关系的能力会被摊薄,从而在「上下文规模」与「注意力聚焦度」之间形成一种天然的张力。此外,模型的注意力模式是从训练数据分布中学到的,而在训练语料中,短序列出现的频率通常远高于长序列。这意味着模型在处理跨越整个超长上下文的远距离依赖关系时,不仅训练经验更少,专门用于处理这类关系的特化参数也更有限。
像位置编码插值(Position Encoding Interpolation)这样的技术,虽然能让模型把原本在较短上下文上训练出的机制适配到更长的序列上,却也会在对 Token 精确位置的理解上带来一定程度的精度折损。这些因素叠加在一起,形成了一条平滑衰减的性能梯度(performance gradient),而非突然坠落的悬崖:模型在超长上下文下依然具备很强的能力,但相比于在简短、紧凑上下文中的表现,它在信息检索精度与长程推理能力上都会出现一定下滑。
这些客观规律决定了:想要构建出真正能打的 Agent,深思熟虑的上下文工程是不可或缺的基石。
高效上下文的解剖结构(The anatomy of effective context)
既然大语言模型受制于有限的注意力预算,那么优秀的上下文工程,本质上就是寻找尽可能小的一组高信号(high-signal)Token 集合,以最大化达成预期结果的概率。这句指导原则说起来容易做起来难,接下来我们就逐一拆解,看看它在上下文的各个核心组件中具体意味着怎样的工程实践。
1. 系统提示词:寻找颗粒度的「黄金区间」
系统提示词(System Prompts)应当极其清晰,用简单、直接的语言,在恰当的「抽象高度(right altitude)」上向 Agent 阐述要求。所谓恰当的高度,就是介于两种常见失败模式之间的「黄金区间(Goldilocks zone)」:
- 在一个极端(过于死板琐碎):我们经常看到工程师在提示词里硬编码(hardcode)极其复杂、脆弱的
if-else分支逻辑,试图强行规定 Agent 在每一种细分情况下的精确动作。这种做法不仅脆弱易碎,还会让后续的维护复杂度随时间呈指数级失控。 - 在另一个极端(过于宽泛笼统):工程师有时又只给出空洞、高高在上的指导原则,既没有为大语言模型提供期望输出的具体信号,又错误地假设模型天生拥有和人类一样的隐性背景上下文。
- 最佳的黄金高度则在这两者之间取得了平衡:既足够具体,能够有效引导模型的行为方向;又保留了足够的弹性,为模型提供强有力的启发式准则(heuristics)来灵活应对复杂情况。
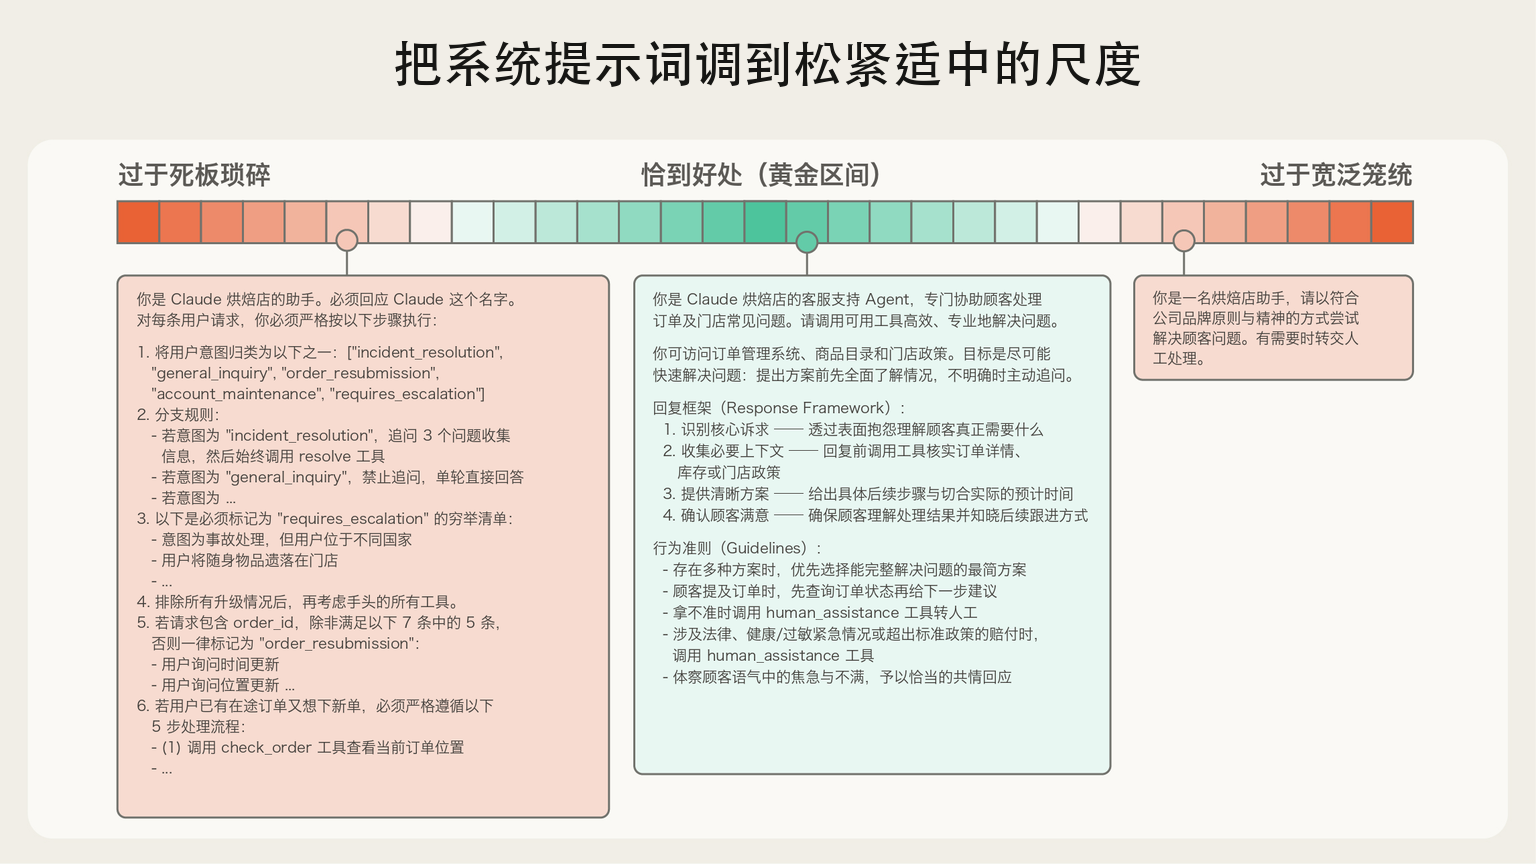
如上图所示,在刻度尺的左端是脆弱易碎的 if-else 硬编码提示词,而在右端则是过于笼统、错误假设模型已懂背景知识的宽泛提示词。为了便于你直观对比这三种颗粒度的差异,我们将图中「Claude 烘焙店客服 Agent」的三份系统提示词整理对照如下:
# ❌ 极端一:过于死板琐碎(Too specific —— 脆弱的 if-else 硬编码)
You are a helpful assistant for Claude's Bakery.
You must respond to the name Claude.
For every user request you MUST FOLLOW THESE STEPS:
1. Identify the user intent as one of the following: ["incident_resolution", "general_inquiry", "order_resubmission", "account_maintenance", "requires_escalation"]
2. - if user intent is "incident_resolution", ask 3 followup questions to gather information, then always call the resolve tool
   - if user intent is "general_inquiry", do not ask followup questions and answer in one shot
   - if user intent ...
3. Here is an exhaustive list of cases that should be tagged as "requires_escalation":
   - If the intent is incident_resolution but the user is in a different country
   - If the user left a physical belonging in the store ...

# ✅ 黄金区间:恰到好处(Just right —— 目标清晰 + 结构化框架 + 启发式准则)
You are a customer support agent for Claude's Bakery.
You specialize in assisting customers with their orders and basic questions about the bakery. Use the tools available to you to resolve the issue efficiently and professionally.

You have access to order management systems, product catalogs, and store policies. Your goal is to resolve issues quickly when possible. Start by understanding the complete situation before proposing solutions, ask follow-up questions if you do not understand.

Response Framework:
  1. Identify the core issue - Look beyond surface complaints to understand what the customer actually needs
  2. Gather necessary context - Use available tools to verify order details, check inventory, or review policies before responding
  3. Provide clear resolution - Offer concrete next steps with realistic timelines
  4. Confirm satisfaction - Ensure the customer understands the resolution and knows how to follow up if needed

Guidelines:
  - When multiple solutions exist, choose the simplest one that fully addresses the issue
  - If a user mentions an order, check its status before suggesting next steps
  - When uncertain, call the human_assistance tool
  - For legal issues, health/allergy emergencies, or situations requiring financial adjustments beyond standard policies, call the human_assistance tool
  - Acknowledge frustration or urgency in the user's tone and respond with appropriate empathy

# ❌ 极端二:过于宽泛笼统(Too vague —— 缺乏具体抓手与边界)
You are a bakery assistant, you should attempt to solve customers issues in a manner consistent with the principles and essence of the company brand. Escalate to a human if needed.

# ------------------------------------------------------------------
# 中文对照说明:
# 1. 「过于死板琐碎」试图穷举所有边缘情况并写死「必须追问 3 个问题」「满足 7 条中的 5 条」等机械规则,一旦真实对话稍微偏离预设剧本就会直接卡死。
# 2. 「恰到好处」明确交代了角色、可用工具与核心目标,用 4 步「回复框架(Response Framework)」理清工作流,再用 5 条「行为准则(Guidelines)」划定底线与转人工边界。
# 3. 「过于宽泛笼统」只说了「符合公司品牌原则与精神」,模型根本不知道品牌原则是什么、有哪些工具可用、什么情况下才算「有需要转交人工」。
我们建议将系统提示词组织成职责分明的独立区块(例如 <background_information>、<instructions>、## Tool guidance、## Output description 等),并使用 XML 标签或 Markdown 标题来清晰划分这些区块的边界——不过随着底层模型的能力越来越强,具体的格式语法本身可能正变得不再那么挑剔。
无论你决定如何组织系统提示词的结构,你的核心目标都应该是追求能够完整勾勒预期行为的「最小信息集」(请注意,「最小」并不等同于「简短」;你依然需要在开局向 Agent 提供充足的信息,以确保它严格遵循期望的行为准则)。最稳妥的做法是:先拿你能用上的最强模型去测试一份极简提示词,观察它在目标任务上的实际表现;然后再根据初始测试中暴露出来的具体失效模式(failure modes),针对性地补充清晰指令与示例来提升表现。
2. 工具设计:高内聚、无重叠、省 Token
工具(Tools)让 Agent 能够与外部环境交互,并在工作过程中动态拉取全新的额外上下文。因为工具定义了 Agent 与其信息/行动空间之间的契约,所以工具的设计必须极致追求效率——既要保证工具返回的信息本身具备极高的 Token 效率,又要能够引导 Agent 做出高效的调用行为。
在《用 AI Agent 为 AI Agent 编写工具(Writing tools for AI agents – with AI agents)》一文中,我们曾深入讨论过如何构建让大语言模型一眼就能理解、且功能之间几乎没有重叠的工具集。就像优秀代码库里的函数设计一样,工具应当自包含(self-contained)、对错误具备良好的鲁棒性,并且在用途说明上极其清晰明确。同样地,工具的输入参数也应当命名直观、毫无歧义,充分顺应模型自身的理解优势。
我们在实战中最常看到的失败模式之一,就是臃肿膨胀的工具集——工具涵盖的功能过于杂乱,或者多个工具之间职责边界模糊,导致模型在「到底该调哪一个工具」的决策点上左右摇摆。记住一条简单的检验标准:如果连一名人类工程师在特定情境下都无法斩钉截铁地说出应该调用哪个工具,那就绝对不要指望 AI Agent 能做得更好。 正如我们后文还会谈到的,为 Agent 精心筛选出一套「最小可行工具集(minimal viable set of tools)」,还能让长周期交互中的上下文维护与修剪变得更加可靠。
3. 少样本示例:用多样化的典型范例代替边缘情况流水账
提供示例——也就是大家熟知的少样本提示(Few-shot Prompting)——依然是我们强烈推荐的最佳实践。然而,许多团队往往会试图把某个任务可能遇到的所有边缘情况(edge cases)通通罗列成一张冗长的规则流水账塞进提示词,妄想把大语言模型应当遵循的每一条细则都穷举出来。我们不建议这样做。 相反,我们建议花精力去筛选一组多样化且极具代表性的典型示例(diverse, canonical examples),用它们直观地勾勒出 Agent 的预期行为标准。对于大语言模型而言,一个好示例就是胜过千言万语的那张「图画」。
总而言之,横跨上下文各个组成部分(系统提示词、工具、示例、消息历史等)的总体原则只有一句话:深思熟虑,让你的上下文既信息饱满,又紧凑凝练。 接下来,让我们深入探讨如何在运行时(runtime)动态检索上下文。
上下文检索与 Agent 自主搜索(Context retrieval and agentic search)
在《构建高效的 AI Agent(Building effective AI agents)》一文中,我们曾重点区分了「基于大语言模型的工作流(Workflows)」与「自治 Agent(Agents)」。自那篇文章发布以来,我们愈发倾向于采用一个极其凝练的 Agent 定义:在循环中自主调用工具的大语言模型(LLMs autonomously using tools in a loop)。
在与客户并肩落地的过程中,我们看到整个行业都在向这一简洁的范式收敛。随着底层模型变得越来越聪明,Agent 的自主程度(autonomy)也随之水涨船高:更强大的模型能够让 Agent 独立在微妙复杂的问题空间中摸索导航,并从错误中自我恢复。
现在,我们正见证工程师设计 Agent 上下文思路的一次重大转变。如今,许多 AI 原生应用都在采用某种基于向量嵌入(embedding-based)的**推理前预检索(pre-inference time retrieval)机制,提前把可能重要的上下文捞出来摆在 Agent 面前供其推理。而随着整个领域向更具自主性的 Agent 范式演进,我们看到越来越多团队开始用「按需即时加载(Just-in-time)」**的上下文策略来增强乃至重塑现有的检索系统。
采用「按需即时加载」思路构建的 Agent,不再试图在开局前把所有相关数据一次性预处理并塞进上下文,而是只维护轻量级的标识符(Lightweight Identifiers)——比如文件路径、预存的查询语句、网页链接等——并在运行时利用工具,根据这些引用动态地把真正需要的数据加载进上下文窗口。Anthropic 的 Agent 编程工具 Claude Code 正是利用这一方式,在超大型数据库上完成复杂的数据分析任务:模型可以自行编写针对性的查询语句、将结果暂存下来,并结合 head、tail 等 Bash 命令去探查海量数据,而自始至终都不需要把庞大的原始数据对象完整读入上下文窗口。这种做法与人类的认知机制如出一辙:我们平时并不会把整座图书馆的资料死记硬背在脑子里,而是借助文件系统、收件箱、书签等外部组织与索引体系,在需要用到某条信息时再去按需调取。
除了显著节省上下文空间外,这些引用自带的**元数据(Metadata)**还提供了一种高效校准 Agent 行为的机制——无论这些信号是显式给出的,还是符合直觉的隐性线索。对于一个在文件系统中工作的 Agent 来说,看到 tests/ 目录下有一个名为 test_utils.py 的文件,与在 src/core_logic/ 目录下看到同名文件,所传递出的用途信号截然不同。文件夹的层级结构、命名规范以及文件时间戳,都在释放重要的上下文信号,帮助人类和 Agent 判断应当如何以及何时使用这些信息。
让 Agent 自主探索并调取数据,还天然促成了渐进式披露(Progressive Disclosure)——换句话说,允许 Agent 通过一步步探索,增量式地发现相关上下文。每一次交互都会返回新的线索,为下一步决策指明方向:文件大小暗示了模块的复杂程度;命名规范提示了文件的职责定位;修改时间戳则可以作为信息新旧与相关度的代用指标。Agent 可以像剥洋葱一样一层层拼出全局理解,在工作记忆中只保留当前真正必需的内容,并配合记笔记策略来实现额外的状态持久化。这种由 Agent 自主管理的上下文窗口,能让它始终聚焦于高相关的信息子集,而不是溺死在虽然详尽无遗、却绝大部分毫无关联的信息汪洋里(延伸阅读:我们在《Agent Skills 最佳实践》中详细拆解了如何利用三层渐进式披露来架构你自己的 Skill 目录)。
当然,这里同样存在工程权衡:运行时的自主探索,在速度上必然慢于直接读取预计算好的检索数据。 不仅如此,它还需要工程师做出鲜明且周密的设计,确保大语言模型手头配备了趁手的工具与清晰的启发式策略,才能在信息版图中高效导航。如果缺乏恰当的引导,Agent 很容易因为滥用工具、钻进死胡同或抓不住关键信息而白白浪费大量上下文。
在特定场景下,最高效的 Agent 往往会采用一种混合策略(Hybrid Strategy):开局先预加载一部分核心数据以保障响应速度,随后再根据任务需要自主决定是否展开深度的即时探索。至于「自主程度」的决策边界划在哪里最合适,完全取决于具体任务的特征。Claude Code 就是采用这种混合模型的典型代表:像 CLAUDE.md 这样的项目全局规范文件,会在开局时直接原样放进上下文窗口;与此同时,glob 和 grep 等底层原语工具则允许它实时在环境中导航并按需读取具体文件,从而干净利落地绕开了传统向量索引容易过期失效(stale indexing)以及维护复杂语法树(AST)的工程泥潭。
对于内容动态变化较少的场景(例如法律文书审查或金融财务分析),混合策略往往尤为契合。随着模型能力持续提升,Agent 架构设计的总体趋势,必然是「让聪明的模型自己做聪明的决策」,逐步减少人为的强行干预与静态筛选。鉴于整个领域日新月异的演进速度,「采用能跑通的最简方案(do the simplest thing that works)」,依然是我们给所有基于 Claude 构建 Agent 的团队最真诚的建议。
面向长程任务的上下文工程(Context engineering for long-horizon tasks)
长程任务(Long-horizon tasks)要求 Agent 在跨越多轮动作序列、且累计产生的 Token 总量远超模型单次上下文窗口上限的情况下,依然保持逻辑连贯、上下文不丢以及目标导向的行为。对于那些需要连续运转数十分钟乃至数小时的任务——例如大型代码库迁移或全面深入的调研项目——Agent 必须借助专门的上下文技术,才能突破上下文窗口的容量天花板。
干等着模型厂商推出更大的上下文窗口,乍听起来像是一个省事的办法。但在可预见的未来,无论上下文窗口扩充到多大,只要你追求最顶尖的 Agent 表现,就依然逃不开上下文污染(context pollution)与信息相关度稀释的困扰。为了让 Agent 能够在超长的时间跨度上持续稳定发挥,我们打磨出了几种正面解决上下文污染约束的核心技术:上下文压缩(Compaction)、结构化笔记(Structured Note-taking)以及多 Agent 架构(Multi-agent Architectures)。
1. 上下文压缩(Compaction)
上下文压缩,是指当一段对话即将触及上下文窗口上限时,将其内容提炼总结为摘要,并用这份摘要重新开启一个全新上下文窗口的做法。在上下文工程中,压缩通常是用来保障长程连贯性的第一道杠杆。它的核心作用是以高保真(high-fidelity)的方式蒸馏上下文窗口中的信息,让 Agent 能够在几乎不损失性能的前提下继续往下推进。
以 Claude Code 为例,我们在实现这一机制时,会将消息历史传给模型,让它总结并压缩其中最关键的细节。模型会完整保留架构决策、尚未解决的 Bug 以及核心实现细节,同时丢弃冗余的工具输出或寒暄消息。随后,Agent 就可以带着这份浓缩后的上下文,加上最近访问过的 5 个文件继续干活。用户能够获得丝滑连贯的协作体验,而完全不必为上下文窗口见底而操心。
上下文压缩的艺术,全在于抉择「留什么」与「扔什么」——因为过于激进的压缩,很容易把那些当下看似不起眼、直到后面才显露出关键作用的微妙上下文给抹掉。对于正在自行实现压缩系统的工程师,我们建议在复杂的真实 Agent 运行轨迹(traces)上仔细调优你的压缩提示词:
- 第一步先追求高召回率(Maximize Recall):确保你的压缩提示词能够把运行轨迹中每一条相关信息都完整捕捉下来,不漏掉关键线索;
- 第二步再迭代提升精确率(Improve Precision):逐步剔除画蛇添足的冗余内容,把摘要打磨得更加精炼。
在冗余内容中,最容易摘除的「低垂果实」就是清理历史工具调用及其返回结果(Tool Result Clearing)——试想,当某次工具调用已经沉淀在消息历史的深处时,Agent 为什么还需要反复看到那一大坨原始返回结果呢?清理历史工具返回结果,正是目前最安全、侵入性最低的一种轻量级压缩形式,我们也已在 Claude 开发者平台上将其作为一项官方上下文管理功能正式推出。
2. 结构化笔记(Structured note-taking)
结构化笔记(又称 Agent 记忆 / Agentic Memory),是指让 Agent 定期将关键信息写成笔记,持久化保存在上下文窗口之外的存储中;到了后续需要的时刻,再把这些笔记重新拉回上下文窗口的技术。
这一策略能以极低的开销提供跨会话的持久记忆。就像 Claude Code 会自动维护一份待办清单(To-do list),或者你让自定义 Agent 持续维护一份 NOTES.md 文件(以及我们在《为长时间运行的 Agent 构建高效 Harness》中详细介绍的 claude-progress.txt 与 feature_list.json)一样,这个简单的模式能让 Agent 在复杂任务中稳稳追踪整体进度,把那些原本会在几十次工具调用后被冲刷殆尽的关键上下文与依赖关系牢牢锁住。
Claude 玩宝可梦(Claude playing Pokémon)的直播实验,生动展示了外部记忆在非编程领域如何彻底蜕变 Agent 的能力边界。在跨越数千步的游戏进程中,Agent 能够维持精确的计数与目标追踪——比如清晰记录下「在过去的 1,234 步里,我一直在 1 号道路训练宝可梦,皮卡丘已经升了 8 级,距离升满 10 级的目标还差 2 级」。在没有任何人为提示词规定记忆结构的情况下,它自己画出了已探索区域的地图、记住了哪些关键成就已经解锁,并维护着一份对战策略笔记,不断总结哪些招式对付哪些对手最管用。
每当上下文重置(context reset)之后,Agent 都会先读取自己留下的笔记,然后无缝接续长达数小时的练级序列或迷宫探索。这种跨越多次摘要与重置依然保持连贯的能力,让原本单靠大语言模型自身上下文窗口根本不可能完成的长周期战略成为现实。
作为 Sonnet 4.5 发布的一部分,我们在 Claude 开发者平台上推出了公开测试版的记忆工具(Memory Tool),让开发者能够更轻松地通过基于文件系统的机制,在上下文窗口之外存储并查阅信息。这使 Agent 能够随时间推移逐步积累起自己的知识库、跨会话保持项目状态,并在无需把所有历史都塞进上下文的前提下随时调阅过往的工作成果。
3. 子 Agent 架构(Sub-agent architectures)
子 Agent 架构为绕开上下文限制提供了另一条强力路径。与其让单个 Agent 苦苦支撑、试图独自维护横跨整个大项目的全部状态,不如拆分出多个专精的子 Agent(Sub-agents),让它们各自带着干净独立的上下文窗口去攻克聚焦的子任务。主 Agent(Main / Lead Agent)负责统筹高层规划,而各个子 Agent 则深入执行具体的技术工作,或调用工具去搜寻相关信息。每一个子 Agent 在深入探索时可能会消耗数万乃至更多的 Token,但最终交回给主 Agent 的,只是一份经过高度浓缩提炼的工作成果摘要(通常只有 1,000 到 2,000 个 Token)。
这种架构实现了清晰的关注点分离(Separation of Concerns):繁杂琐碎的搜索与试错上下文被严格隔离在各个子 Agent 内部,而主 Agent 则可以全身心聚焦于综合分析与全局决策。我们在《我们如何构建多 Agent 研究系统(How we built our multi-agent research system)》中详细拆解过这一模式,它在复杂深度研究任务上的表现大幅超越了单 Agent 系统(如果你想在日常使用 Claude Code 时立刻用上这一模式,可以直接阅读本课程的《Sub-agents:任务拆解与多角色协作》章节)。
在实际工程中,这三种长程策略该如何选择,取决于任务本身的特征:
- 上下文压缩(Compaction):最适合需要大量你来我往、保持对话流自然连贯的交互式任务;
- 结构化笔记(Note-taking):在里程碑清晰、需要步步为营推进的迭代式开发任务中表现尤为出色;
- 多 Agent 架构(Multi-agent architectures):则擅长应对那些可以通过并行探索获得巨大收益的复杂调研与综合分析任务。
即便底层模型的能力还在持续进化,如何在长周期交互中始终维持逻辑与状态的连贯性,依然会是构建更高效 Agent 的核心命题。
总结(Conclusion)
上下文工程,标志着我们使用大语言模型构建系统的方式发生了一次根本性范式转移。随着模型能力越来越强,核心挑战早已不再是雕琢出一句完美无瑕的提示词,而是在模型每走一步时,深思熟虑地策展「哪些信息值得进入它那有限的注意力预算」。无论你是在为长程任务实现上下文压缩、设计高 Token 效率的工具,还是让 Agent 按需即时探索外部环境,背后遵循的北极星原则始终如一:找到尽可能小的一组高信号 Token 集合,以最大化达成预期结果的概率。
随着模型不断迭代,我们在本文中梳理的这些具体技术还会继续演进。我们已经看到,更聪明的模型需要的死板预设工程越来越少,Agent 能够以更高的自主度独立运转。但无论模型的能力边界如何扩张,把上下文视为一种珍贵且有限的资源,仍将是构建可靠、高效 AI Agent 最核心的工程根基。
你今天就可以在 Claude 开发者平台上开始实践上下文工程,并通过我们的记忆与上下文管理实战手册(Cookbook)获取更多实用技巧与最佳实践。
作者与致谢(Authors & acknowledgements)
本文由 Anthropic 应用 AI(Applied AI)团队撰写:Prithvi Rajasekaran、Ethan Dixon、Carly Ryan 与 Jeremy Hadfield,团队成员 Rafi Ayub、Hannah Moran、Cal Rueb 及 Connor Jennings 亦有贡献。特别感谢 Molly Vorwerck、Stuart Ritchie 与 Maggie Vo 提供的支持。