优秀的 Skill 往往具备三个特征:内容精炼、结构清晰,并且经过真实使用场景的检验。这份指南整理了一套实用的编写决策,帮助你写出能够被 Claude 准确发现并高效执行的 Skill。
如果你想先了解 Skill 的基本概念与运行原理,可以先阅读官方文档中的 Agent Skills 概览。
核心原则
简洁是关键
上下文窗口(Context Window)是一种公共资源。你编写的 Skill 需要与 Claude 运行所需的其他所有内容共享同一个上下文窗口,其中包括:
- 系统提示词(System Prompt)
- 对话历史记录
- 其他所有 Skill 的元数据(Metadata)
- 用户当前的实际请求
并非 Skill 中的每一个 Token 都会立即产生成本。在启动时,系统只会预加载所有 Skill 的元数据(即 name 和 description)。只有当某个 Skill 与当前任务相关时,Claude 才会去读取它的 SKILL.md;也只有在实际需要时,才会进一步读取目录里的其他附加文件。即便如此,保持 SKILL.md 的简洁依然至关重要:一旦 Claude 加载了这份文件,里面的每一个 Token 都会与对话历史和其他上下文争夺宝贵的空间。
默认假设:Claude 已经足够聪明
只补充 Claude 原本不掌握的上下文信息。在写下每一段话之前,都可以先用这三个问题审视一遍:
- “Claude 真的需要这段解释吗?”
- “我能不能直接默认 Claude 已经懂这个概念?”
- “这一段内容带来的价值,配得上它消耗的 Token 成本吗?”
正例:简洁明了(约 50 个 Token):
## 提取 PDF 文本

使用 pdfplumber 提取文本:

```python
import pdfplumber

with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```
反例:过于啰嗦(约 150 个 Token):
## 提取 PDF 文本

PDF(便携式文档格式)是一种常见的文件格式,其中包含文本、图像和其他内容。
要从 PDF 中提取文本,你需要使用一个库。市面上有许多可用于 PDF 处理的库,
但推荐使用 pdfplumber,因为它易于使用且能很好地处理大多数情况。
首先,你需要使用 pip 安装它,然后可以使用下面的代码……
简洁版本直接默认 Claude 已经知道什么是 PDF、也知道怎么调用 Python 库,无需再做科普。
设定恰当的自由度
指令的具体程度,应当与任务的**脆弱程度(Fragility)和可变性(Variability)**相匹配。
高自由度(纯文本启发式指令):
适用场景:
- 有多种方案都能达成目标
- 具体决策高度依赖当时的上下文
- 只需要提供方向性的判断原则
示例:
## 代码审查流程

1. 分析代码结构与模块组织方式
2. 检查潜在的 Bug 或边界情况
3. 提出提升可读性与可维护性的改进建议
4. 验证代码是否符合项目既定规范
中等自由度(伪代码或带可调参数的脚本):
适用场景:
- 存在推荐的标准模式
- 允许根据情况做一定程度的调整
- 可通过配置参数改变行为
示例:
## 生成报告

使用以下模板,并根据需要自定义参数:

```python
def generate_report(data, format="markdown", include_charts=True):
    # 处理数据
    # 按指定格式生成输出
    # 可选包含可视化图表
```
低自由度(固定脚本,几乎没有或完全不带可变参数):
适用场景:
- 操作非常脆弱、稍有偏差就容易出错
- 对执行一致性要求极高
- 必须严格按照特定顺序执行
示例:
## 数据库迁移

严格运行以下脚本:

```bash
python scripts/migrate.py --verify --backup
```

请勿修改命令或擅自添加额外参数。
一个直观的类比: 可以把 Claude 想象成一个正在探路的机器人:
- 两侧都是悬崖的独木桥: 安全前进的路只有一条。这时必须提供明确的护栏和精确到字面的指令(低自由度)。例如:必须严格按顺序执行的数据库迁移。
- 没有任何障碍的开阔草地: 条条大路都能通向终点。这时只需给出大致方向,放手让 Claude 自己寻找最佳路线(高自由度)。例如:需要结合具体上下文综合判断的代码审查。

在你计划使用的所有模型上测试
Skill 是对底层模型能力的补充,因此它的实际效果很大程度上取决于底层模型本身。请务必在你计划搭配使用的所有模型上测试你的 Skill。
不同模型的测试关注点:
- Claude Haiku(快速、经济):Skill 提供的引导细节是否足够充分?
- Claude Sonnet(均衡主力):Skill 的指令是否清晰且执行高效?
- Claude Opus(强推理能力):Skill 是否做到了点到为止、避免过度解释?
对 Opus 来说刚刚好的简练指令,交给 Haiku 执行时可能会因为缺少细节而卡壳。如果你的 Skill 需要在多款模型之间通用,请尽量寻找一套在各个模型上都能稳定发挥的指令平衡点。
Skill 的结构设计
YAML 前置元数据(Frontmatter):
SKILL.md顶部的 Frontmatter 必须包含以下两个字段:
name:最多 64 个字符;只能包含小写字母、数字和连字符(-);不能包含 XML 标签;不能包含保留字"anthropic"或"claude"。description:必须非空;最多 1,024 个字符;不能包含 XML 标签;应当同时说明该 Skill 的功能是什么以及什么时候应该使用它。关于 Skill 目录结构的完整说明,请参阅概览文档中的 Skill 结构。
命名约定
使用一致的命名规范,能让 Skill 在文档和对话中更容易被引用与检索。建议使用动名词形式(动词 -ing + 名词)来为 Skill 命名,这样能一眼看出它提供的活动或能力。
请注意,name 字段仅允许使用小写字母、数字和连字符。
推荐命名示例(动名词形式):
processing-pdfsanalyzing-spreadsheetsmanaging-databasestesting-codewriting-documentation
可接受的替代命名方式:
- 名词短语:
pdf-processing、spreadsheet-analysis - 动作导向:
process-pdfs、analyze-spreadsheets
应当避免的命名:
- 含义模糊:
helper、utils、tools - 过于宽泛:
documents、data、files - 包含保留字:
anthropic-helper、claude-tools - 在同一个 Skill 库中混用不一致的命名风格
保持命名一致可以让以下事情变得更轻松:
- 在文档与日常对话中准确引用某个 Skill
- 仅凭名字就能看懂 Skill 的用途
- 整理和检索多个 Skill
- 维护一套专业、统一的 Skill 资产库
编写高效的 description
description 字段决定了 Skill 能否被模型准确发现,因此必须同时写清楚它能做什么以及在什么时机触发它。
警告:请始终使用第三人称编写描述。
description会被直接注入到系统提示词中,如果人称视角混乱(比如出现“我”或“你”),可能会干扰模型的路由与发现机制。
- 推荐:
"Processes Excel files and generates reports"(处理 Excel 文件并生成报告)- 避免:
"I can help you process Excel files"(我可以帮你处理 Excel 文件)- 避免:
"You can use this to process Excel files"(你可以用它来处理 Excel 文件)
描述要具体,并包含关键触发词。 既要说明 Skill 的核心能力,也要写明触发它的具体场景或用户关键词。
每个 Skill 只有一个 description 字段。它在 Skill 选择阶段起着决定性作用:Claude 正是靠这段描述,从潜在的上百个可用 Skill 中挑出最匹配的那一个。因此,description 必须提供足够明确的线索让 Claude 判断何时选中它,而具体的执行细节则留给 SKILL.md 的正文去展开。
优秀的描述示例:
PDF 处理 Skill:
description: Extract text and tables from PDF files, fill forms, merge documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
# 中文对应写法:
description: 从 PDF 文件中提取文本和表格、填写表单、合并文档。当处理 PDF 文件,或用户提到 PDF、表单、文档提取时使用。
Excel 分析 Skill:
description: Analyze Excel spreadsheets, create pivot tables, generate charts. Use when analyzing Excel files, spreadsheets, tabular data, or .xlsx files.
# 中文对应写法:
description: 分析 Excel 电子表格、创建数据透视表、生成图表。当分析 Excel 文件、电子表格、表格数据或 .xlsx 文件时使用。
Git Commit 助手 Skill:
description: Generate descriptive commit messages by analyzing git diffs. Use when the user asks for help writing commit messages or reviewing staged changes.
# 中文对应写法:
description: 通过分析 git diff 生成清晰的提交信息。当用户请求帮忙编写 commit message 或审阅暂存区改动时使用。
请避免像下面这样笼统含糊的描述:
description: Helps with documents
# 中文对应写法:
description: 帮助处理文档
description: Processes data
# 中文对应写法:
description: 处理数据
description: Does stuff with files
# 中文对应写法:
description: 对文件做一些操作
渐进式披露模式(Progressive Disclosure)
SKILL.md 的角色就像一本入职手册的“总目录”,负责提供全局概览,并在需要时把 Claude 指引向更详细的资料文件。关于渐进式披露机制的底层原理,请参阅概览文档中的 Skills 的工作原理。
实操建议:
- 将
SKILL.md的正文控制在 500 行以内,以保持最佳性能。 - 当内容接近这一上限时,把详细资料拆分到独立的文件中。
- 使用下面几种常见模式来组织你的指令、代码与参考资源。
可视化总览:从简单到复杂
一个最基础的 Skill 只需要一个包含元数据与指令正文的 SKILL.md 文件:
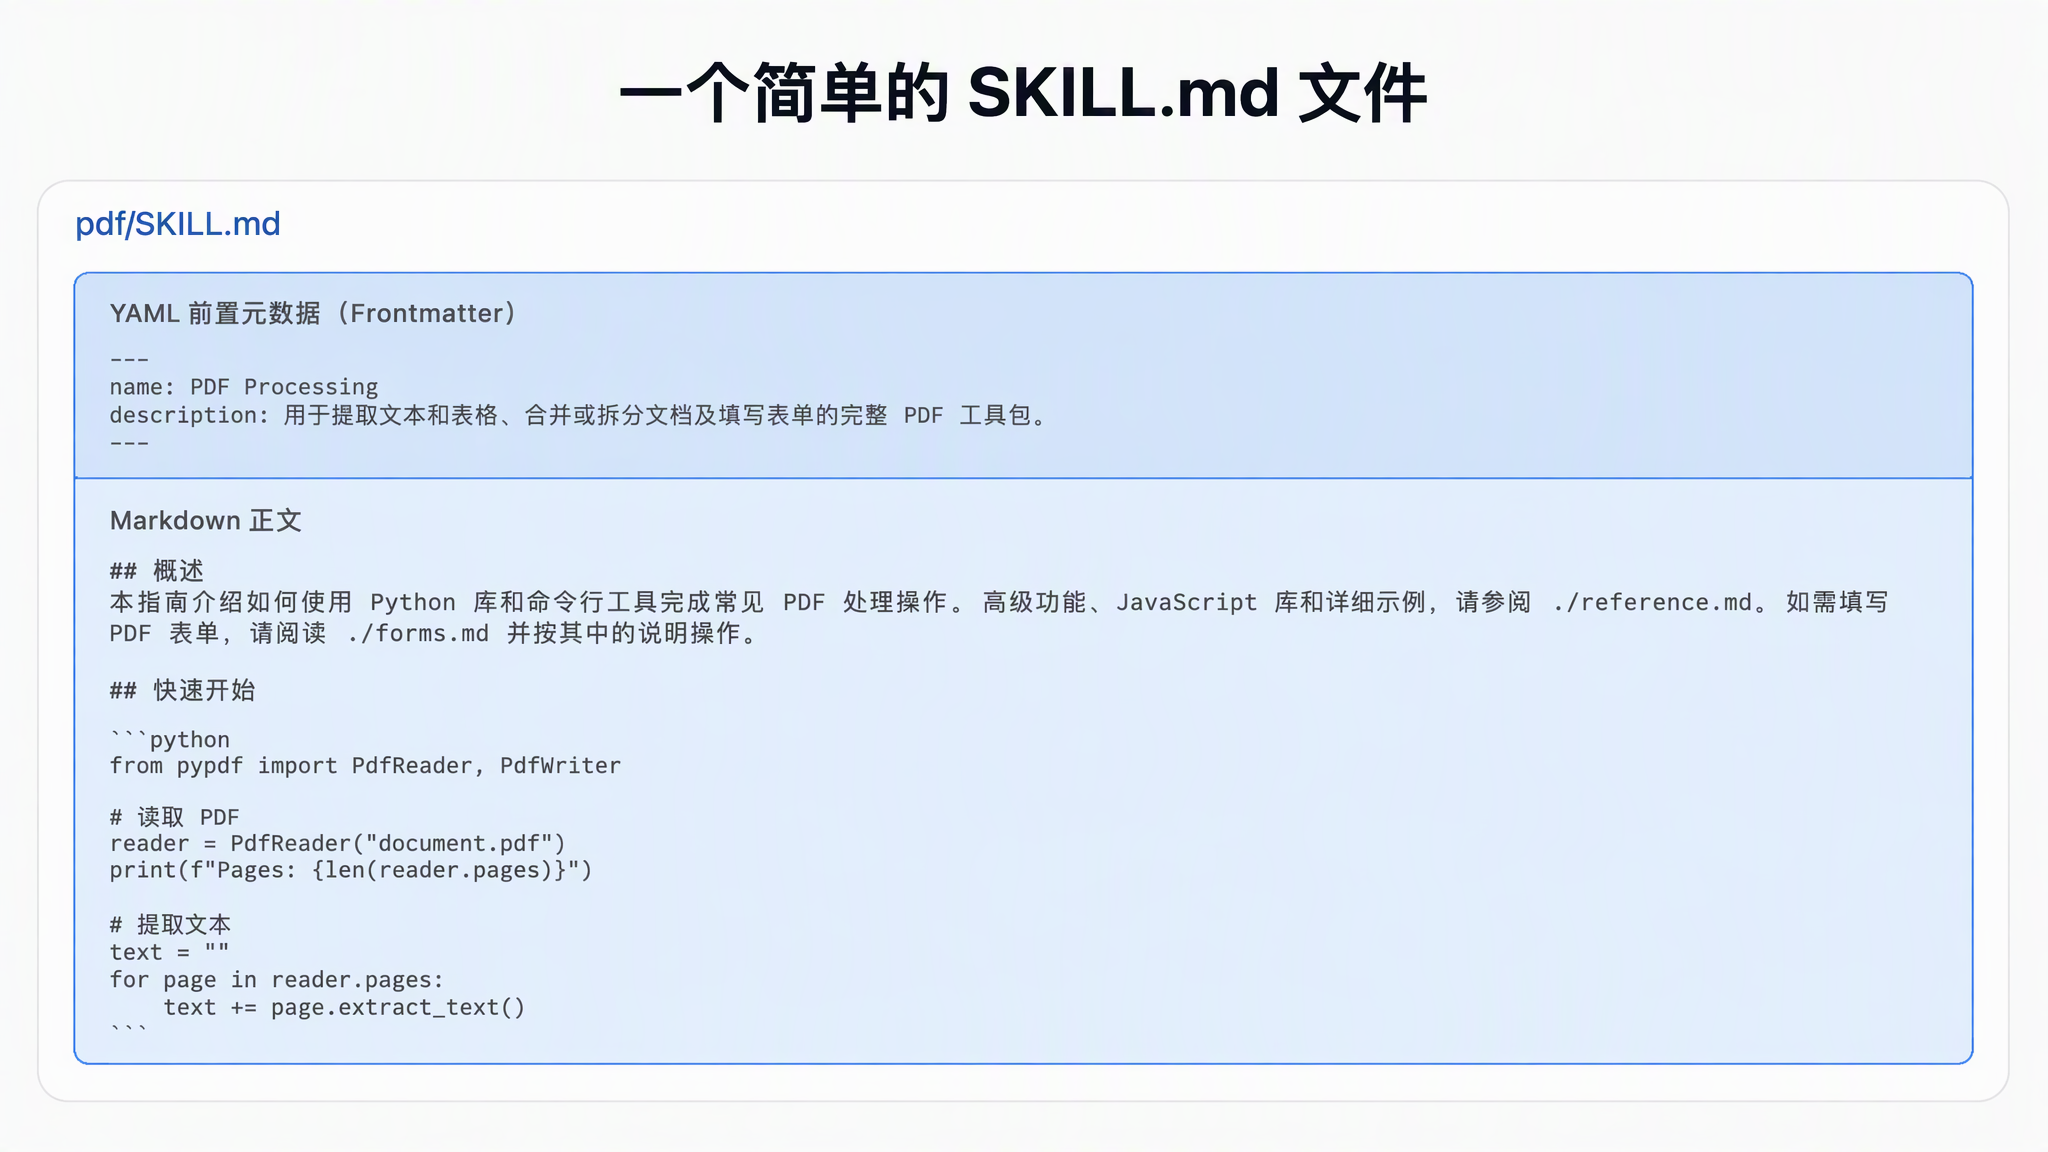
随着 Skill 承载的内容越来越多,你可以把扩展资料打包进同一目录下,让 Claude 仅在需要时按需加载:
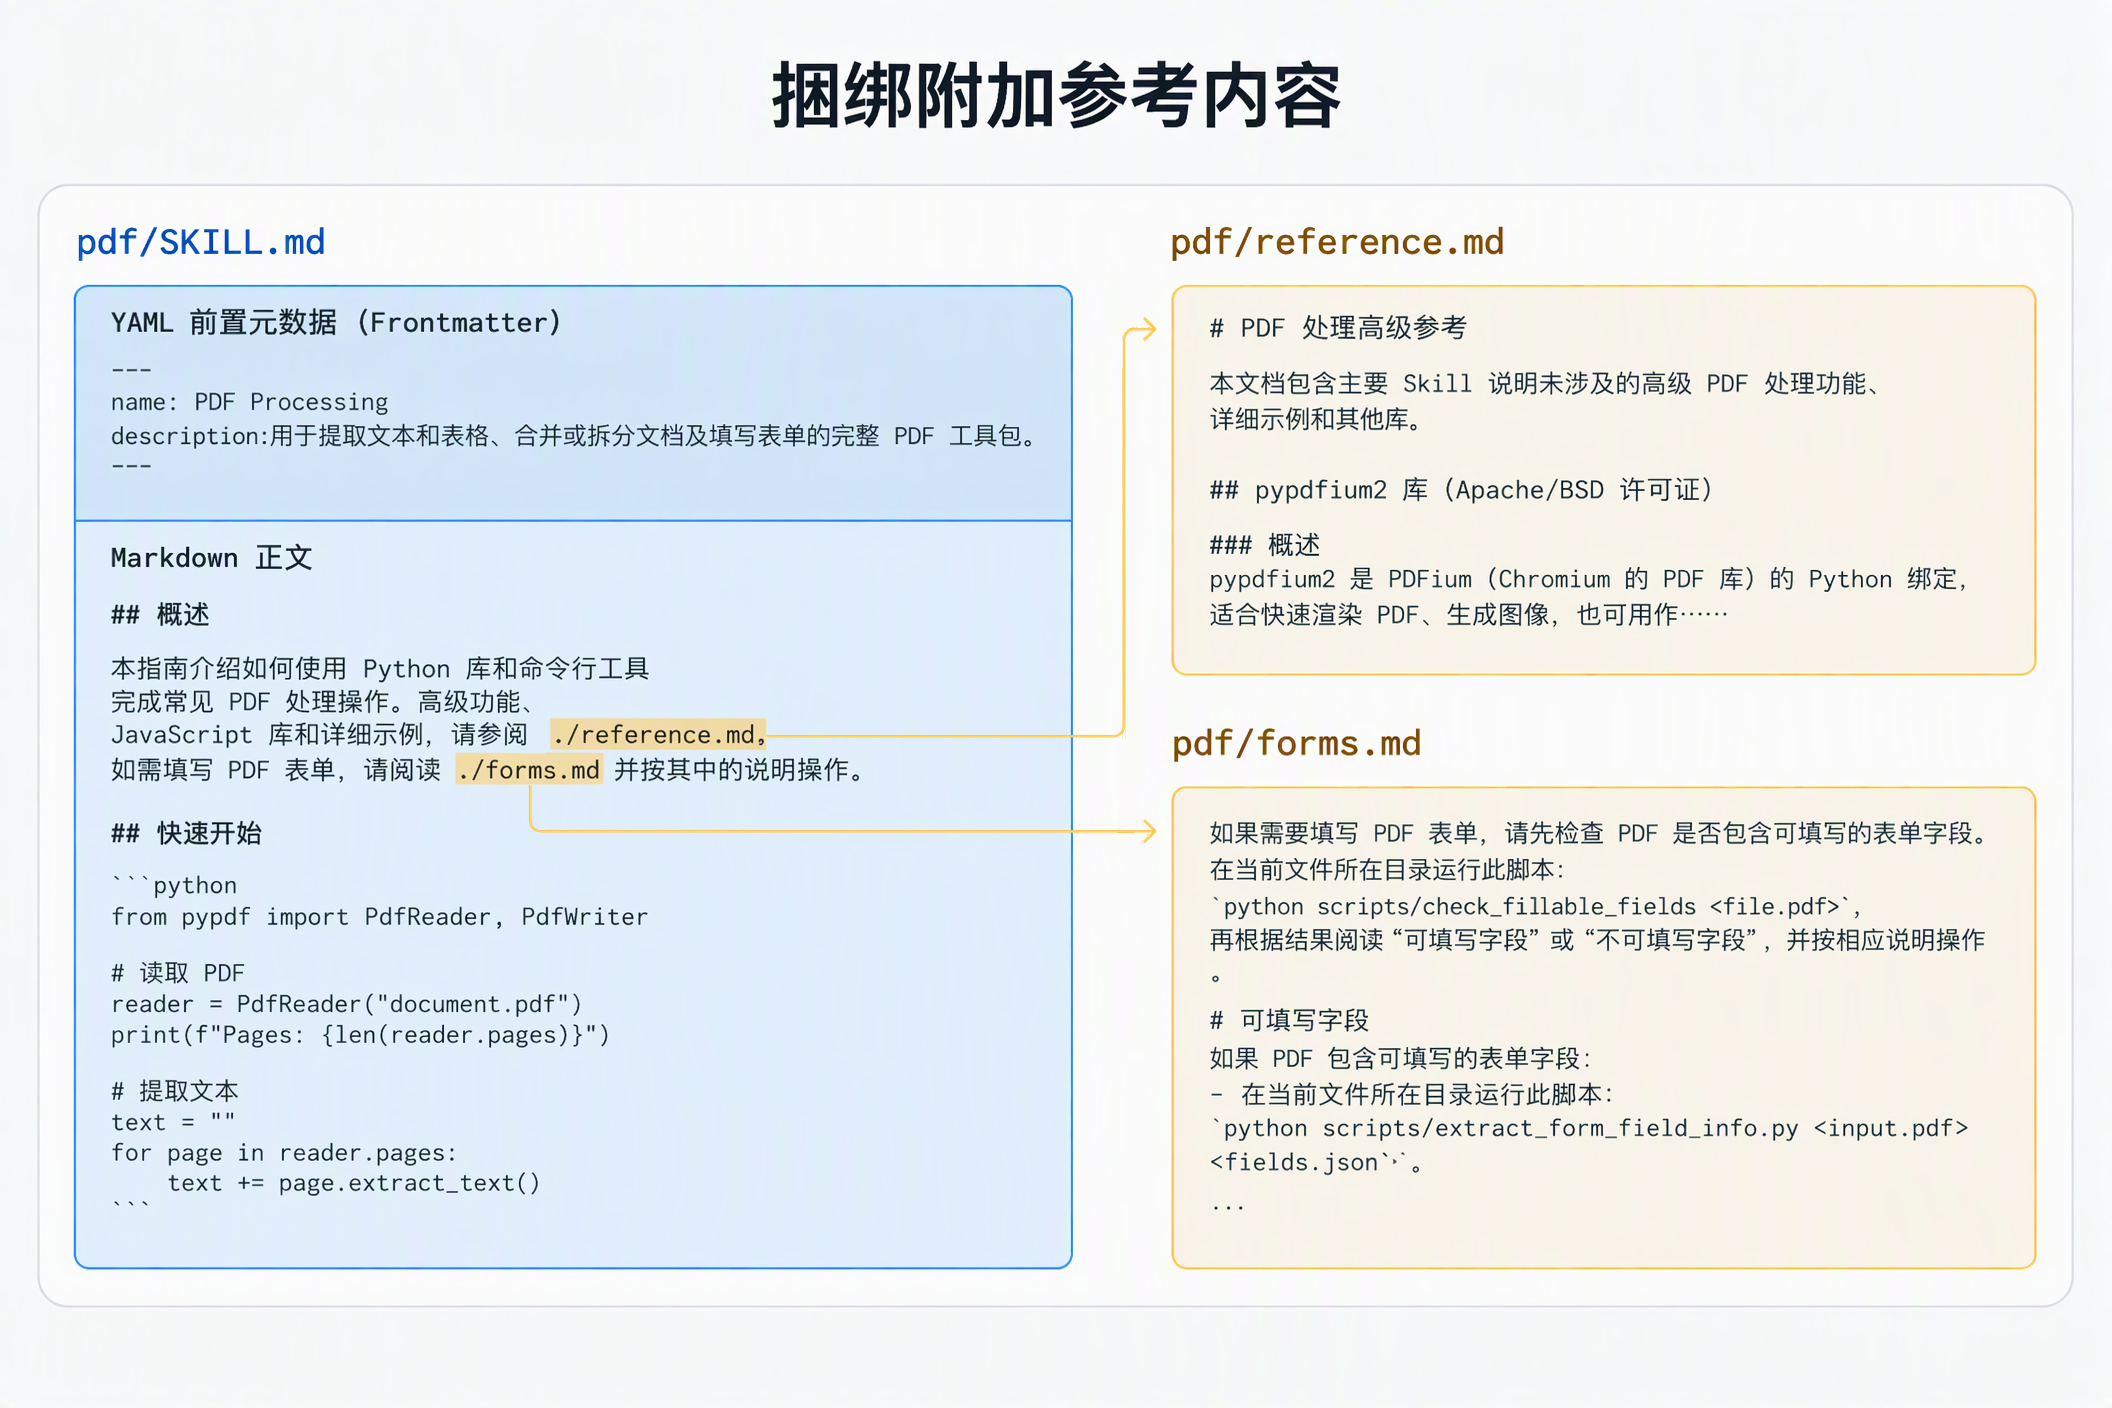
一个完整的 Skill 目录结构通常长这样:
pdf/SKILL.md:核心主指令(触发 Skill 时加载)FORMS.md:表单填写指南(按需加载)reference.md:API 参考手册(按需加载)examples.md:使用示例集合(按需加载)scripts/analyze_form.py:实用工具脚本(直接运行,不加载进上下文)fill_form.py:表单填写脚本validate.py:校验脚本
模式 1:高层指南 + 独立参考文件
---
name: pdf-processing
description: Extracts text and tables from PDF files, fills forms, and merges documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
# 中文对应写法:
# description: 从 PDF 文件中提取文本和表格、填写表单并合并文档。当处理 PDF 文件,或用户提到 PDF、表单、文档提取时使用。
---

# PDF 处理

## 快速开始

使用 pdfplumber 提取文本:
```python
import pdfplumber
with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```

## 高级功能

**表单填写**:完整指南请参阅 [FORMS.md](FORMS.md)
**API 参考**:全部方法说明请参阅 [REFERENCE.md](REFERENCE.md)
**使用示例**:常见模式请参阅 [EXAMPLES.md](EXAMPLES.md)
这样一来,Claude 只有在真正用到对应功能时,才会去读取 FORMS.md、REFERENCE.md 或 EXAMPLES.md。
模式 2:按业务领域拆分目录
如果一个 Skill 横跨多个业务领域,建议按领域拆分参考文件,避免一次性加载无关的上下文。例如,当用户询问销售指标时,Claude 只需要读取销售相关的表结构说明,完全没必要把财务或营销的数据字典也塞进上下文里。这既能节省 Token,又能让模型的注意力保持聚焦。
bigquery-skill/SKILL.md(全局概览与导航索引)reference/finance.md(营收、计费指标)sales.md(商机、销售漏斗)product.md(API 调用量、功能使用率)marketing.md(营销活动、归因数据)
# BigQuery 数据分析

## 可用数据集

**财务(Finance)**:营收、ARR、计费数据 → 参阅 [reference/finance.md](reference/finance.md)
**销售(Sales)**:商机、销售管道、客户账户 → 参阅 [reference/sales.md](reference/sales.md)
**产品(Product)**:API 使用情况、功能渗透率 → 参阅 [reference/product.md](reference/product.md)
**营销(Marketing)**:营销活动、归因分析、邮件数据 → 参阅 [reference/marketing.md](reference/marketing.md)

## 快速检索

使用 grep 查找特定指标:

```bash
grep -i "revenue" reference/finance.md
grep -i "pipeline" reference/sales.md
grep -i "api usage" reference/product.md

# 中文关键词检索对应写法:
grep -i "营收" reference/finance.md
grep -i "销售漏斗" reference/sales.md
grep -i "API 调用量" reference/product.md
```
模式 3:按条件按需展开细节
在主文件里只展示最基础的通用做法,把特定条件下的复杂处理链接到外部文件:
# DOCX 文档处理

## 创建新文档

使用 docx-js 创建新文档,详见 [DOCX-JS.md](DOCX-JS.md)。

## 编辑现有文档

对于简单修改,直接修改底层 XML 即可。

**如需保留修订痕迹(Tracked Changes)**:参阅 [REDLINING.md](REDLINING.md)
**如需了解 OOXML 规范细节**:参阅 [OOXML.md](OOXML.md)
只有当用户的任务确实涉及修订痕迹或底层 OOXML 结构时,Claude 才会去读取 REDLINING.md 或 OOXML.md。
避免深层嵌套的文件引用
当一个参考文件是从另一个参考文件里被二次引用时,Claude 往往不会把最终文件完整读完。遇到多层嵌套引用时,Claude 可能会倾向于用 head -100 之类的命令只预览前几行,从而漏掉关键信息。
请让所有引用距离 SKILL.md 保持在“一层深度”以内。 也就是说,所有参考文件都应该直接挂在 SKILL.md 下,确保 Claude 在需要时能一步到位地完整读取目标文件。
反例:嵌套层级过深:
# SKILL.md
详见 [advanced.md](advanced.md)...

# advanced.md
详见 [details.md](details.md)...

# details.md
这里才是真正需要的核心信息...
正例:保持一层深度:
# SKILL.md

**基础用法**:[直接写在 SKILL.md 中的指令]
**高级功能**:参阅 [advanced.md](advanced.md)
**API 参考**:参阅 [reference.md](reference.md)
**代码示例**:参阅 [examples.md](examples.md)
为较长的参考文件加上目录
如果某个参考文件超过 100 行,建议在文件开头放一份章节目录(Table of Contents)。这样即便 Claude 先用局部读取的方式预览文件开头,也能一眼看清整份文档涵盖了哪些内容,随后再决定是通读全文还是精准跳转到特定小节。
示例:
# API 参考手册

## 目录
- 认证与初始化配置
- 核心方法(创建、读取、更新、删除)
- 高级特性(批量操作、Webhooks)
- 错误处理模式
- 代码示例

## 认证与初始化配置
...

## 核心方法
...
关于这种基于文件系统的架构是如何支撑渐进式披露的,可以跳到本文后半部分的运行时环境小节查看详细说明。
工作流与反馈闭环
用分步工作流拆解复杂任务
遇到复杂操作时,请把它拆解成清晰、按顺序执行的步骤。对于步骤繁多的长流程,可以在指令里提供一份 Checklist(检查清单),让 Claude 先把清单复制到回复里,每做完一步就勾选一步。
示例 1:多源研究综述工作流(适用于不含代码的纯分析类 Skill):
## 研究综述工作流

复制以下检查清单并跟踪执行进度:

```
Research Progress:
- [ ] Step 1: 阅读所有源文档
- [ ] Step 2: 提炼核心主题
- [ ] Step 3: 交叉核对各方论点
- [ ] Step 4: 撰写结构化综述
- [ ] Step 5: 核查引文出处
```

**Step 1: 阅读所有源文档**

审阅 `sources/` 目录下的每一份文档,记录核心论点与支撑证据。

**Step 2: 提炼核心主题**

寻找不同资料之间的共性模式:哪些主题反复出现?各个信源在哪些地方达成共识,又在哪些地方存在分歧?

**Step 3: 交叉核对各方论点**

针对每一项主要结论,核实它在原始材料中的出处,并标注支撑该观点的具体文档。

**Step 4: 撰写结构化综述**

按主题组织研究发现,每个主题需包含:
- 核心论点
- 来自源文档的支撑证据
- 存在冲突的观点(如有)

**Step 5: 核查引文出处**

检查每一条结论是否都准确引用了对应的源文档。如果引文不完整,请退回 Step 3 补全。
这个例子展示了如何把工作流模式应用在完全不需要写代码的分析任务上。Checklist 模式几乎适用于任何复杂的多步骤流程。
示例 2:PDF 表单填写工作流(适用于包含可执行代码的 Skill):
## PDF 表单填写工作流

复制以下检查清单,每完成一步就勾选对应项:

```
Task Progress:
- [ ] Step 1: 分析表单结构(运行 analyze_form.py)
- [ ] Step 2: 建立字段映射(编辑 fields.json)
- [ ] Step 3: 校验字段映射(运行 validate_fields.py)
- [ ] Step 4: 填写表单内容(运行 fill_form.py)
- [ ] Step 5: 验证输出结果(运行 verify_output.py)
```

**Step 1: 分析表单结构**

运行:`python scripts/analyze_form.py input.pdf`

该脚本会提取表单字段及其坐标位置,并保存至 `fields.json`。

**Step 2: 建立字段映射**

编辑 `fields.json`,为每个字段填入对应的值。

**Step 3: 校验字段映射**

运行:`python scripts/validate_fields.py fields.json`

在继续下一步之前,必须先修复所有校验报错。

**Step 4: 填写表单内容**

运行:`python scripts/fill_form.py input.pdf fields.json output.pdf`

**Step 5: 验证输出结果**

运行:`python scripts/verify_output.py output.pdf`

如果验证未通过,请退回 Step 2 重新修正。
明确的步骤划分能防止 Claude 跳步或漏掉关键的校验环节;同时,Checklist 也能帮助 Claude 和你随时掌握多步骤任务的当前进度。
建立反馈闭环(Feedback Loops)
高频高杠杆模式: 运行验证器(Validator) → 修复错误 → 重新验证,直到通过为止。
这一模式能显著提升最终输出的质量与稳定性。
示例 1:文风规范合规检查(适用于不含代码的 Skill):
## 内容审校流程

1. 按照 STYLE_GUIDE.md 中的规范起草文稿
2. 对照检查清单逐项自检:
   - 检查术语前后是否一致
   - 确认示例符合标准格式
   - 确认所有必填章节均已包含
3. 如果发现问题:
   - 记录每一处问题及其所在的具体章节
   - 修改文稿内容
   - 重新对照检查清单复核一遍
4. 只有当所有要求全部满足时,才允许进入下一步
5. 定稿并保存文档
这里展示的是用参考文档代替代码脚本的验证闭环。“验证器”就是 STYLE_GUIDE.md,Claude 通过读取规范并逐条比对来完成自检。
示例 2:文档修改与打包流程(适用于包含代码的 Skill):
## 文档编辑流程

1. 修改 `word/document.xml` 中的内容
2. **立即执行校验**:`python ooxml/scripts/validate.py unpacked_dir/`
3. 如果校验失败:
   - 仔细阅读报错信息
   - 修复 XML 中的问题
   - 重新运行校验脚本
4. **只有当校验完全通过后,才允许继续下一步**
5. 重新打包:`python ooxml/scripts/pack.py unpacked_dir/ output.docx`
6. 测试最终生成的文档
校验闭环能把错误拦截在早期阶段,避免带着错误往下跑。
内容编写准则
避免写入带时效性的信息
不要在 Skill 里写随着时间推移会自动过期作废的判断:
反例:包含时效性条件(过段时间就会变成错误指令):
如果你在 2025 年 8 月之前执行此操作,请使用旧版 API。
2025 年 8 月之后,请使用新版 API。
正例(使用专门的“旧版废弃模式”小节归档):
## 当前标准做法

使用 v2 API 端点:`api.example.com/v2/messages`

## 旧版废弃模式(Legacy Patterns)

旧版 v1 API(已于 2025-08 废弃)曾使用:`api.example.com/v1/messages`。
该端点现已停止支持,请勿在新代码中使用。
把历史兼容信息单独归档到“旧版模式”小节,既保留了必要的背景上下文,又不会干扰主干指令的清晰度。
全文保持术语一致
同一个概念只选定一个固定词,并在整个 Skill 中贯彻到底:
正例——术语统一:
- 始终使用
"API endpoint" - 始终使用
"field" - 始终使用
"extract"
反例——混用同义词:
- 一会儿写
"API endpoint",一会儿又换成"URL"、"API route"、"path" - 混用
"field"、"box"、"element"、"control" - 混用
"extract"、"pull"、"get"、"retrieve"
术语高度一致,有助于 Claude 更准确地解析并严格执行你的指令。
常见指令设计模式
模板模式(Template Pattern)
为期望的输出格式提供现成模板,并根据业务要求决定模板的严格程度。
针对严格格式要求(例如 API 响应结构或固定数据格式):
## 报告结构

请务必严格使用以下模板结构,切勿增删章节:

```markdown
# [分析报告标题]

## 执行摘要
[用一段话概括核心结论]

## 核心发现
- 发现 1(附支撑数据)
- 发现 2(附支撑数据)
- 发现 3(附支撑数据)

## 行动建议
1. 具体可落地的建议
2. 具体可落地的建议
```
针对灵活引导场景(允许模型根据实际情况动态调整):
## 报告结构

以下是推荐的默认格式,但你可以根据具体分析内容灵活调整:

```markdown
# [分析报告标题]

## 执行摘要
[整体概述]

## 核心发现
[根据实际发现自由组织小节]

## 行动建议
[结合具体业务上下文给出针对性建议]
```

请根据具体的分析类型按需调整章节结构。
少样本示例模式(Examples Pattern)
如果某项任务的输出质量高度依赖对风格与尺度的把握,可以像常规写 Prompt 一样,直接在 Skill 里提供成对的输入/输出示例(Few-shot Examples):
## Commit Message 格式规范

请参照以下示例的风格生成 Git 提交信息:

**示例 1:**
输入:新增基于 JWT Token 的用户认证功能
输出:
```text
feat(auth): implement JWT-based authentication

Add login endpoint and token validation middleware

# 中文对应写法:
feat(auth): 实现基于 JWT 的用户认证

新增登录接口与 Token 校验中间件
```

**示例 2:**
输入:修复报表中日期显示不正确的 Bug
输出:
```text
fix(reports): correct date formatting in timezone conversion

Use UTC timestamps consistently across report generation

# 中文对应写法:
fix(reports): 修复时区转换中的日期格式错误

在报表生成流程中统一使用 UTC 时间戳
```

**示例 3:**
输入:升级依赖包并重构错误处理逻辑
输出:
```text
chore: update dependencies and refactor error handling

- Upgrade lodash to 4.17.21
- Standardize error response format across endpoints

# 中文对应写法:
chore: 升级依赖包并重构错误处理逻辑

- 将 lodash 升级至 4.17.21
- 统一各接口的错误响应格式
```

请遵循这一格式风格:`type(scope): 简短摘要`,空一行后写详细说明。
相比单纯用抽象的形容词去描述要求,几组具体的示例能更直观地让 Claude 领会你想要的文风和颗粒度。
条件分支工作流模式(Conditional Workflow Pattern)
当任务存在明显的路径分叉时,明确引导 Claude 先做判断再走对应分支:
## 文档修改工作流

1. 首先判断修改类型:

   **需要从零创建新文档?** → 请执行下方的「创建工作流」
   **需要修改已有的现成文档?** → 请执行下方的「编辑工作流」

2. 创建工作流:
   - 使用 docx-js 库
   - 从零构建文档结构
   - 导出为 .docx 格式

3. 编辑工作流:
   - 解包现有的 .docx 文档
   - 直接修改底层 XML 文件
   - 每次修改后运行校验脚本
   - 全部完成后重新打包成 .docx
提示: 如果某个分支的工作流本身变得非常庞大、步骤繁多,建议把各个分支拆成独立的参考文件,在主文件里只保留分流判断,告诉 Claude 根据当前任务去读取对应的分支文件。
评估与迭代
先建评估,再写长文档
在动笔写大篇幅的 Skill 文档之前,请先建立评估用例(Evaluations)。 这能确保你写出来的 Skill 是在解决真实存在的痛点,而不是凭空想象出来的伪需求。
评估驱动开发(Evaluation-driven Development)五步法:
- 找出能力缺口(Identify gaps): 先在不挂载任何 Skill 的情况下,让 Claude 直接跑几个有代表性的真实任务,记录下它具体在哪里翻车、缺了哪些上下文信息。
- 构建评估用例(Create evaluations): 围绕这些暴露出来的短板,设计 3 个针对性的测试场景。
- 确立基线(Establish baseline): 测量并记录 Claude 在不带 Skill 时的初始表现。
- 编写最小化指令(Write minimal instructions): 只写刚好能补齐上述短板、让评估用例跑通的最少内容。
- 持续迭代(Iterate): 运行评估、对比基线表现,再根据暴露出的新问题逐步打磨。
这套做法能保证你写的每一行指令都打在真实的痛点上,而不是花大量精力去预防那些永远不会发生的情况。
评估用例的数据结构示例:
{
  "skills": ["pdf-processing"],
  "query": "从这份 PDF 文件中提取所有文本,并保存到 output.txt",
  "files": ["test-files/document.pdf"],
  "expected_behavior": [
    "使用合适的 PDF 处理库或命令行工具成功读取 PDF 文件",
    "提取文档中所有页面的文本内容,不遗漏任何页面",
    "将提取出的文本以清晰易读的格式保存至名为 output.txt 的文件中"
  ]
}
注意: 上面的示例展示了一个包含简单评分标准的测试集结构。目前平台尚未内置一键运行这套评估的现成工具,你可以搭建自己的轻量评估脚本。评估用例就是衡量 Skill 是否真正有效的唯一事实来源。
与 Claude 协同迭代开发 Skill
最高效的 Skill 开发方式,就是让 Claude 自己参与到开发闭环里。你可以开启两个独立的 Claude 会话:让其中一个实例(称为 “Claude A”)担任你的指令架构师,帮你设计和打磨 Skill;再开启另一个全新的实例(称为 “Claude B”),挂载写好的 Skill 去跑真实任务。这套双实例配合之所以好用,是因为 Claude 既懂得如何写出对 Agent 友好的指令,又最清楚 Agent 在执行时真正需要什么信息。
从零创建一个新 Skill 的流程:
- 先在不带 Skill 的情况下把任务跑通一遍: 用常规提示词与 Claude A 一起解决一个具体问题。在这个过程中,你会很自然地向它补充背景上下文、解释你的个人偏好、交代操作步骤。留意那些你不得不反复交代的信息。
- 提炼可复用的模式: 任务跑通后,复盘刚才你提供了哪些对未来同类任务同样有用的通用上下文。
- 举例: 如果你刚刚完成了一次 BigQuery 数据分析,你可能向模型提供了表名、字段含义、过滤规则(比如“查询时永远排除测试账号”)以及常用的 SQL 写法。
- 让 Claude A 帮你把经验打包成 Skill: 直接对它说:“请把我们刚才用到的这套 BigQuery 分析模式整理成一个 Skill,把表结构 Schema、命名规范以及排除测试账号的过滤规则都包含进去。”
提示: Claude 模型原生就懂 Skill 的格式与目录规范。你不需要额外配置特殊的系统提示词,也不需要专门装一个“用来写 Skill 的 Skill”,直接开口让 Claude 创建一个 Skill,它就能生成包含标准 YAML Frontmatter 和正文的
SKILL.md。 - 删繁就简,审查简洁性: 检查 Claude A 生成的初稿里有没有塞入多余的常识科普。比如直接告诉它:“把解释什么是胜率(Win Rate)的那段删掉——Claude 本来就知道这个概念。”
- 优化信息架构: 让 Claude A 帮你把文件结构理顺。例如:“把这几张表的 Schema 拆分到单独的参考文件里,方便我们以后继续往里加新表。”
- 在全新实例中做实战测试: 开启一个加载了该 Skill 的全新会话(Claude B),拿几个同类型的真实任务去测。观察 Claude B 能不能顺利找到需要的信息、有没有严格执行过滤规则、最终能否独立把活干漂亮。
- 根据实测表现反馈迭代: 如果 Claude B 在测试中卡壳或漏掉了某条规则,带着具体的观察结果回到 Claude A:“刚才 Claude 用这个 Skill 查 Q4 数据时,忘了按日期过滤。我们是不是应该在文档里专门加一小节讲日期过滤模式?”
迭代优化已有 Skill 的流程:
改进现有 Skill 时,依然沿用这套“专家设计与实测检验分离”的双实例交替循环:
- 与 Claude A 协作(帮你复盘和打磨 Skill 的专家顾问)
- 用 Claude B 实测(挂载 Skill 真正干活的执行 Agent)
- 观察 Claude B 的实际行为,把暴露出的问题带回给 Claude A
- 在真实工作流中使用 Skill: 给加载了 Skill 的 Claude B 派发真实的日常任务,而不是刻意编造的玩具测试题。
- 观察 Claude B 的行为细节: 记录它在哪个环节犹豫不决、哪里执行得很顺,或者在哪里做出了出乎意料的选择。
- 观察记录示例: “当我让 Claude B 拉一份区域销售报表时,它写出了查询语句,却忘了过滤掉测试账户——明明
SKILL.md里已经写过这条规则了。”
- 观察记录示例: “当我让 Claude B 拉一份区域销售报表时,它写出了查询语句,却忘了过滤掉测试账户——明明
- 回到 Claude A 寻求改进方案: 把当前的
SKILL.md贴给 Claude A,并描述你刚才看到的现象:“我发现让 Claude B 出区域报表时,它忘了过滤测试账户。虽然 Skill 里提到了这条规则,是不是放的位置不够显眼?” - 审阅 Claude A 的改进建议: Claude A 可能会建议调整排版结构把核心规则提上来、把温和的
"always filter"改成强制性的"MUST filter",或者直接重构工作流步骤。 - 应用修改并再次验证: 用 Claude A 改好的新版更新 Skill,再找类似的真实请求交给 Claude B 重测。
- 随日常使用持续演进: 每遇到新的业务场景,就重复一次“观察 → 改进 → 测试”的闭环。每一次迭代都建立在 Agent 的真实行为表现之上,而不是靠主观猜测。
收集团队成员的使用反馈:
- 把写好的 Skill 分享给团队同事,观察他们在日常工作中的真实使用情况。
- 收集反馈:Skill 能不能在预期的时机自动激活?指令有没有歧义?还缺哪些常见场景?
- 将团队反馈融合成新的改进点,补齐个人使用习惯之外的盲区。
为什么这套方法最有效: Claude A 懂 Agent 的阅读习惯,你提供核心业务经验,Claude B 用真实实战暴露漏洞,三者配合就能根据可观测的行为持续把 Skill 打磨到最佳状态。

留意 Claude 是如何浏览和寻路的
在迭代打磨 Skill 的过程中,建议重点观察 Claude 在实际执行时是如何探索文件的。尤其要留意以下四个信号:
- 出乎意料的探索路径: Claude 读取文件的顺序是不是和你想的不一样?这往往说明当前的目录结构还不够直观。
- 断掉的引用线索: Claude 是不是没有顺着主文件的链接去读某个重要的参考文件?这说明链接的位置可能不够显眼,或者触发条件写得不够明确。
- 反复读取同一个外部文件: 如果 Claude 在不同任务里总是第一时间跑去读某个附加文件,不妨考虑把那部分高频核心内容直接挪回主文件
SKILL.md里。 - 从来没人碰的冷宫文件: 如果目录下的某个捆绑文件从来没被 Claude 访问过,要么是它根本没必要存在,要么是主指令里缺乏指向它的清晰路标。
请根据这些真实的寻路表现来迭代结构,而不是凭想象设计目录。其中,Skill 元数据里的 name 和 description 尤其关键——Claude 正是靠这两个字段来决定当前任务要不要唤醒这个 Skill。请务必确保它们清晰定义了 Skill 的能力边界与触发时机。
应当规避的反模式(Anti-patterns)
切勿使用 Windows 风格的反斜杠路径
无论在什么操作系统下,文件路径请一律使用正斜杠(/),哪怕在 Windows 上也一样:
- ✓ 正确:
scripts/helper.py、reference/guide.md - ✗ 错误:
scripts\helper.py、reference\guide.md
Unix 风格的正斜杠路径在所有平台上都能正常工作,而 Windows 风格的反斜杠路径在 Unix 容器环境中会直接报错。
避免罗列过多备选方案
除非确有必要,否则不要同时塞给模型好几种可选方案:
**反例:选项太多**(容易让模型纠结和混乱):
“你可以使用 pypdf,或者 pdfplumber,或者 PyMuPDF,或者 pdf2image,或者……”

**正例:直接给出唯一默认方案**(仅在特殊场景下提供逃生通道):
“默认使用 pdfplumber 提取文本:
```python
import pdfplumber
```

如果遇到需要 OCR 识别的扫描版 PDF,请改用 pdf2image 搭配 pytesseract 处理。”
进阶指南:包含可执行代码的 Skill
以下章节专门针对带有可执行脚本的 Skill。如果你的 Skill 只包含纯 Markdown 指令,可以直接跳到文末的高效 Skill 检查清单。
让脚本自己解决问题,不要把异常抛给 Claude
为 Skill 编写配套脚本时,请在代码内部显式处理异常和边界情况,不要一言不合就抛出报错让 Claude 自己去猜怎么善后。
正例:在脚本内显式兜底异常:
def process_file(path):
    """处理目标文件;若文件不存在则自动创建空文件。"""
    try:
        with open(path) as f:
            return f.read()
    except FileNotFoundError:
        # 自动创建带默认内容的文件,而不是直接崩溃退出
        print(f"File {path} not found, creating default")  # 未找到文件,正在创建默认空文件
        with open(path, "w") as f:
            f.write("")
        return ""
    except PermissionError:
        # 给出清晰的替代处理,而不是直接报错中断
        print(f"Cannot access {path}, using default")  # 无法访问该文件,改用默认空内容
        return ""
反例:直接抛错推给 Claude:
def process_file(path):
    # 直接崩溃,指望 Claude 自己想办法修
    return open(path).read()
此外,脚本里的配置参数应当写明注释理由,杜绝来历不明的“玄学常量”(Voodoo Constants,即 Ousterhout 定律所警告的硬编码参数)。如果连编写脚本的人都说不清某个参数为什么要设这个值,Claude 在调试时又怎么可能猜得准呢?
正例:自解释的配置参数:
# HTTP 请求通常在 30 秒内完成
# 留出较长的超时时间是为了兼容慢速网络连接
REQUEST_TIMEOUT = 30

# 3 次重试在可靠性与响应速度之间取得了平衡
# 绝大多数偶发性网络抖动都能在第二次重试时恢复
MAX_RETRIES = 3
反例:令人摸不着头脑的魔法数字(Magic Numbers):
TIMEOUT = 47  # 为什么偏偏是 47?
RETRIES = 5   # 为什么是 5 次?
优先提供现成的实用脚本
哪怕某段逻辑 Claude 自己也能当场写代码实现,预先打包好现成的工具脚本依然有巨大的优势:
预置工具脚本的四大好处:
- 比每次临时生成的代码稳定可靠得多
- 节省上下文 Token(无需把长篇代码塞进上下文窗口)
- 节省执行时间(省去了模型现场写代码和调试的耗时)
- 保证每次执行的逻辑与输出格式 100% 一致
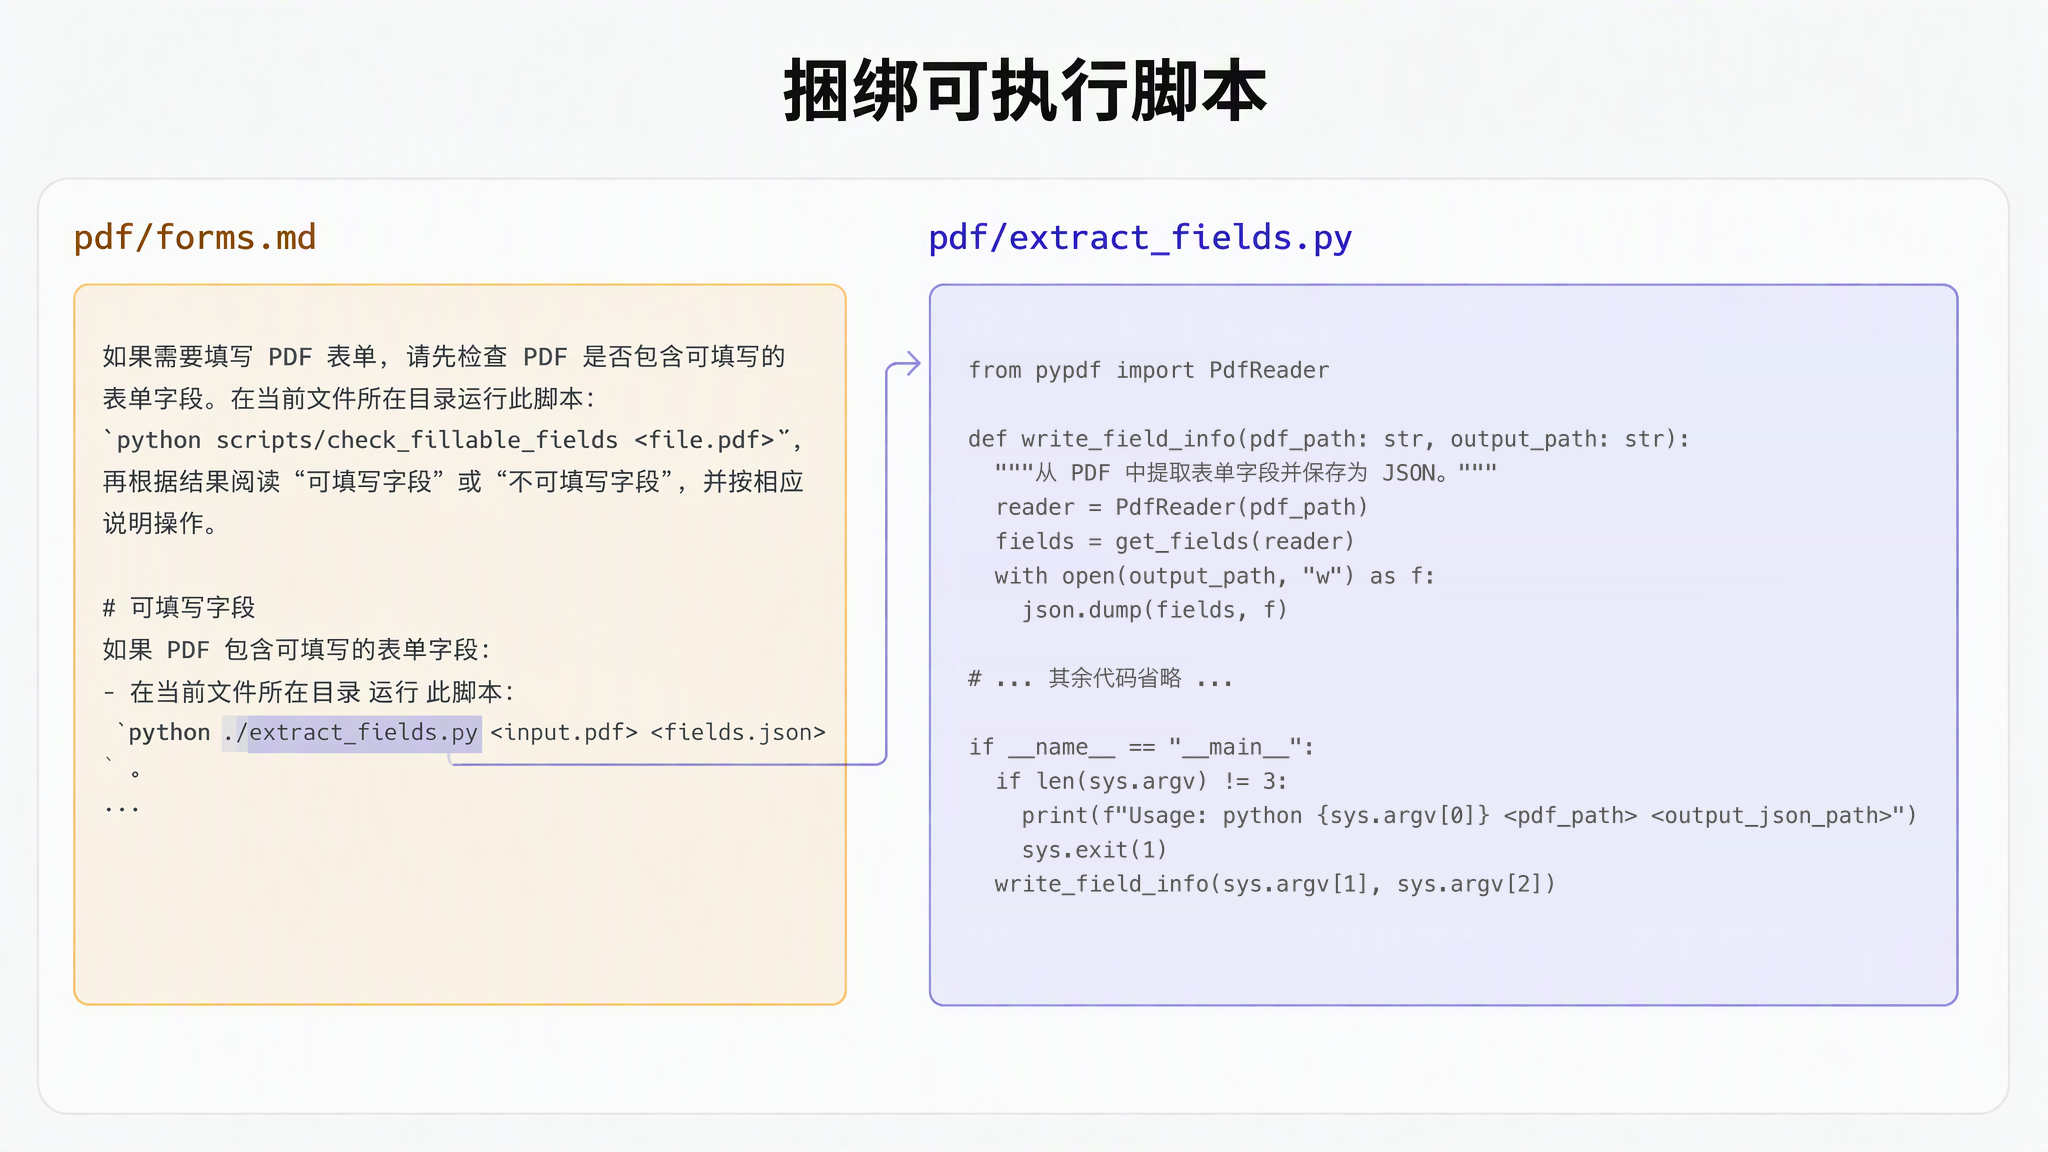
上图展示了可执行脚本如何与指令文件配合工作。指令文件(forms.md)只需写明调用命令,Claude 就能直接运行 extract_fields.py 脚本,完全不需要把脚本本身的源码读进上下文窗口。
一个重要区分: 请在指令里明确告诉 Claude,面对一个脚本文件时它应该:
- 直接运行脚本(最常见):“运行
analyze_form.py提取表单字段” - 当作参考资料阅读(针对复杂算法逻辑):“关于字段提取算法的实现细节,请查阅
analyze_form.py”
对于绝大多数工具脚本,直接执行都是更稳、更省 Token 的首选方式。关于脚本在底层是如何执行的,请参阅后文的运行时环境小节。
指令写法示例:
## 实用工具脚本

**analyze_form.py**:从 PDF 中提取所有表单字段

```bash
python scripts/analyze_form.py input.pdf > fields.json
```

输出格式:
```json
{
  "field_name": {"type": "text", "x": 100, "y": 200},
  "signature": {"type": "sig", "x": 150, "y": 500}
}
```

**validate_boxes.py**:检查是否存在重叠的字段边框(Bounding Boxes)

```bash
python scripts/validate_boxes.py fields.json
# 返回 "OK" 或列出发生冲突的字段
```

**fill_form.py**:将字段值写入 PDF 表单

```bash
python scripts/fill_form.py input.pdf fields.json output.pdf
```
善用视觉分析能力
当输入文件可以渲染成图片时,不妨引导 Claude 调动视觉能力(Vision)去观察版面:
## 表单版面视觉分析

1. 将 PDF 每一页转换为图片:
   ```bash
   python scripts/pdf_to_images.py form.pdf
   ```

2. 逐页观察渲染出的图片,识别表单输入框的位置
3. Claude 可以直接通过视觉画面看清每个字段的排版位置与控件类型
注意: 在这个例子里,你需要提前编写并随 Skill 一起提供
pdf_to_images.py脚本。
纯文本解析很难还原复杂的二维排版,而 Claude 的多模态视觉能力正好能弥补版面与结构分析的短板。
生成可验证的中间产物
当 Claude 执行复杂、开放式的批量任务时,难免会出错。采用**“规划 → 验证 → 执行(Plan-Validate-Execute)”**模式,让 Claude 先把修改计划输出成结构化的中间文件,再用脚本对这份计划做客观校验,确认无误后再真正动手执行,就能把绝大多数错误拦截在事前。
场景举例: 假设你让 Claude 根据一份电子表格,批量更新 PDF 里的 50 个表单字段。如果不做中间验证就让它直接改 PDF,它可能会引用根本不存在的字段名、填入相互冲突的值、漏掉必填项,或者把内容填错位置。
解决方案: 在前文展示的「PDF 表单填写工作流」基础上,增加一个中间产物文件 changes.json,并在真正写入 PDF 之前先用脚本校验这份 JSON。整个流程变为:分析表单 → 生成计划文件(changes.json) → 用脚本校验计划 → 执行写入 → 最终核验。
为什么这套模式效果显著:
- 把错误拦截在破坏发生之前: 校验脚本能在真正改动原文件前揪出所有配置问题。
- 机器客观可验证: 确定性的脚本校验比让模型自己肉眼检查靠谱得多。
- 计划可安全反复修改: Claude 可以放心地多次修正
changes.json,完全不用担心污染原始文件。 - 调试方向极其明确: 脚本报错能精准指出哪一个字段出了问题。
适用场景: 批量修改操作、具有破坏性的变更、包含复杂校验规则的任务、高风险生产操作。
落地小技巧: 编写校验脚本时,报错信息一定要写得具体且有指导性。比如输出 "Field 'signature_date' not found. Available fields: customer_name, order_total, signature_date_signed"(未找到字段 signature_date,当前可用字段包括:……),这样 Claude 一看报错就知道该怎么改。
运行环境的依赖包限制
Skill 运行在代码执行环境(Code Execution Environment)中,不同平台对安装第三方包有不同的限制:
- claude.ai 网页端与客户端: 可以从 npm 和 PyPI 安装软件包,也可以从 GitHub 仓库拉取代码。
- Claude API 环境: 没有网络访问权限,也不支持在运行时临时安装任何新包。
请在 SKILL.md 中明确列出所需的依赖包,并提前对照代码执行工具文档确认这些包在目标运行环境中已经预装可用。
运行时环境
Skill 运行在一个具备文件系统访问权限、Bash 命令与代码执行能力的沙盒环境中。关于这套架构的完整概念解析,请参阅概览文档中的 Skills 架构。
这一底层机制对你编写 Skill 有什么影响?
首先看 Claude 是如何访问 Skill 的:
- 启动时只预加载元数据: 会话启动时,系统只会把所有 Skill 的 YAML Frontmatter 中的
name和description注入到系统提示词里。 - 按需读取文件: 当某个 Skill 被触发后,Claude 才会调用 Bash 读取工具(Read tools)从文件系统中读取
SKILL.md以及其他附加文件。 - 高效执行脚本: 工具脚本可以直接通过 Bash 运行,完全不需要把脚本源码加载进上下文窗口,只有脚本的控制台输出(stdout/stderr)会消耗 Token。
- 大文件放在目录里零上下文开销: 参考手册、数据表或长文档只要还没被真正读取,就完全不会消耗任何上下文 Token。
因此,在组织 Skill 时请遵循以下原则:
- 文件路径至关重要: Claude 是像浏览真实文件系统一样在你的 Skill 目录里寻路的。请一律使用正斜杠(如
reference/guide.md),不要用反斜杠。 - 文件名要见名知义: 用能直接体现内容的文件名,比如用
form_validation_rules.md,而不要取名叫doc2.md。 - 按易于发现的方式组织目录: 按业务领域或功能模块划分文件夹:
- 推荐:
reference/finance.md、reference/sales.md - 避免:
docs/file1.md、docs/file2.md
- 推荐:
- 放心打包详尽的参考资料: 你可以把完整的 API 手册、海量示例和大型参考数据集一起放进目录里——在被 Claude 实际读取之前,它们不会产生任何上下文开销。
- 确定性操作一律优先写成脚本: 凡是规则固定的操作,直接提供写好的
validate_form.py,不要让 Claude 每次现场手搓校验代码。 - 明确区分“执行”与“阅读”意图:
- “运行
analyze_form.py提取字段”(意图是直接执行脚本) - “参阅
analyze_form.py了解提取算法”(意图是把脚本源码当参考资料读)
- “运行
- 实测文件寻路是否顺畅: 用真实请求跑几遍测试,确认 Claude 能顺着你的目录结构准确找到每一个文件。
目录按需加载示例:
bigquery-skill/SKILL.md(总览入口,包含指向各参考文件的路标)reference/finance.md(营收指标)sales.md(销售漏斗数据)product.md(产品使用分析)
当用户询问营收情况时,Claude 会先读 SKILL.md,看到指向 reference/finance.md 的引用,然后调用 Bash 只读取这一个文件。与此同时,sales.md 和 product.md 安静地呆在文件系统里,消耗的上下文 Token 为 0。正是这种基于文件系统的架构,让“渐进式披露”真正得以落地——Claude 可以在目录里自由寻路,只精准加载当前任务所必需的那一小块上下文。
关于技术架构的完整说明,请参阅概览文档中的 Skills 的工作原理。
引用 MCP 工具的规范写法
如果你的 Skill 需要调用 MCP(Model Context Protocol)工具,请务必使用带服务名前缀的完全限定工具名(Fully Qualified Tool Names),以免出现“找不到工具(Tool not found)”的报错。
标准格式: ServerName:tool_name
示例:
使用 BigQuery:bigquery_schema 工具获取数据表 Schema。
使用 GitHub:create_issue 工具创建 Issue。
其中:
BigQuery和GitHub是 MCP 服务器名称(Server Name)bigquery_schema和create_issue是对应服务器下的具体工具名
如果省略了前面的服务器前缀,当用户同时挂载了多个 MCP 服务器时,Claude 很可能会因为定位不到具体工具而调用失败。
不要默认第三方库已经安装
永远不要想当然地假设某个第三方包可以直接导入:
**反例:默认环境里已经装好:**
“使用 pdf 库处理该文件。”

**正例:明确写出安装与调用步骤:**
“先安装所需依赖包:`pip install pypdf`

然后再调用它:
```python
from pypdf import PdfReader
reader = PdfReader("file.pdf")
```”
技术规格备忘
YAML Frontmatter 字段校验规则
SKILL.md 顶部的 Frontmatter 必须包含 name 和 description 两个字段,并满足以下校验规则:
name:最多 64 个字符,仅允许小写字母、数字和连字符(-),禁止包含 XML 标签,禁止包含保留字(anthropic、claude)。description:最多 1,024 个字符,不能为空,禁止包含 XML 标签。
完整结构要求请参阅 Skill 结构。
Token 预算控制
请将 SKILL.md 的正文保持在 500 行以内,以确保最佳的加载与推理性能。如果内容超出这一篇幅,请利用前文介绍的渐进式披露模式,把展开细节拆分到独立的子文件中。底层架构详情请参阅 Skills 的工作原理。
高效 Skill 检查清单
在发布或向团队分享一个 Skill 之前,不妨对照这份清单做一次最终自检:
核心质量
- [ ]
description具体明确,且包含了关键触发词 - [ ]
description同时写清了“Skill 能做什么”以及“什么时机应该使用它”(且采用第三人称) - [ ]
SKILL.md正文控制在 500 行以内 - [ ] 展开细节已拆分到独立文件中(如有需要)
- [ ] 正文中没有会过期的时效性判断(或已归档至“旧版废弃模式”小节)
- [ ] 全文术语前后保持高度一致
- [ ] 提供了具体可感知的示例,而非空洞抽象的描述
- [ ] 外部文件引用保持在距离
SKILL.md一层深度以内 - [ ] 合理运用了渐进式披露机制组织目录
- [ ] 复杂任务均拆解成了步骤清晰的工作流
代码与配套脚本
- [ ] 脚本在内部主动处理异常,而不是报错甩给 Claude
- [ ] 错误处理逻辑清晰,报错提示具体且具有指导性
- [ ] 没有来历不明的“玄学常量”(所有配置参数均有注释说明理由)
- [ ] 所需依赖包已在指令中明确列出,并确认在目标环境中可用
- [ ] 脚本带有清晰的说明文档与调用示例
- [ ] 所有文件路径一律使用正斜杠(
/),不存在 Windows 反斜杠路径 - [ ] 关键或高风险操作包含中间产物校验步骤
- [ ] 对质量要求极高的任务设计了“验证 → 修复 → 重测”反馈闭环
测试与验证
- [ ] 至少针对真实能力缺口构建了 3 个评估测试场景
- [ ] 已在 Haiku、Sonnet 和 Opus 等计划使用的模型上实测通过
- [ ] 已在真实的日常任务场景中完成端到端检验
- [ ] 已收集并融入了团队成员的使用反馈(如适用)
延伸阅读
- 快速上手 Agent Skills:从零创建你的第一个 Skill
- 在 Claude Code 中使用 Skills:在 Claude Code 终端环境中创建与管理个人及项目级 Skill
- 通过 API 调用 Skills:以编程方式上传并调用自定义 Skill