 Anthropic 团队
本文由 Anthropic Labs 团队成员 Prithvi Rajasekaran 撰写。
在过去几个月里,我一直在研究两个紧密相连的问题:一是如何让 Claude 做出高质量的前端界面设计,二是如何让它在无需人工干预的情况下独立构建出完整的应用程序。这项工作源于我们此前在前端设计 Skill(frontend-design)与长周期编码 Agent 运行框架(Harness)上的探索——当时我和同事们通过提示词工程(Prompt Engineering)与 Harness 设计(即包裹在模型外层的调度框架、工具护栏、状态交接与评估循环),让 Claude 的表现大幅超越了默认基线,但这两个方向最终都撞上了天花板。
导读:如何把这篇官方实战与课程里的工作流串起来看? 这篇来自 Anthropic Labs 的一手复盘,几乎把我们在《如何使用 AI 做好看的 UI 设计》与《怎样用好子 Agent》里反复强调的核心经验全都印证了一遍:
- 为什么不能让写代码的会话自己审自己? 同一个 Agent 对自己的产出天然带有“盲目自信”,哪怕界面平庸、按钮点不动,它也会夸自己做得好。把**生成者(Generator)和评估者(Evaluator)**拆成两个独立角色,并让评估者调起浏览器工具真刀真枪去点按页面,才能逼出高质量产出。
- 主观审美怎么变成可执行的标准? 与其笼统地问 AI“这个页面好看吗”,不如把审美拆解成设计质感、原创性(严禁紫渐变白卡片等 AI 套路)、工艺细节、功能可用性四条硬指标,提高前两项权重来逼模型跳出平庸模板。
- 模型变强后,外层工作流该怎么演进? Harness 里的每一个组件,本质上都是对“模型自己还做不到什么”的一项假设。每次底层模型升级(例如从 Opus 4.5 到 4.6),最该做的不是继续叠床架屋,而是逐个拆掉已经不再承重的脚手架。
为了突破这层瓶颈,我开始寻找一种能够同时在两个截然不同的领域奏效的 AI 工程方法——一个领域取决于主观审美品味(前端设计),另一个领域则取决于可验证的正确性与可用性(全栈工程)。受生成对抗网络(GAN,Generative Adversarial Networks——一种让“生成网络”与“判别网络”相互博弈、在对立反馈中共同提升生成质量经典架构)的启发,我设计了一套包含 Generator(生成者) 与 Evaluator(评估者) 的多 Agent 架构。想要打造一个既能稳定打分、又具备审美品味的评估者,第一步就是制定一套评分准则,把“这个设计好不好?”这类主观判断转化为具体、可分档打分的指标。
随后,我把这套方法推广到了长周期自主编码中,并沿用了我们早期 Harness 研究里的两条关键经验:把庞大的构建任务拆解成易于处理的小块,以及使用结构化产物(Artifacts)在不同会话之间交接上下文。最终成型的是一个由 Planner(规划者)、Generator(生成者) 与 Evaluator(评估者) 组成的三角色架构,能够在持续数小时的自主编码会话中,构建出功能丰富的全栈应用程序。
为什么朴素的单 Agent 实现会力不从心
我们此前已经证明,Harness 设计对长周期 Agent 编码的效果有着决定性影响。在早期的一项实验中,我们使用了一个初始化 Agent(Initializer Agent)将产品规格拆解为任务清单,再让一个编码 Agent 每次只实现一个功能特性,并通过交接文档在不同会话之间传递上下文。整个开发者社区也逐渐摸索出了类似的思路,例如“Ralph Wiggum”方法就利用钩子(Hooks)或脚本让 Agent 保持在持续迭代循环中。
但对于更复杂的任务,一些顽疾依然存在:随着运行时间拉长,Agent 仍然很容易偏离正轨。在拆解这一问题时,我们观察到了执行此类任务的 Agent 最常出现的两种失败模式。
1. 上下文塞满导致的失焦与“上下文焦虑”
第一种失败模式是,当任务拉长、上下文窗口(Context Window,模型单次会话能容纳的文本总量)逐渐塞满时,模型往往会丧失连贯性(详见我们关于上下文工程(Context Engineering)的文章)。不仅如此,部分模型还会表现出一种**“上下文焦虑(Context Anxiety)”**:当它们觉得自己快要触及上下文容量上限时,就会开始仓促收尾、草草交差。
解决这两个问题的关键手段是上下文重置(Context Resets)——彻底清空当前上下文窗口,启动一个全新的 Agent 实例,同时配合一份结构化的交接文档(Handoff Artifact),把上一个 Agent 的工作状态和下一步计划完整传递过去。
这种做法与**上下文压缩(Compaction)**有着本质区别。压缩是在原会话内部对早期对话历史做就地摘要,让同一个 Agent 基于缩短后的历史继续往下干。虽然压缩保留了会话的连续性,但它并没有给 Agent 一块真正干净的黑板,这意味着“上下文焦虑”依然可能挥之不去。而重置则提供了彻底干净的初始状态,代价是交接产物必须包含足够完整的状态信息,才能让下一棒 Agent 顺滑接手。在我们早期的测试中,Claude Sonnet 4.5 表现出的上下文焦虑非常明显,单靠压缩不足以支撑长任务表现,因此上下文重置成了当时 Harness 设计里不可或缺的一环——它解决了核心病根,但也给每次运行增加了编排复杂度、Token 开销与等待耗时。
2. 自我评估时的盲目自信
第二个此前尚未深入解决的问题是自我评估偏差(Self-evaluation Bias)。当被要求评估自己刚刚产出的成果时,Agent 往往会充满自信地大加赞赏——哪怕在人类观察者看来,这份产出的质量明显平庸甚至漏洞百出。
这个问题在像设计这样缺乏二元对错标准(没有像软件单元测试那样非黑即白的自动检查)的主观任务中尤为突出。一个页面排版究竟是精致考究还是平庸套路,本质上是一种审美判断,而 Agent 在给自己的作品打分时,几乎总是稳定地偏向高分好评。
更棘手的是,即便在拥有明确可验证结果的编码任务中,Agent 在执行过程中也常常表现出糟糕的判断力,从而拖累最终效果。将“干活的 Agent”与“评判的 Agent”彻底分离,证明是解决这一问题的强力杠杆。当然,仅仅把角色拆开并不会立刻消除这种宽容倾向——因为评估者本身依然是一个大语言模型,天生倾向于对大模型生成的产出手下留情。但实践证明,把一个独立的 Evaluator 调教得严苛挑剔,远比让一个正在写代码的 Generator 对自己的作品自我批判要容易得多;而且一旦有了外部反馈,Generator 就有了清晰具体的改进靶子。
前端设计:把主观审美转化为可打分的标尺
我首先在前端设计场景下展开实验,因为自我评估偏差在这里暴露得最彻底。如果不加任何干预,Claude 通常会滑向安全、套路化的布局——技术上能跑通,但视觉上乏善可陈。
有两个核心洞察塑造了我为前端设计搭建的 Harness:
- 审美虽然无法完全简化为一个冷冰冰的分数(个人品味也永远存在差异),但可以通过融入了设计原则与偏好的评分标准来显著改善。 问模型“这个设计美不美?”很难得到一致的回答;但问它“这个设计是否遵循了我们的优秀设计原则?”,就给了 Claude 一把具体可度量的标尺。
- 把前端生成与前端评分拆开,就能构建出一个持续驱动 Generator 产出更强作品的反馈闭环。
基于这两点,我编写了四项评分准则(Grading Criteria),并同时写进了 Generator 和 Evaluator 的提示词中:
- Design quality: Does the design feel like a coherent whole rather than a collection of parts? Strong work here means the colors, typography, layout, imagery, and other details combine to create a distinct mood and identity.
- Originality: Is there evidence of custom decisions, or is this template layouts, library defaults, and AI-generated patterns? A human designer should recognize deliberate creative choices. Unmodified stock components—or telltale signs of AI generation like purple gradients over white cards—fail here.
- Craft: Technical execution: typography hierarchy, spacing consistency, color harmony, contrast ratios. This is a competence check rather than a creativity check. Most reasonable implementations do fine here by default; failing means broken fundamentals.
- Functionality: Usability independent of aesthetics. Can users understand what the interface does, find primary actions, and complete tasks without guessing?

# 中文对应准则说明:
# 1. 设计质感(Design quality):设计是否让人感觉是一个协调统一的整体,而不是零散组件的拼凑?优秀的作品意味着色彩、字体排印、布局、图像与其他细节融为一体,营造出鲜明的氛围与辨识度。
# 2. 原创性(Originality):画面中是否体现了深思熟虑的定制化决策,还是充斥着模板布局、组件库默认样式和 AI 生成套路?人类设计师应当能从中看出刻意的创意选择。原封不动的现成组件——或者“白底卡片配紫色渐变”这类典型的 AI 生成痕迹——在这一项直接判定为不合格。
# 3. 工艺细节(Craft):技术执行层面的基本功,包括字号层级、间距一致性、色彩和谐度与对比度。这是一项基本功检查而非创意检查;大多数合理实现默认都能过关,不及格意味着基础排版崩坏。
# 4. 功能可用性(Functionality):独立于审美之外的易用性。用户能否一眼看懂界面是干什么的、快速找到主要操作入口,并在不需要靠猜的情况下完成任务?
在这四项指标里,我刻意将设计质感与原创性的权重设得远高于工艺细节与功能可用性。因为 Claude 默认在工艺和功能上就已经得分不错,所需的技术实现能力对模型来说水到渠成;但在设计与原创性上,Claude 的默认产出往往极其平淡。评分标准明确惩罚了高度同质化的“AI 敷衍感(AI slop)”套路,并通过加重设计与原创性的分值比重,倒逼模型在审美上大胆突破。
同时,我使用带有详细分项打分解析的少样本示例(Few-shot Examples)对 Evaluator 进行了校准。这确保了 Evaluator 的审美判断与我的偏好保持对齐,并减少了多轮迭代过程中的评分漂移。
我基于 Claude Agent SDK 搭建了这个循环,编排逻辑非常直接:
- 首先,Generator Agent 根据用户提示词生成一套 HTML/CSS/JS 前端页面;
- 接着,我为 Evaluator 配备了 Playwright MCP(基于 Model Context Protocol 的浏览器自动化工具,允许 AI 直接拉起真实浏览器并模拟点击、滚动、截图和检查 DOM),让它先像真实用户一样直接与运行中的网页交互,然后再对每项准则打分并撰写详细的批评意见(Critique);
- 在实际运行中,Evaluator 会自主浏览页面、截取屏幕画面并仔细研判实现细节,随后生成评估报告;
- 这份反馈会作为下一轮迭代的输入传回给 Generator。
每次生成任务我会运行 5 到 15 轮迭代,每一轮回应 Evaluator 批评的过程,通常都会把 Generator 推向更具辨识度的设计方向。由于 Evaluator 是在真实操作网页而非仅仅看一张静态截图打分,每一轮都会消耗真实的挂钟时间,完整跑完一次任务最长可达四个小时。此外,我还指示 Generator 在每次收到评估后做出一项战略抉择:如果分数呈上升趋势,就继续在当前方向上精雕细琢;如果当前路子走不通,就直接推倒重来,转向一种完全不同的美学风格。
在多次实测中,Evaluator 的评分都会随着迭代轮次稳步上升,随后进入平台期,同时仍保留着进一步提升的空间。有些生成任务是循序渐进打磨出来的,另一些则在相邻两轮之间出现了令人惊喜的审美跃迁。
准则的措辞方式甚至以我未曾完全预料到的方式引导着 Generator。例如,当提示词里加入“最佳设计应当达到博物馆馆藏级品质(museum quality)”这类表述时,生成的设计就会朝着特定的高冷展览视觉风格收敛——这说明与评分准则绑定的提示词措辞,会直接塑造最终产出的气质。
尽管分数总体随迭代上升,但曲线并非总是呈现平滑的线性增长。靠后的版本整体上确实更好,但我也经常遇到自己更偏爱中间某一轮版本而非最后一轮的情况。随着轮次增加,实现复杂度也往往水涨船高,Generator 会为了回应 Evaluator 的反馈而尝试更具野心的方案。值得一提的是,哪怕在第一轮生成(尚未收到任何 Evaluator 反馈)时,产出质量也明显优于完全不加提示词的基线——说明这套评分准则及配套表述本身,就已经在评估循环介入前先把模型拉离了平庸的默认套路。
在一个令人印象深刻的案例中,我让模型为一家荷兰艺术博物馆设计网站(对应原文演示视频中展示的交互式 3D 展厅演进过程)。到第 9 轮迭代时,它做出了一个干净、深色主题的虚构博物馆落地页,视觉上很精致,但基本还在常规预期之内。然而到了第 10 轮,它彻底推翻了原先的方案,将整个网站重构为一次空间体验:用 CSS 透视渲染出一间铺着棋盘格地砖的 3D 展厅,画作自由悬挂在四周墙面上,用户不再靠上下滚动或普通点击切页,而是通过走过一扇扇门洞在不同画廊展厅之间穿行。这种创造性的跃迁,是我在单次直出生成中从未见过的。
扩展到全栈应用开发
拿到前端实验的结论后,我将这套受 GAN 启发的对抗评估模式推广到了全栈应用开发中。Generator-Evaluator 循环与软件开发生命周期天然契合——在软件工程里,代码审查(Code Review)与质量保障测试(QA)所扮演的结构性角色,正对应着前端实验里的设计评估者。
三角色系统架构
在我们早期的长周期 Harness 中,我们曾通过“初始化 Agent + 每次只做一个功能的编码 Agent + 会话间上下文重置”解决了跨会话编码的连贯性问题。当时上下文重置是核心突破口,因为那套 Harness 使用的是 Sonnet 4.5,存在前文提到的“上下文焦虑”倾向;让 Harness 在跨重置时平稳交接,是防止模型跑偏的关键。而到了 Opus 4.5,模型自身很大程度上克服了这种提前收尾的毛病,因此我得以在这套新 Harness 中彻底取消了上下文重置——所有 Agent 在整个构建周期内都作为同一个连续会话运行,由 Claude Agent SDK 的自动压缩(Automatic Compaction)机制沿途处理上下文增长。
在这项工作中,我在原有 Harness 的基础上搭建了一套三角色 Agent 系统,每个角色专门补齐我在过往运行中观察到的一个特定短板:
- Planner(规划者):我们以前的长周期 Harness 要求用户事先写好一份详尽的产品规格说明书(Spec)。为了把这一步也自动化,我创建了一个 Planner Agent,它接收短短 1 到 4 句话的用户提示词,并将其扩展成一份完整的产品规格文档(文末附录展示了它生成的真实示例)。我在提示词中要求它对功能范围保持雄心,同时专注于产品背景与高层级技术设计,而不要过早陷入细枝末节的技术实现。之所以这样强调,是因为一旦 Planner 试图在事前规定过于细碎的技术实现细节且出了错,规格文档里的错误就会像多米诺骨牌一样传导给下游的实现环节。更明智的做法是:只约束 Agent 最终必须交付的成果(Deliverables),至于具体怎么写代码走通,留给后续 Agent 在实现过程中自行探索。此外,我还要求 Planner 主动寻找机会,将 AI 原生功能融入产品规格之中。
- Generator(生成者):早期 Harness 中“每次只做一个功能”的做法在范围控制上效果极佳。我在这里沿用了类似的模式,指示 Generator 按**迭代冲刺(Sprint)**开展工作,每次从规格文档中认领一个功能模块,使用
React + Vite + FastAPI + SQLite(后期升级为PostgreSQL)技术栈实现应用,并在每个 Sprint 结束移交 QA 之前先做一轮自我评估。同时,它也拥有git权限用于版本控制。 - Evaluator(评估者 / QA):早期 Harness 生成的应用往往猛一看很惊艳,但真正上手操作时却漏洞百出。为了抓住这些真 bug,Evaluator 使用 Playwright MCP 像真实用户一样点击操作正在运行的应用程序,全面测试 UI 交互功能、后端 API 接口以及数据库状态。随后,它会结合实测抓到的 bug,并对照一套由前端实验改编而来的全栈评分标准(涵盖产品深度、功能可用性、视觉设计与代码质量四个维度)为每个 Sprint 打分。每一项标准都设有硬性及格线(Hard Threshold);只要有任何一项低于阈值,该次 Sprint 即告失败,Generator 会收到关于具体哪里出错的详细反馈报告并返工修复。
在每个 Sprint 动工写任何一行代码之前,Generator 和 Evaluator 会先协商一份冲刺契约(Sprint Contract):共同敲定这一小块工作做到什么程度才算“完成(Done)”。之所以设置这个环节,是因为产品规格文档刻意保持了高层级抽象,我需要一个中间步骤来弥合“用户故事(User Stories)”与“可测试的具体实现”之间的鸿沟:
- Generator 先提出自己准备在本次 Sprint 中构建哪些内容,以及如何验证成功;
- Evaluator 审查这份提案,确保 Generator 方向正确、没有偏离规格要求;
- 双方来回迭代直至达成一致。
Agent 之间的通信完全通过本地文件完成:一个 Agent 写入文件,另一个 Agent 读取该文件并在原文件内追加回复,或写入一个新文件供对方读取。随后,Generator 严格对照双方达成共识的契约编写代码,完成后再移交 QA 验收。这种机制既保证了开发过程忠于产品规格,又避免了在一开始就过度规定死板的实现细节。
运行首版 Harness:复古 2D 游戏制作器实测
在第一版 Harness 实测中,我使用了当时最强的编码模型 Claude Opus 4.5,将相同的用户提示词分别丢给**完整三角色 Harness(Full harness)与单 Agent 系统(Solo)**进行对比。
我用下面这一句话提示词来生成一款复古电子游戏制作工具:
Create a 2D retro game maker with features including a level editor, sprite editor, entity behaviors, and a playable test mode.

# 中文提示词对应写法:
# 创建一个 2D 复古游戏制作工具,功能需包含关卡编辑器、像素精灵(Sprite)编辑器、实体行为配置,以及可直接上手试玩的测试模式。
下表展示了两种模式的运行时长与总 Token 成本对比:
| 运行模式(Harness) | 运行时长(Duration) | 总成本(Cost) | | --- | --- | --- | | 单 Agent 直出(Solo) | 20 分钟 | $9 | | 完整三角色 Harness(Full harness) | 6 小时 | $200 |
完整 Harness 的成本是单 Agent 的 20 倍以上,但两者在产出质量上的差距也是一眼可见的。
我原本期望看到一个能让我搭建关卡及其组成元素(像素精灵、游戏实体、地块布局),然后点击“播放(Play)”就能真正在里面跑跳试玩的界面。我先打开了单 Agent(Solo)跑出来的应用,初看第一屏似乎还挺符合预期:
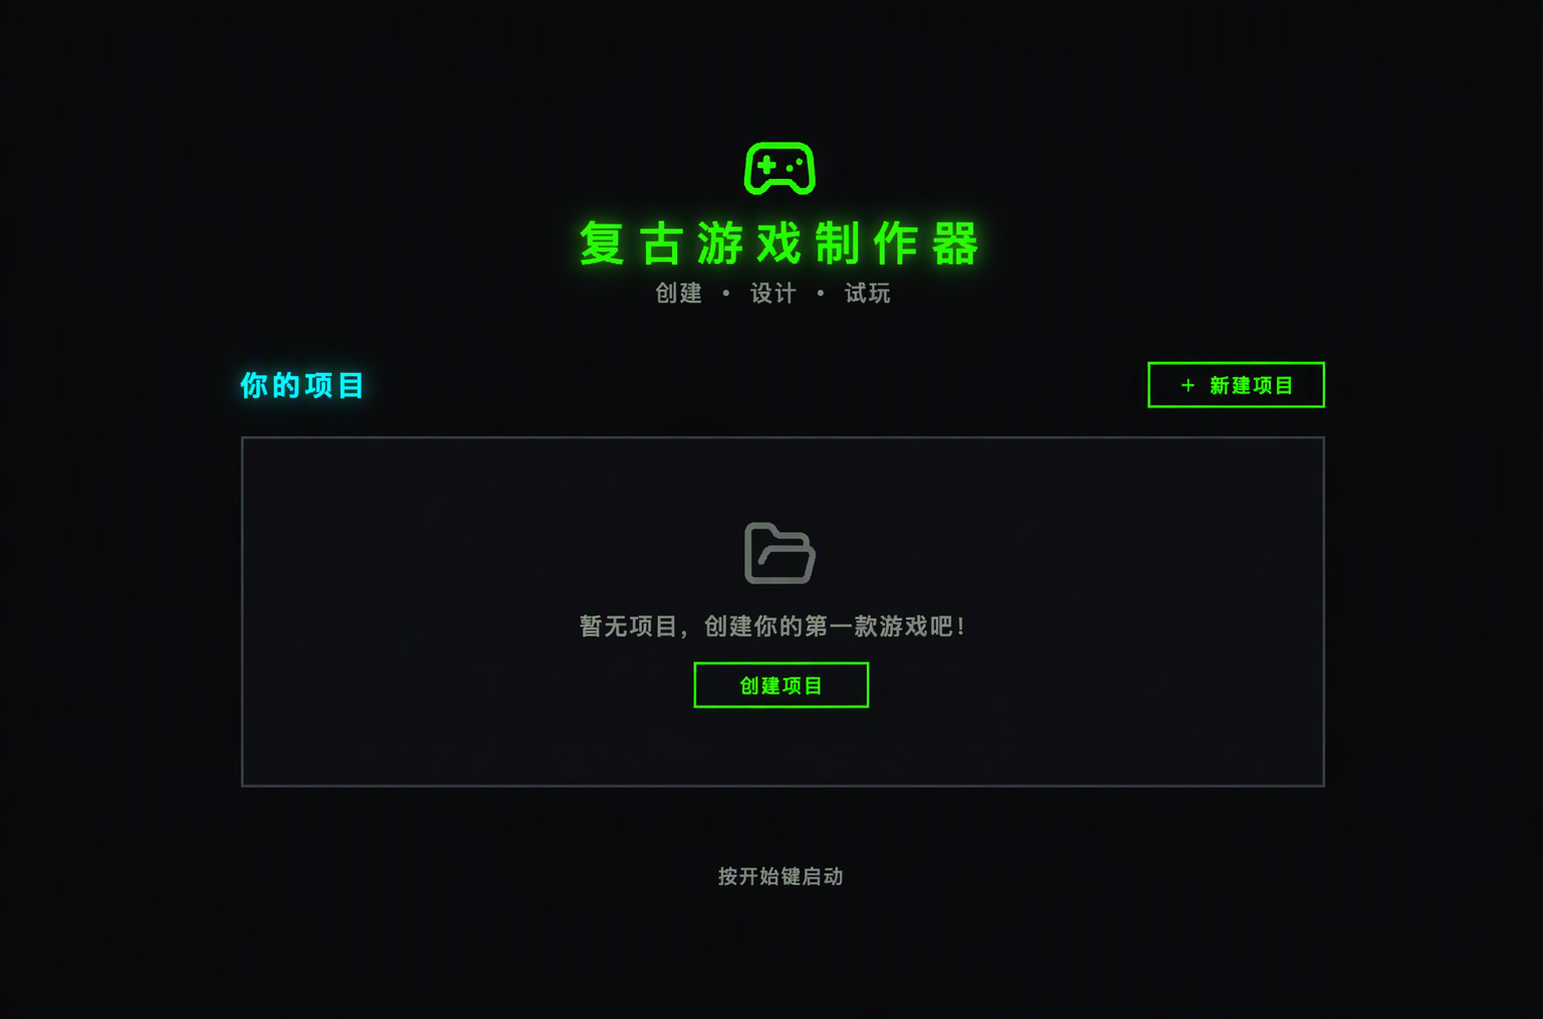
然而随着我一路点击操作,问题接二连三地暴露出来。首先是布局严重浪费空间,固定高度的面板让浏览器视口(Viewport)大片区域空置;其次是工作流非常僵硬——当我试图往关卡里放置元素时,系统提示我必须先创建精灵(Sprites)和实体(Entities),但界面上没有任何引导告诉我正确的操作顺序:
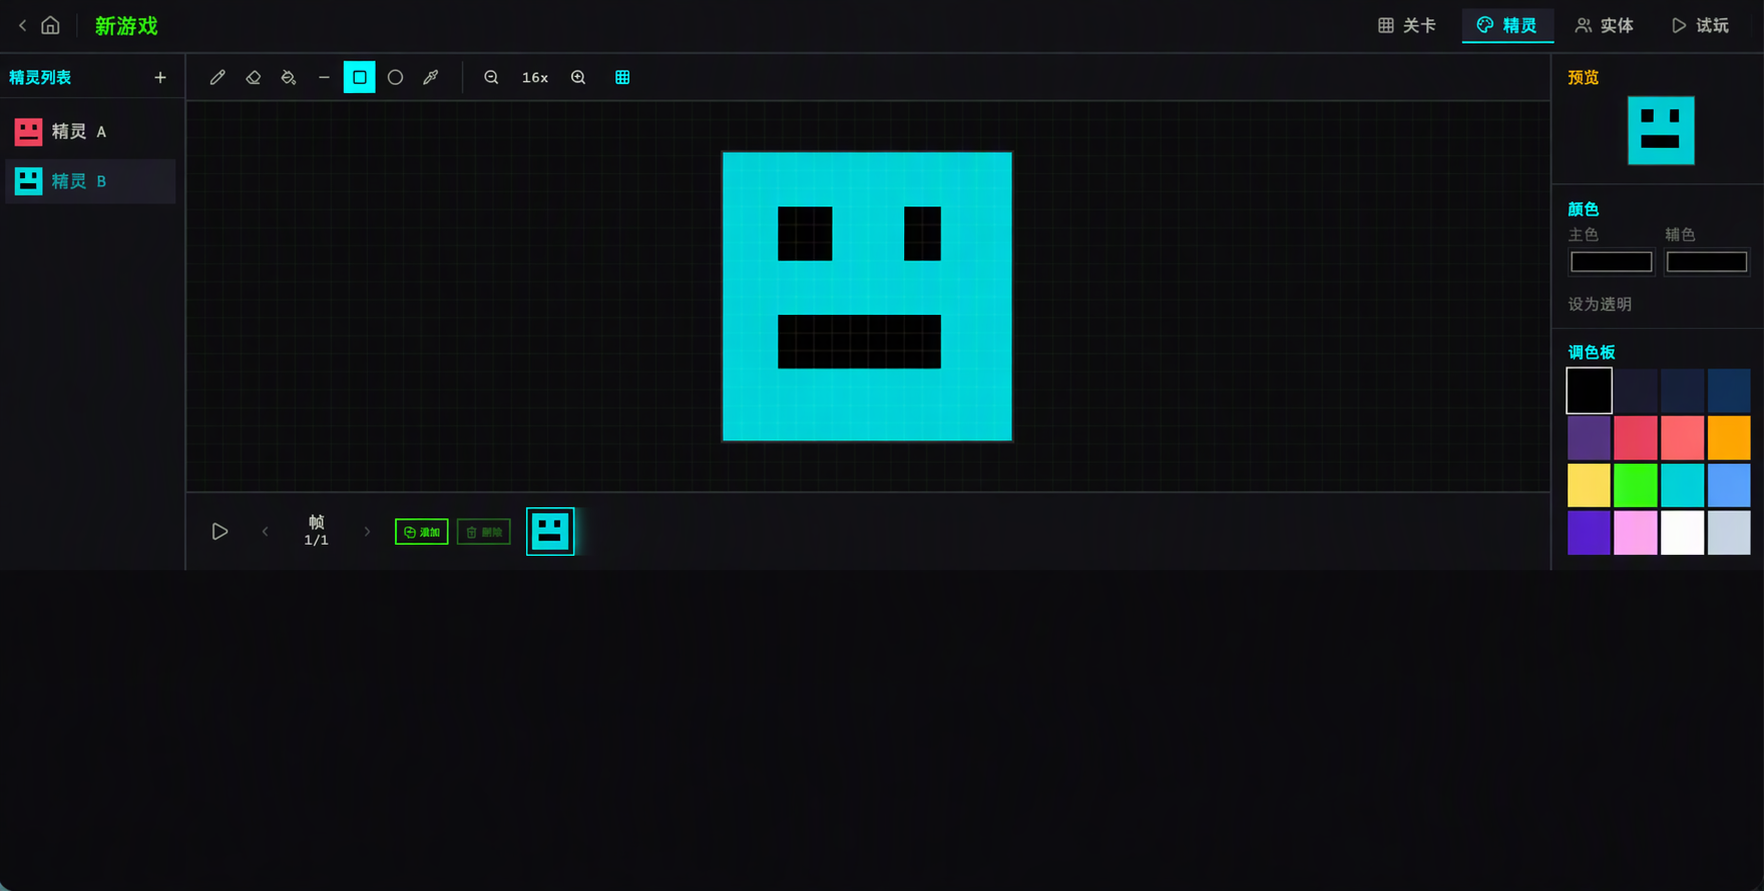
更致命的是,游戏本身根本跑不起来。我放置的实体虽然显示在了屏幕上,但按任何按键都毫无反应。翻看底层代码才发现,实体定义(Entity Definitions)与游戏运行时(Game Runtime)之间的事件接线完全是断的,而界面上没有任何报错提示:
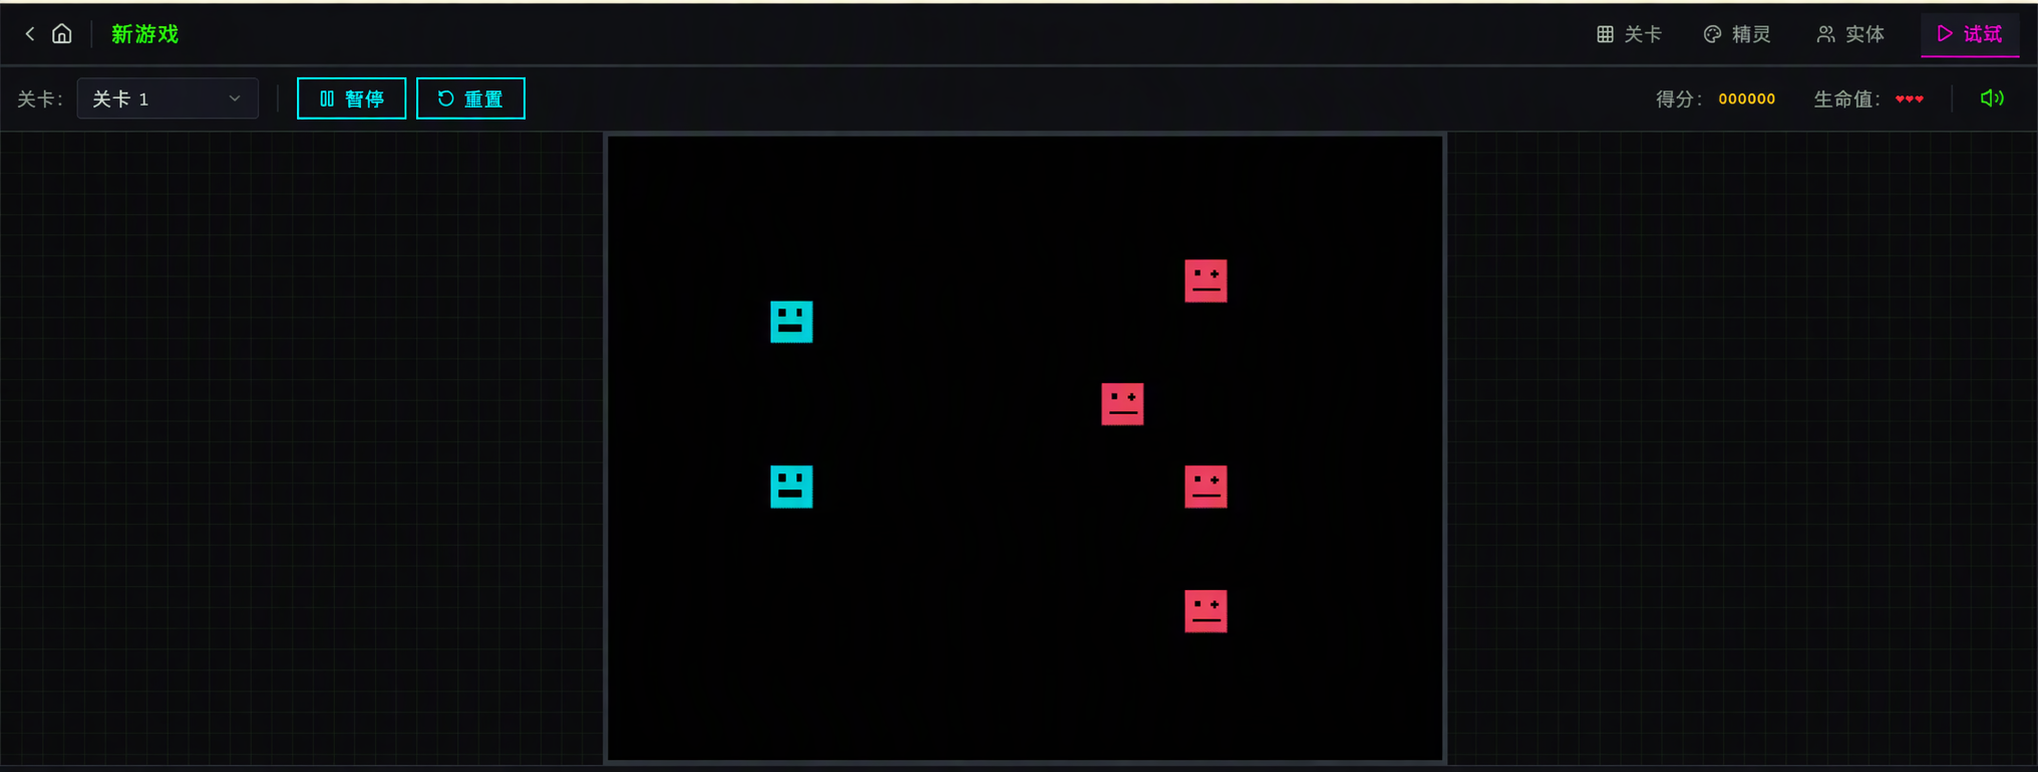
评估完单 Agent 版本后,我转向了完整 Harness 生成的应用。这次运行同样从那一句简短的提示词起步,但 Planner 阶段将这一句话扩展成了一份横跨 10 个 Sprint、包含 16 大功能模块的完整产品规格书,远远超出了单 Agent 所尝试的范畴。除了核心编辑器与试玩模式外,规格书还规划了精灵帧动画系统、行为模板库、音效与背景音乐编辑器、AI 辅助精灵生成与关卡设计器,以及支持生成分享链接的游戏导出功能。我还向 Planner 开放了我们的前端设计 Skill,Planner 主动读取了该 Skill,并在产品规格书中为这款应用量身定制了一套统一的视觉设计语言。在每一个 Sprint 开始前,Generator 与 Evaluator 都协商了一份契约,明确规定了本轮的具体实现细节以及验收时必须测试的可验证行为。
打开完整 Harness 生成的应用,精致感与顺滑度立刻与单 Agent 版本拉开了代差。画布充分利用了整个视口,各个面板尺寸恰到好处,整套界面拥有高度统一的视觉辨识度,严格遵循了规格书确立的设计方向:
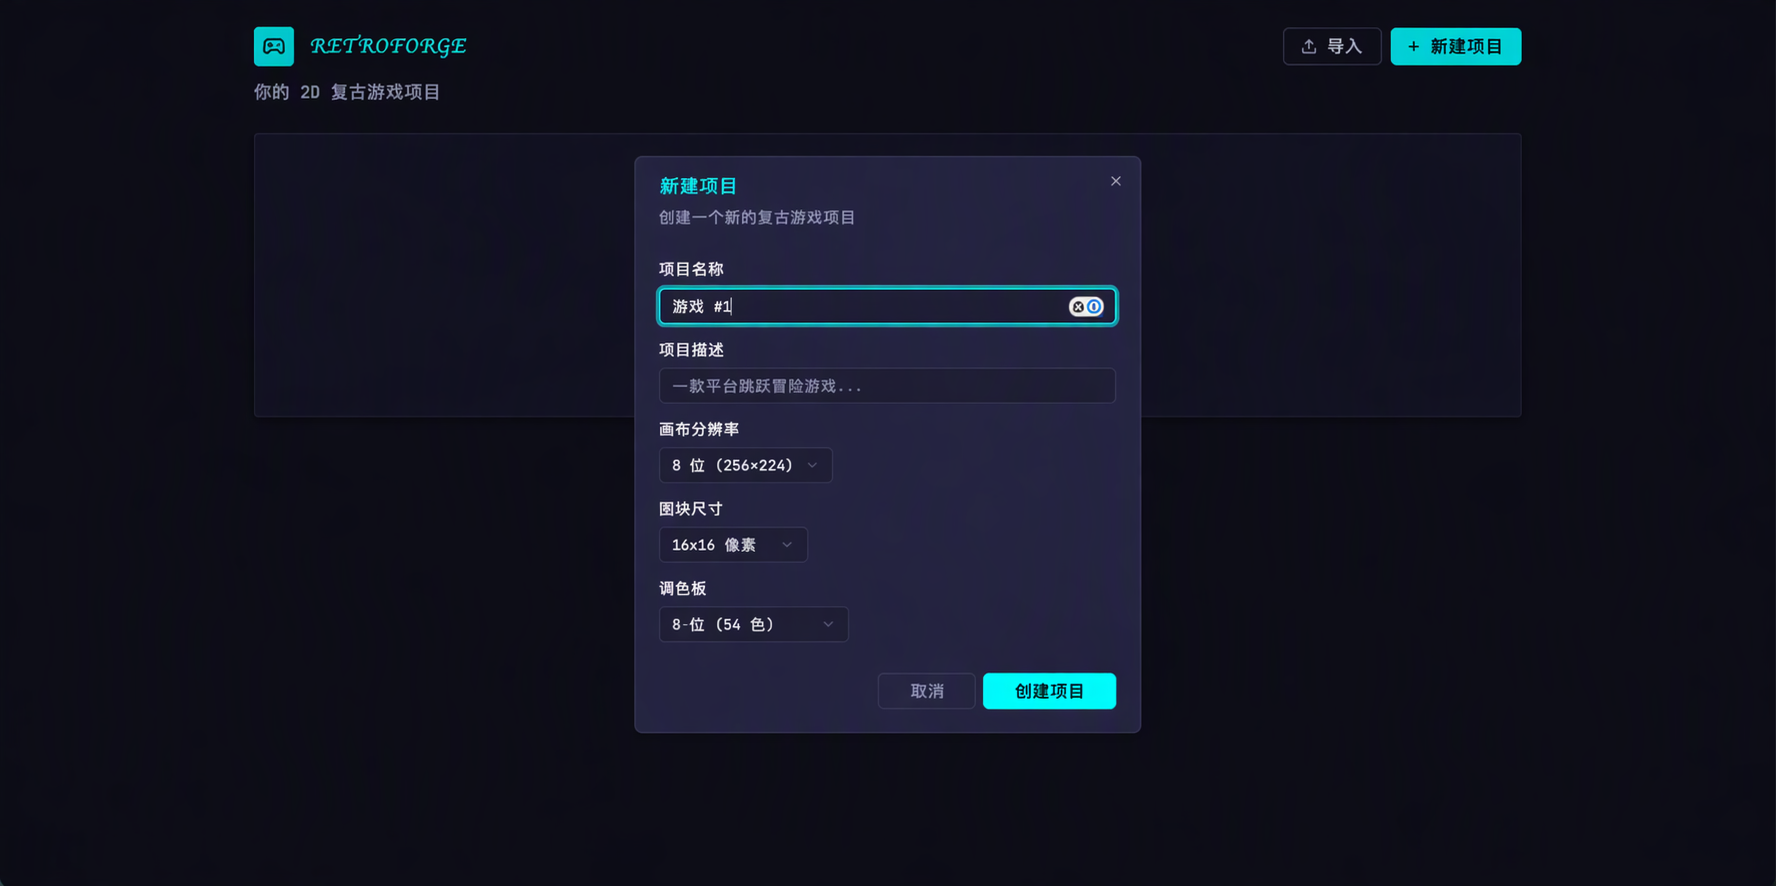
当然,单 Agent 版本里遇到的一点交互生涩感依然存在——工作流仍然没有直观提示用户“应该先去创建精灵和实体、再来填充关卡”,我还是得靠自己摸索才搞清楚顺序。这反映出底层模型本身的产品直觉仍有短板,并非当前 Harness 架构专门针对的目标,但也指明了后续在 Harness 内部做针对性迭代的改进空间。
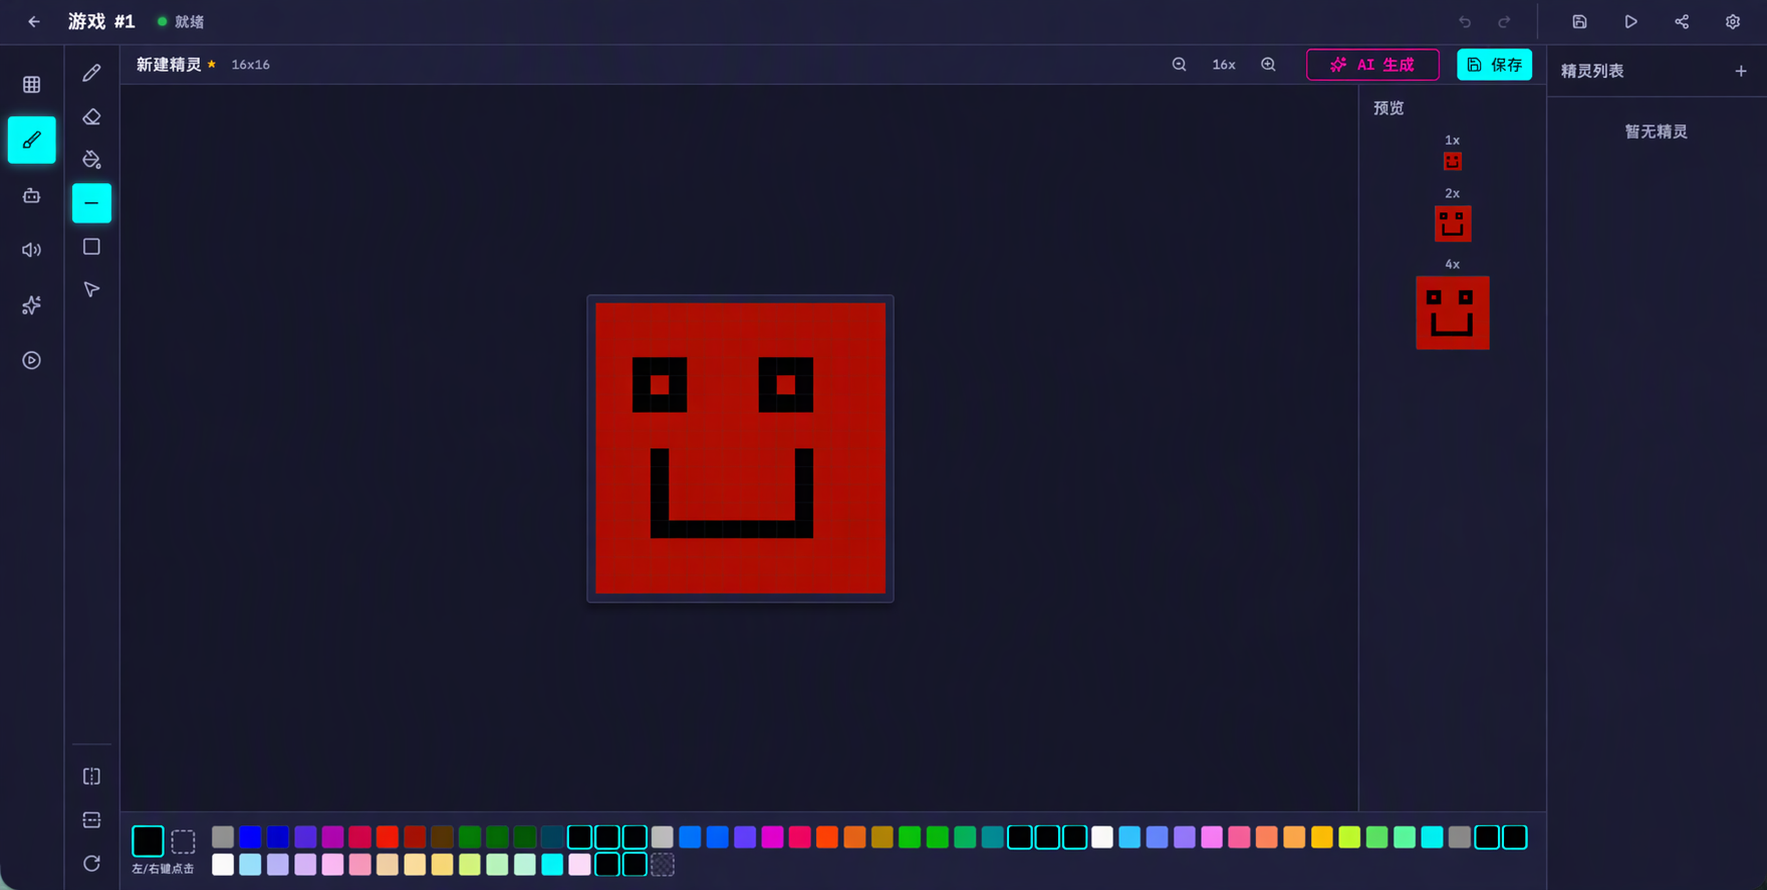
当我逐个体验各个编辑器时,新版本相对于单 Agent 的优势变得愈发明显。精灵编辑器功能丰富得多,工具面板清爽整洁,取色器更好用,缩放控制也更加顺手:
而且,因为我要求 Planner 在规格书中融入 AI 能力,这款应用还直接内置了 Claude 集成,允许我通过自然语言提示词来生成游戏的各个部分,极大加快了创作流:
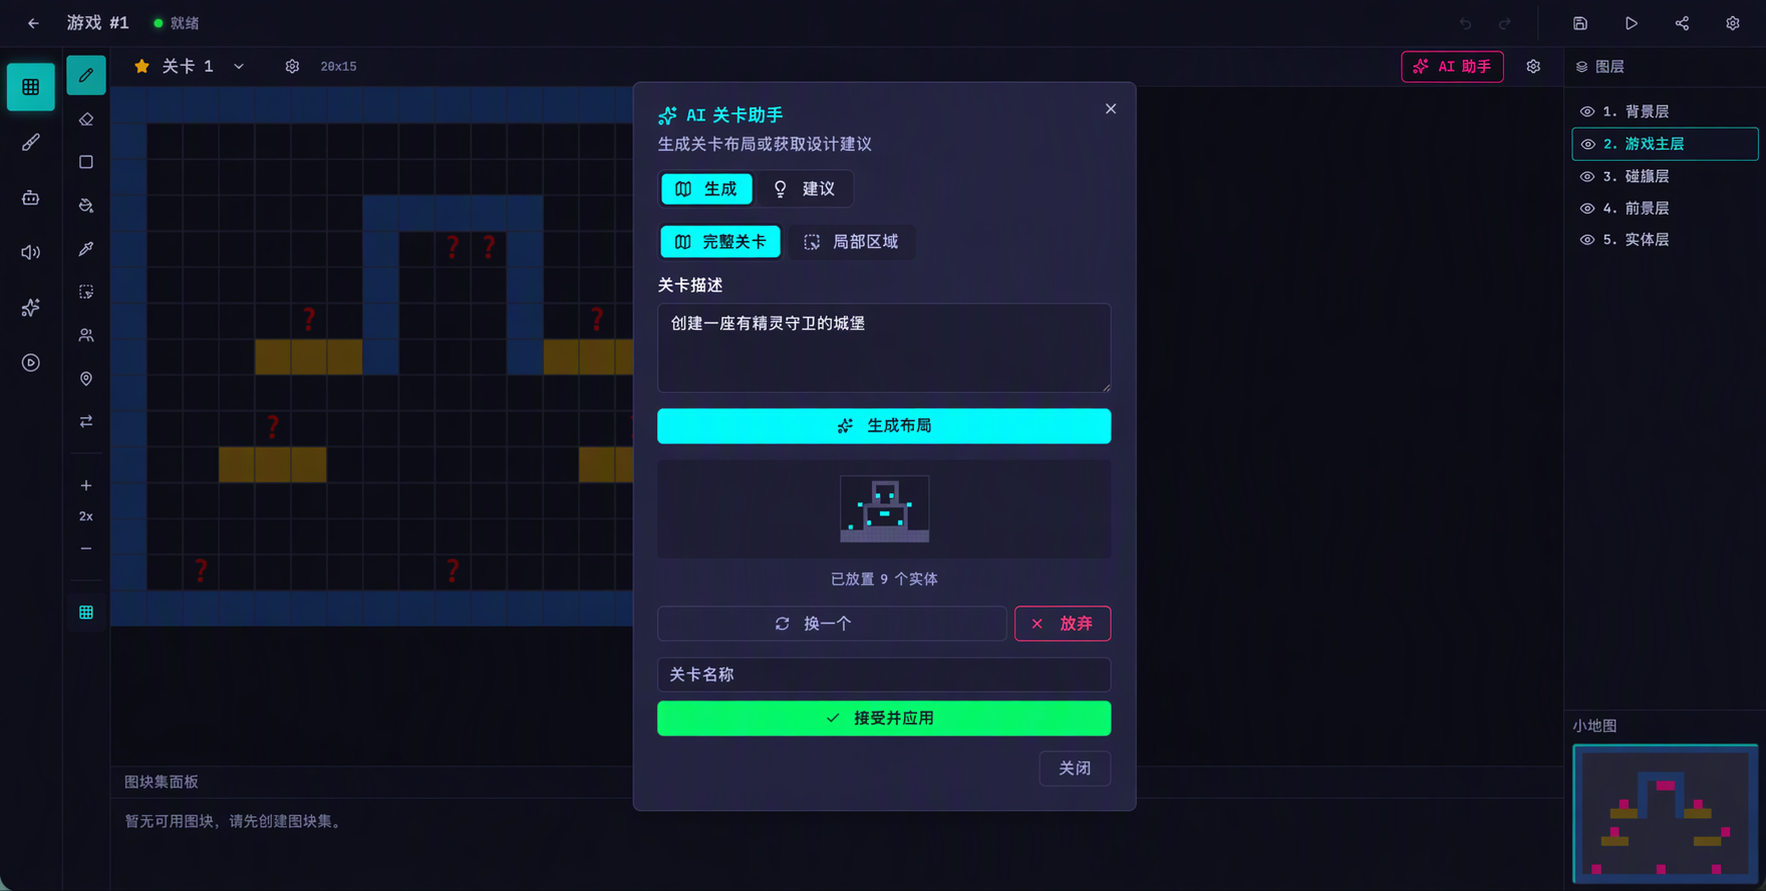
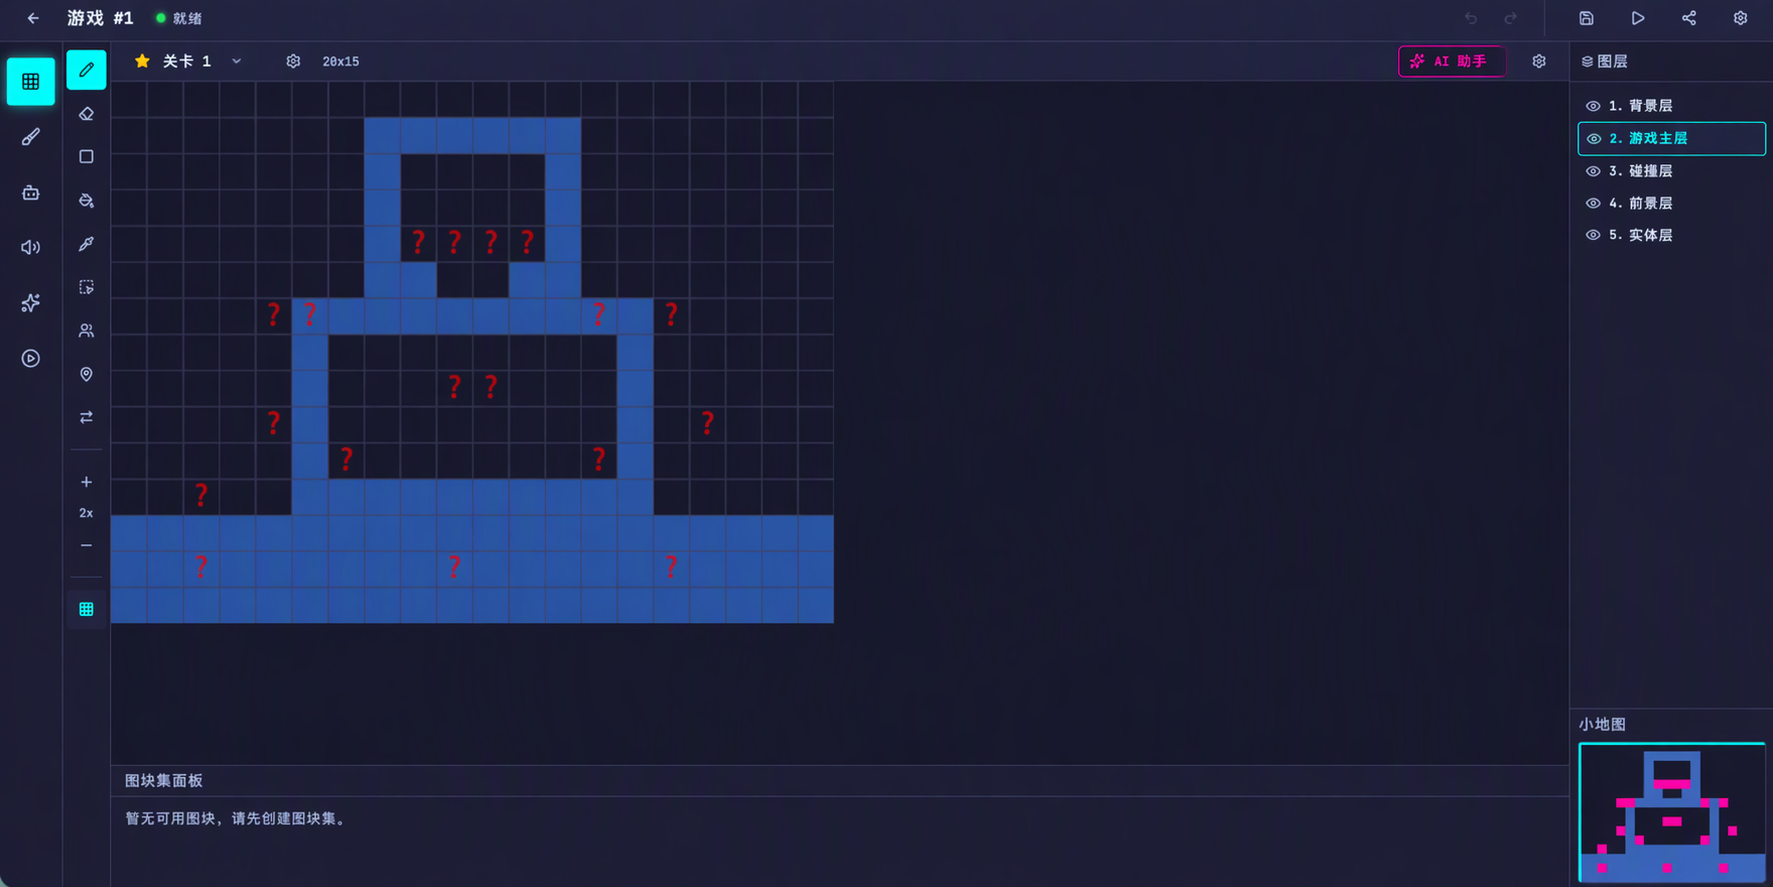
点击接受并应用后,AI 生成的城堡布局与实体出生点便直接铺设到了关卡画布与右下角小地图中:
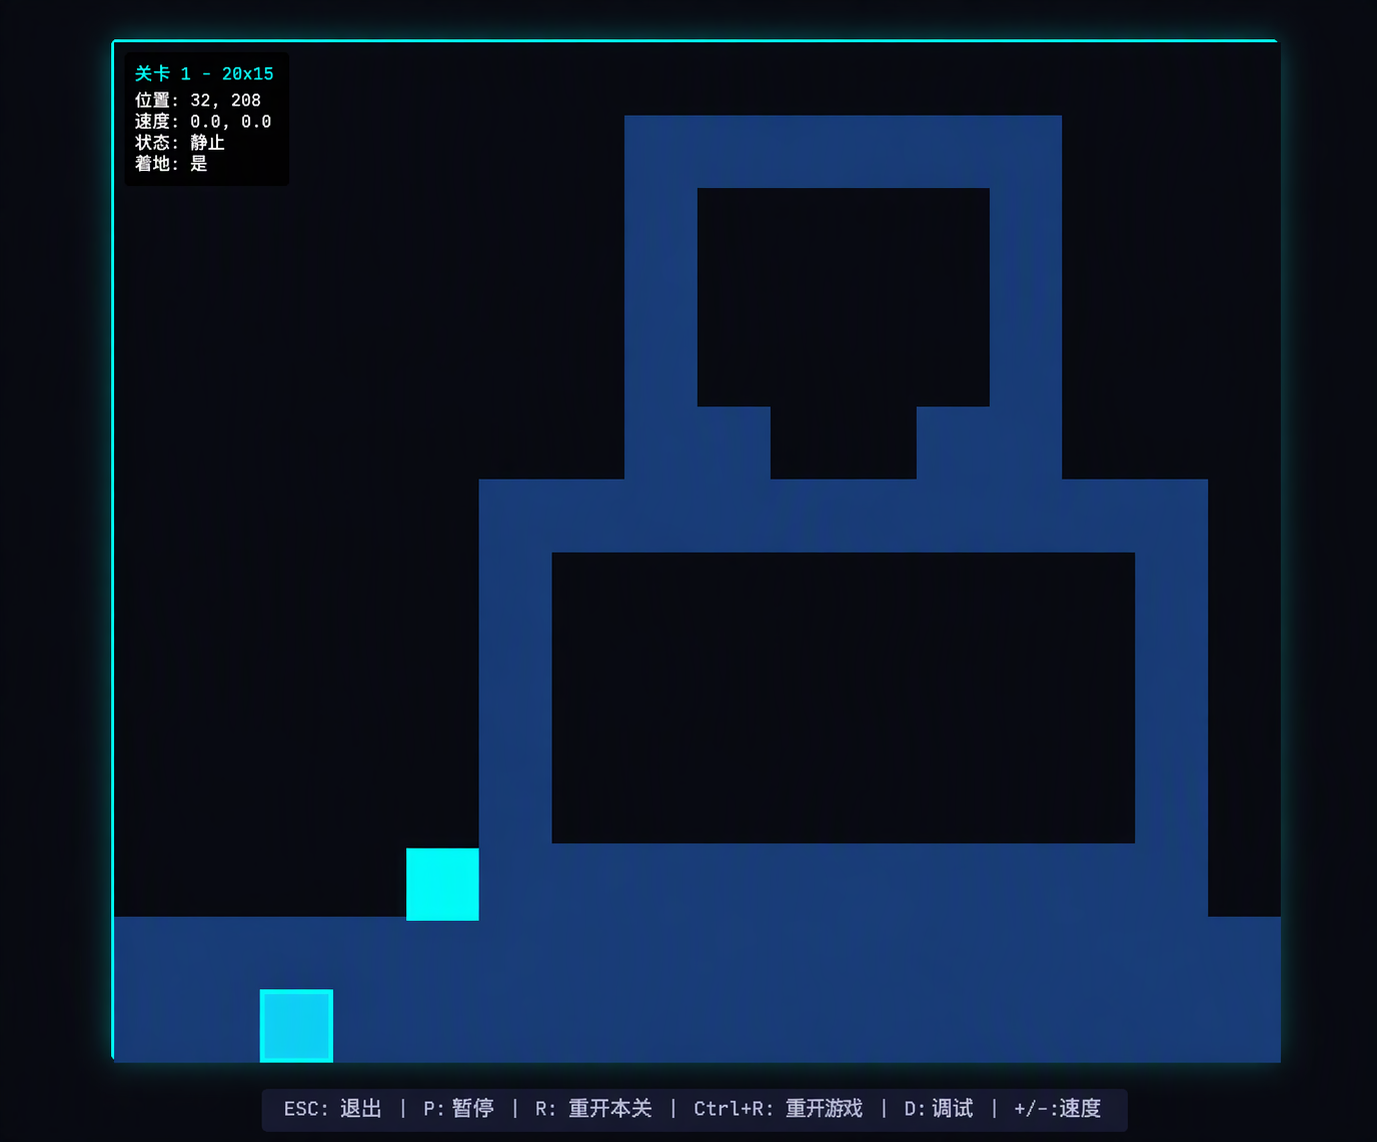
最大的差距体现在试玩模式(Play Mode)上——这一次,我真的能操控自己的角色在关卡里跑跳游玩了! 虽然物理碰撞还有一些粗糙的边缘(比如角色跳上平台后会出现局部像素重叠,直觉上略显怪异),但最核心的游戏循环是真正跑通的,而这是单 Agent 版本完全没做到的。四处移动了一会儿后,我也撞上了 AI 生成关卡时的常识性局限:面前有一堵过高的墙,角色怎么跳都翻不过去,结果卡关了。这说明在关卡合理性与边界情况处理上,Harness 还有进一步打磨的空间。
翻阅运行日志可以清楚地看到,正是 Evaluator 牢牢看住了实现质量,使其始终对齐规格书要求。在每个 Sprint 结束时,Evaluator 都会逐条对照冲刺契约里的测试标准,通过 Playwright 操作正在运行的应用,对任何偏离预期行为的地方提交 bug 报告。契约的颗粒度非常细——仅第 3 个 Sprint(负责关卡编辑器)就列出了 27 条验收标准——而且 Evaluator 给出的排查结论具体到了文件名、行号与根因,Generator 无需额外排查就能直接动手修复。下表展示了 Evaluator 在实测中抓到的几个典型 bug:
| 冲刺契约验收标准(Contract criterion) | Evaluator 实测发现的问题(Evaluator finding) |
| --- | --- |
| 矩形填充工具允许按住拖拽,用所选图块填满矩形区域 | 未通过(FAIL) —— 工具只在拖拽起点和终点放置了图块,而没有填满整个区域。代码中虽然存在 fillRectangle 函数,但在 mouseUp 事件中未能正确触发。 |
| 用户可以选中并删除已放置的实体出生点 | 未通过(FAIL) —— LevelEditor.tsx:892 处的 Delete 按键处理逻辑要求同时设置 selection 和 selectedEntityId,但点击单个实体时只会设置 selectedEntityId。判断条件应改为 selection \|\| (selectedEntityId && activeLayer === 'entity')。 |
| 用户可以通过 API 调整动画帧顺序 | 未通过(FAIL) —— PUT /frames/reorder 路由定义在了 /{frame_id} 动态路由之后。FastAPI 把字符串 'reorder' 当作整数类型的 frame_id 进行匹配,直接返回了 422 错误:"unable to parse string as an integer"(无法将字符串解析为整数)。 |
要让 Evaluator 达到这种水准,背后花了不少调优功夫。开箱即用状态下的 Claude 其实是一个很糟糕的 QA 测试员。 在早期试跑中,我经常眼睁睁看着它明明查出了货真价实的 bug,接着却自己劝自己“这不算什么大问题”,然后大笔一挥通过验收;而且它往往只做走马观花的表面测试,不去探测边界情况,导致许多隐蔽 bug 轻易溜走。
我的调优闭环是:逐份阅读 Evaluator 的运行日志,找出它的判断与我产生分歧的案例,然后针对性地更新 QA 提示词来堵住这些漏洞。经过好几轮这样的迭代,Evaluator 的打分尺度才变得合理可靠。不过,当时产出的应用依然体现出模型 QA 能力的边界:细小的局部排版瑕疵、个别不够符合直觉的交互,以及深层嵌套功能里未被充分测到的隐蔽 bug,显然还有继续通过调优挖掘验证潜力的空间。但与核心功能直接瘫痪的单 Agent 版本相比,这套架构带来的质量提升非常明显。
迭代与做减法:当底层模型升级到 Opus 4.6
第一批 Harness 实验结果令人振奋,但它也过于庞大、缓慢且昂贵。顺理成章的下一步,就是在不牺牲产出质量的前提下寻找简化 Harness 的方法。
这既源于工程常识,也印证了一条更通用的原则:Harness 中的每一个组件,本质上都编码了一条关于“模型自己做不到什么”的假设;而这些假设非常值得反复做压力测试——既因为它们当初可能就判断失误,更因为随着模型能力快速迭代,这些假设很快就会过期失效。 我们在《构建高效的 Agent(Building Effective Agents)》一文中曾将这一核心思想总结为:“寻找尽可能简单的方案,只在确有必要时才增加复杂度。”对于任何维护 Agent Harness 的工程师来说,这条规律都会反复应验。
在第一次尝试做减法时,我大刀阔斧地砍掉了大半个 Harness 并塞入了几项新奇构想,结果却无法复现原版的质量表现;更糟的是,由于一次改了太多地方,我很难分清原架构里究竟哪些组件才是真正承重的核心支柱(Load-bearing),以及它们各自起到了什么作用。吸取这次教训后,我改用了更系统的方法:每次只移除一个组件,观察并评估它对最终产物的影响。
就在我推进这轮简化迭代期间,我们发布了 Claude Opus 4.6,这给了我进一步削减 Harness 复杂度的充足理由。我们完全有理由期待 4.6 比 4.5 需要更少的外层脚手架。正如我们在 Opus 4.6 发布博客中所写:“Opus 4.6 规划更加周密,能够更持久地推进 Agent 任务,在大型代码库中运行得更加可靠,并且具备更强的代码审查与调试能力来捕捉自身错误。”同时,它在长上下文检索能力上也有大幅跃升——而这些,恰恰都是我们当初搭建那套重型 Harness 想要弥补的能力短板。
移除 Sprint 分段结构
我首先尝试彻底移除 Sprint(按功能分段冲刺)结构。此前设置 Sprint,是为了帮模型把大任务切碎成能保持连贯性的小块;鉴于 Opus 4.6 的长程执行能力大幅增强,完全有理由相信模型原生就能一口气扛下整个构建任务,无需再做人为切分。
与此同时,我保留了 Planner 与 Evaluator,因为这两个角色依然在持续提供显而易见的价值:
- 如果去掉 Planner,Generator 就会在需求范围上缩水(Under-scope):直接拿到原始的一句话提示词后,它不先做全局规划就闷头开写,最终做出来的应用在功能丰富度上远不如经过 Planner 扩展后的版本。
- 去掉 Sprint 结构后,我将 Evaluator 从“每个 Sprint 评审一次”改为在整个构建结束时集中做一轮端到端验收(Single Pass)。
由于底层模型变强了,Evaluator 在不同任务中的“承重程度”也随之发生了变化——它的价值取决于当前任务相对于“模型单枪匹马能可靠完成的边界”处于什么位置:
- 在 Opus 4.5 时代,这道能力边界离我们很近:我们要构建的全栈应用正好卡在 Generator 独自发挥的极限边缘,因此 Evaluator 在整个构建过程中每一轮都能抓出大量关键问题;
- 到了 Opus 4.6 时代,模型的原生能力大幅向外扩张。许多过去必须靠 Evaluator 盯防才能连贯实现的功能,现在 Generator 自己就能一次性写对;对于落在这道边界以内的常规任务,频繁调用 Evaluator 就变成了多余的开销。但在那些依然处于 Generator 能力边缘的复杂模块上,Evaluator 依然能提供实打实的质量抬升。
这带来的实战启示非常明确:是否引入独立 Evaluator 并不是一个非黑即白的死规矩;只有当目标任务的复杂度超出了当前模型单靠自己稳定发挥的边界时,Evaluator 的额外成本才物有所值。
除了结构上的精简,我还补充了专门的提示词,用来改进 Harness 在所生成应用内部集成 AI 功能的方式——具体来说,就是指导 Generator 在应用里构建一个真正的内置 Agent,让它能够通过调用工具(Tools)来驱动应用自身的各项功能。这一块花了不少迭代功夫,因为相关的 Agent 编排知识非常新,Claude 训练数据里的覆盖相对较薄;但经过充分调优后,Generator 已经能够稳健地构建出具备工具调用能力的内置 Agent 了。
精简版 V2 Harness 实测:浏览器端数字音频工作站(DAW)
为了检验更新后的 V2 Harness,我使用下面这句提示词,让它生成一个基于浏览器的数字音频工作站(DAW,Digital Audio Workstation——用于作曲、录音、编曲和混音的专业音乐制作软件):
Build a fully featured DAW in the browser using the Web Audio API.

# 中文提示词对应写法:
# 使用 Web Audio API 在浏览器中构建一个功能完备的数字音频工作站(DAW)。
这次运行依然耗时不短且成本可观,总计运行了约 4 个小时,消耗了约 $124 的 Token 成本。但其中绝大部分时间都花在了主构建阶段(Builder):在完全没有 Opus 4.5 时代那种 Sprint 切分的情况下,Generator 保持高度连贯地连续编写了超过两个小时的代码。
各阶段的耗时与成本明细如下表所示:
| 阶段与角色(Agent & Phase) | 运行时长(Duration) | 成本(Cost) | | --- | --- | --- | | 规划阶段(Planner) | 4.7 分钟 | $0.46 | | 构建阶段(第 1 轮 Build) | 2 小时 7 分钟 | $71.08 | | 质量验收(第 1 轮 QA) | 8.8 分钟 | $3.24 | | 构建修复(第 2 轮 Build) | 1 小时 2 分钟 | $36.89 | | 质量验收(第 2 轮 QA) | 6.8 分钟 | $3.09 | | 构建修复(第 3 轮 Build) | 10.9 分钟 | $5.88 | | 质量验收(第 3 轮 QA) | 9.6 分钟 | $4.06 | | V2 Harness 总计 | 3 小时 50 分钟 | $124.70 |
与上一版 Harness 一样,Planner 先把一行提示词扩展成了完整的产品规格书。从运行日志中可以看到,Generator 模型在应用架构规划、内置 AI Agent 设计、前后端接线以及移交 QA 前的自测上都表现得相当出色。
尽管如此,独立的 QA Agent(Evaluator)依然抓出了非常关键的真实缺口。在第一轮验收反馈中,它直针见血地指出:
This is a strong app with excellent design fidelity, solid AI agent, and good backend. The main failure point is Feature Completeness — while the app looks impressive and the AI integration works well, several core DAW features are display-only without interactive depth: clips can't be dragged/moved on the timeline, there are no instrument UI panels (synth knobs, drum pads), and no visual effect editors (EQ curves, compressor meters). These aren't edge cases — they're the core interactions that make a DAW usable, and the spec explicitly calls for them.

# 中文反馈翻译:
# 这是一款底子很强的应用,具有出色的设计还原度、扎实的内置 AI Agent 和良好的后端实现。目前最主要的不合格项在于“功能完整度(Feature Completeness)”——虽然应用外观令人印象深刻且 AI 集成运行良好,但好几项核心 DAW 功能目前只是“纯静态展示(display-only)”,缺乏真正的交互深度:音频片段(clips)无法在时间轴上拖拽移动,缺少乐器控制面板(合成器旋钮、鼓机打击垫),也没有可视化的效果器编辑界面(均衡器 EQ 曲线、压缩器电平表)。这些绝非边缘情况,而是让一款 DAW 真正可用的核心交互,且产品规格书中已明确要求实现它们。
到了第二轮验收反馈,QA 再次抓出了几处尚未补齐的功能缺口:
Remaining gaps:
- Audio recording is still stub-only (button toggles but no mic capture)
- Clip resize by edge drag and clip split not implemented
- Effect visualizations are numeric sliders, not graphical (no EQ curve)

# 中文反馈翻译:
# 剩余未达标缺口:
# - 音频录制功能目前仍只是空壳桩代码(按钮能切换状态,但没有真正采集麦克风音频输入)
# - 拖拽片段边缘调整长度与片段切分(split)功能尚未实现
# - 效果器可视化目前只有数字滑块,缺少图形化界面(没有绘制 EQ 均衡曲线)
这清楚地表明:如果完全放任 Generator 自己发挥,它依然倾向于在细节上偷懒,或者用空壳桩代码(Stub)应付复杂功能;而独立的 QA 评估者在揪出这些“最后一公里”的功能缺口、督促 Generator 把交互真正做实方面,依然发挥着不可替代的价值。
根据最初的提示词,我期望得到的是一款能够让我创作旋律、和声与鼓点节奏,将它们编排成完整曲目,并能随时请内置 Agent 搭把手的音乐制作程序。最终跑出来的应用虽然距离专业级商业编曲软件还有很大差距,内置 Agent 的作曲音乐素养也显然还有很大的提升空间(况且 Claude 本身并不能真正“听”见声音,这使得 QA 反馈循环在音乐审美层面的作用受限),但它已经具备了一款可用音乐制作软件的全部核心模块:浏览器里真正可运行的编曲时间轴视图(Arrangement View)、混音台(Mixer)以及播放传输控制栏(Transport)。
更令人兴奋的是,我完全通过自然语言提示词就拼出了一小段歌曲小样:内置 Agent 自动设定了曲速(Tempo)与调性(Key),铺好了主旋律,编写了鼓组轨道,调整了混音台各轨音量电平,并加上了混响效果(Reverb)。音乐创作所需的核心原语(Primitives)一应俱全,而且内置 Agent 能够自主调用工具驱动这些原语,端到端地完成一段简单作品的编曲制作。也许可以说它现在还不够“音准完美(pitch-perfect)”,但方向已经非常清晰了。
下一步演进方向
随着模型能力持续演进,我们完全可以预期它们将能够连续工作更长时间、胜任更加复杂的任务。在某些场景下,这意味着包裹在模型外层的脚手架(Scaffold)会随着时间推移变得不再那么重要——开发者有时只需等待下一代模型发布,原本棘手的问题就会迎刃而解。但从另一个角度看,底层模型越强,我们通过设计 Harness 去挑战“单模型基线无法企及的复杂任务”的空间反而越大。
基于这一认识,这项研究中有几条经验值得我们长期坚持:
- 针对你实际使用的模型做实验与追踪分析:阅读模型在真实复杂问题上的完整执行轨迹(Traces),针对目标结果持续调优它的表现,而不是停留在纸面假设上。
- 面对超大型复杂任务时,善用任务拆解与专项角色分工:把规划、生成与独立评估拆给专门的 Agent,往往能榨取出单会话无法企及的质量上限。
- 每当新一代模型发布时,重新审视并精简你的 Harness:果断拆掉那些已经不再承重的旧脚手架,同时把节省下来的复杂度预算投入到新模块上,去解锁上一代模型根本不可能完成的新能力。
经过这一系列探索,我更加确信:有趣的 Harness 组合空间并不会随着模型变强而萎缩;相反,这道边界一直在向外移动,而 AI 工程师最迷人的工作,就是站在不断前移的能力前沿,持续寻找下一个突破性的架构组合。
附录:Planner Agent 生成的产品规格书示例
下面是复古游戏制作工具实测中,由 Planner Agent 根据一句话提示词自动展开的产品规格书节选(原文加粗与结构保留,附中文对照说明):
RetroForge - 2D Retro Game Maker

Overview
RetroForge is a web-based creative studio for designing and building 2D retro-style video games. It combines the nostalgic charm of classic 8-bit and 16-bit game aesthetics with modern, intuitive editing tools—enabling anyone from hobbyist creators to indie developers to bring their game ideas to life without writing traditional code.

The platform provides four integrated creative modules: a tile-based Level Editor for designing game worlds, a pixel-art Sprite Editor for crafting visual assets, a visual Entity Behavior system for defining game logic, and an instant Playable Test Mode for real-time gameplay testing. By weaving AI assistance throughout (powered by Claude), RetroForge accelerates the creative process—helping users generate sprites, design levels, and configure behaviors through natural language interaction.

RetroForge targets creators who love retro gaming aesthetics but want modern conveniences. Whether recreating the platformers, RPGs, or action games of their childhood, or inventing entirely new experiences within retro constraints, users can prototype rapidly, iterate visually, and share their creations with others.

Features
1. Project Dashboard & Management
The Project Dashboard is the home base for all creative work in RetroForge. Users need a clear, organized way to manage their game projects—creating new ones, returning to works-in-progress, and understanding what each project contains at a glance.

User Stories: As a user, I want to:

- Create a new game project with a name and description, so that I can begin designing my game
- See all my existing projects displayed as visual cards showing the project name, last modified date, and a thumbnail preview, so that I can quickly find and continue my work
- Open any project to enter the full game editor workspace, so that I can work on my game
- Delete projects I no longer need, with a confirmation dialog to prevent accidents, so that I can keep my workspace organized
- Duplicate an existing project as a starting point for a new game, so that I can reuse my previous work

Project Data Model: Each project contains:

Project metadata (name, description, created/modified timestamps)
Canvas settings (resolution: e.g., 256x224, 320x240, or 160x144)
Tile size configuration (8x8, 16x16, or 32x32 pixels)
Color palette selection
All associated sprites, tilesets, levels, and entity definitions

...

# 中文对照说明:
# RetroForge —— 2D 复古游戏制作工具
#
# 一、产品概览(Overview)
# RetroForge 是一个基于 Web 的创意工作室,用于设计和构建 2D 复古风格电子游戏。它将经典 8 位与 16 位游戏美学的怀旧魅力与现代直观的编辑工具结合在一起,让从业余爱好者到独立开发者的任何人,无需编写传统代码就能把游戏创意变为现实。
# 平台提供四大集成创作模块:用于设计游戏世界的网格图块关卡编辑器(Level Editor)、用于绘制视觉素材的像素精灵编辑器(Sprite Editor)、用于定义游戏逻辑的可视化实体行为系统(Entity Behavior),以及用于实时试玩的即时测试模式(Playable Test Mode)。通过将 Claude 驱动的 AI 辅助能力贯穿全流程,RetroForge 显著加速了创作过程——帮助用户通过自然语言交互生成像素精灵、设计关卡并配置行为逻辑。
#
# 二、功能模块(Features)
# 1. 项目仪表盘与管理(Project Dashboard & Management)
# 用户故事(User Stories):作为一名用户,我希望能够:
# - 创建一个带有名称和描述的新游戏项目,以便开始设计我的游戏
# - 以可视化卡片形式查看所有现有项目(展示项目名称、最后修改日期与缩略图预览),以便快速找到并继续之前的工作
# - 打开任意项目进入完整的游戏编辑器工作区
# - 删除不再需要的项目(带二次确认弹窗以防误删),保持工作区整洁
# - 复制现有项目作为新游戏的起点,复用已有工作成果
#
# 项目数据模型(Project Data Model):每个项目包含:
# - 项目元数据(名称、描述、创建与修改时间戳)
# - 画布设置(分辨率:如 256x224、320x240 或 160x144)
# - 图块尺寸配置(8x8、16x16 或 32x32 像素)
# - 调色板选择
# - 所有关联的精灵、图块集、关卡与实体定义
# ……
作者与致谢
特别感谢 Mike Krieger、Michael Agaby、Justin Young、Jeremy Hadfield、David Hershey、Julius Tarng、Xiaoyi Zhang、Barry Zhang、Orowa Sidker、Michael Tingley、Ibrahim Madha、Martina Long 与 Canyon Robbins 对本项研究工作的贡献。同时也感谢 Jake Eaton、Alyssa Leonard 与 Stef Sequeira 在本文成稿过程中提供的帮助。