 Anthropic 团队
随着 AI Agent 的能力越来越强,开发者开始把越来越复杂的任务交给它们——有些任务甚至需要连续运转几个小时乃至好几天。然而,如何让 Agent 在跨越多个上下文窗口(Context Window,模型单次对话能同时记住和处理的最大文本容量)时依然保持稳定、连贯的推进节奏,至今仍是一个亟待解决的难题。
长时间运行 Agent 的核心挑战在于,它们必须在一段段相互独立的会话(Session)中工作,而每一次新会话启动时,模型对上一轮会话发生的事情都毫无记忆。你可以想象这样一个软件项目:开发团队实行轮班制,但每一位接班上岗的工程师走进办公室时,脑子里都没有上一班同事留下的任何记忆。由于上下文窗口的容量有限,而绝大多数复杂项目又不可能在单个窗口内一气呵成,Agent 必须有一套跨越不同编码会话的「交接桥梁」。
为了让 Claude Agent SDK 能够在跨越多个上下文窗口时持续高效运转,我们设计了一套双阶段方案:先由一个**初始化 Agent(Initializer Agent)在首次运行时搭好底层环境,再由一个编码 Agent(Coding Agent)**在后续的每一次会话中负责做出增量推进,并为下一轮会话留下清晰的工作产物。你可以在配套的快速上手示例仓库(Quickstart)中找到完整的代码实现。
导读:如何把这篇 Anthropic 官方实践用到你自己的日常开发中? 很多人用 Claude Code 或 Codex 做大项目时,最头疼的就是「聊到后半段上下文爆掉,新开一个窗口后 AI 既不知道前面改了哪、也不知道还剩多少活,甚至随便改两行就骗你说全部做完了」。Anthropic 在这篇工程复盘里给出的解法非常接地气,哪怕你不写 SDK 代码,也能立刻在本地照搬这套「交接班四件套」:
- 先列全量 JSON 清单(
feature_list.json):开工前先让 AI 把所有需求拆成带验收步骤的 JSON 条目,初始全部标为"passes": false,严禁删改题目;- 留好一键启动脚本(
init.sh)与交接日记(claude-progress.txt):省去新会话每次重新摸索怎么跑项目的时间;- 立下「每次只做一个功能 + 干净交班」铁律:每轮会话只挑一个未完成功能,做完必须提交 Git 并更新进度日记;
- 强制浏览器端到端自检:不准只跑
curl或单元测试就标为完成,必须用浏览器工具像真人一样点开页面走完流程。
长时间运行 Agent 的核心难题
Claude Agent SDK 是一个强大且通用的 Agent 运行框架(Harness,即包裹在模型外层、负责调度工具、管理上下文与执行环境的整套工程护栏),不仅擅长写代码,也能胜任其他需要调用工具收集上下文、做规划并付诸执行的任务。它本身具备上下文管理能力,比如上下文压缩(Compaction,当对话快要撑满上下文窗口时,自动将早期历史记录浓缩成摘要以腾出空间的机制),让 Agent 不会因为聊得太久而直接卡死。从理论上讲,有了这套机制,Agent 似乎应该能无限期地一直干下去,持续产出有效成果。
然而,光靠上下文压缩是远远不够的。在默认配置下,哪怕是像 Opus 4.5 这样最顶尖的编程模型,如果只给它一句笼统的高层提示词(例如「帮我做一个 claude.ai 的克隆版」),就让它在 Claude Agent SDK 上跨多个上下文窗口循环运行,最终依然无法交付出一个达到生产可用质量的 Web 应用。
在实验中,Claude 的翻车表现主要集中在以下两种典型模式:
第一种模式是,Agent 总是试图一口吃成个胖子——本质上就是想毕其功于一役(one-shot),一次性把整个应用全写出来。这往往会导致模型在功能写到一半时就耗尽了上下文窗口,留给下一轮会话的是一个只写了一半、且没有任何文档记录的烂摊子。接手的下一轮 Agent 只能靠猜去还原之前发生了什么,还得花大量时间先把跑不通的基础应用修好。即便开启了上下文压缩,这个问题依然会发生,因为自动压缩出来的摘要并不总能向下一任 Agent 传递足够清晰、准确的交接指令。
第二种失效模式则经常出现在项目进入中后期的时候。当一部分功能已经搭建完成后,后续接手的某个 Agent 实例环顾四周,看到代码库里已经有模有样、取得了一些进展,就会草率地宣布整个项目已经大功告成,提前收工。
这就把问题拆解成了两个层面:
首先,我们需要搭建一个初始环境,为提示词所要求的所有功能打下地基,从而引导 Agent 按部就班、逐个功能地往前推进。
其次,我们应该通过提示词要求每一个 Agent 在朝着目标做增量推进的同时,必须在每轮会话结束时让整个环境保持在**「干净状态(clean state)」**。这里说的「干净状态」,指的是代码随时达到了可以合并进主干分支(main)的标准:没有明显的严重 Bug,代码结构整洁且有清晰的记录;换句话说,下一位接手的开发者可以轻松开始开发新功能,而不需要先替前人收拾一堆毫无头绪的烂摊子。
在内部实验中,我们用一套分两步走的方案解决了这些问题:
- 初始化 Agent(Initializer Agent):第一轮 Agent 会话使用专门定制的提示词,要求模型先把初始环境搭建好——包括编写一个用于启动服务的
init.sh脚本、一份用来记录历次 Agent 工作日志的claude-progress.txt进度文件,以及一次展示初始新增文件的 Git 提交(git commit)。 - 编码 Agent(Coding Agent):随后的每一轮会话都要求模型只做增量推进,并在结束时留下结构化的进度更新(注:这里之所以把它们称为两个不同的 Agent,仅仅是因为它们各自接收的初始用户提示词不同;至于底层的系统提示词、工具集以及整体的 Agent Harness 框架,两者其实是完全一致的)。
这套做法最核心的洞察在于:找到一种办法,让带着全新空白上下文窗口启动的 Agent,能够迅速摸清当前的工作进展——而这正是靠 claude-progress.txt 进度文件配合 Git 提交历史共同实现的。说到底,这些做法的灵感,全部来自优秀的人类软件工程师每天在真实项目里遵循的工程习惯。
环境管理(Environment management)
在更新版的 Claude 4 提示词工程指南中,我们曾分享过一些针对多上下文窗口工作流的最佳实践,其中就包括「为第一个上下文窗口使用不同的专属提示词」的 Harness 结构。这份「不同的提示词」会指示初始化 Agent 把环境搭建妥当,配齐后续编码 Agent 高效工作所需的全部上下文。下面,我们就来深入拆解这样一个运行环境里的几个关键组件。
功能清单(Feature list)
为了解决 Agent 试图一次性写完整个应用、或者过早宣布项目完工的问题,我们在提示词中要求初始化 Agent 根据用户的初始需求,扩写出一份详尽完整的功能需求清单文件。以克隆 claude.ai 的项目为例,这份清单足足拆解出了 200 多个具体功能点,例如「用户可以打开新对话、输入提问、按下回车键,并看到 AI 生成的回复」。在初始状态下,所有这些功能点都会被统一标记为「未通过("passes": false)」,好让后续接手的编码 Agent 对「什么才叫完整实现全部功能」有一份一目了然的全景蓝图。
{
  "category": "functional",
  "description": "New chat button creates a fresh conversation",
  "steps": [
    "Navigate to main interface",
    "Click the 'New Chat' button",
    "Verify a new conversation is created",
    "Check that chat area shows welcome state",
    "Verify conversation appears in sidebar"
  ],
  "passes": false
}

// 中文说明(feature_list.json 中的单条功能验收结构及中文对应写法):
// {
//   "category": "functional",                              // 功能类别:功能性需求
//   "description": "点击新建对话按钮能够创建一个全新的会话",    // 功能点描述
//   "steps": [                                             // 端到端验收步骤:
//     "打开应用主界面",
//     "点击「New Chat(新建对话)」按钮",
//     "验证系统已创建出一个新的会话",
//     "检查聊天主区域是否正确显示欢迎状态",
//     "验证该会话已同步出现在左侧边栏列表中"
//   ],
//   "passes": false                                        // 验收状态:初始一律设为 false(未通过)
// }
我们在提示词中明确规定,编码 Agent 后续编辑这份文件时,只允许修改 passes 字段的状态值,并且使用了措辞非常严厉的指令,比如:「严禁删除或修改任何测试条目,因为这会导致功能缺失或遗留 Bug,是绝对不可接受的行为(It is unacceptable to remove or edit tests because this could lead to missing or buggy functionality)。」经过多轮实验对比,我们最终选定用 JSON 格式而不是 Markdown 格式来存这份清单——因为相比于 Markdown 文件,模型擅自乱改或覆盖破坏 JSON 文件结构的概率要低得多。
增量推进(Incremental progress)
搭好这套初始环境脚手架后,下一轮迭代启动的编码 Agent 会收到明确指令:每次只准挑一个功能点进行开发。事实证明,这种小步快跑的增量方式,对于克制 Agent 贪多嚼不烂的毛病至关重要。
即便已经按增量方式推进,模型在改完代码后把环境保持在「干净状态」依然非常关键。在实验中我们发现,激发这种良好习惯最有效的办法,就是要求模型把每一次进展都用带有清晰描述的提交说明(commit message)提交到 Git,同时在进度文件(claude-progress.txt)里写下本轮进展小结。这样一来,一旦后续改坏了代码,模型随时可以利用 Git 回滚(revert)错误的改动,迅速恢复到代码库之前正常可运行的状态。
这些做法也大幅提升了整体运行效率——因为新启动的 Agent 再也不需要费劲去猜上一轮到底干了什么,也不用浪费宝贵的时间和 Token 去抢修一个跑不起来的基础应用。
端到端测试(Testing)
我们观察到的最后一个常见翻车模式,是 Claude 往往会在没有经过充分测试的情况下,就草率地把某个功能标记为「已完成」。如果没有在提示词里做出明确要求,Claude 通常只会改完代码,最多跑一下单元测试、或者对着开发服务器敲一条 curl 命令测一下接口,却完全没有意识到这个功能在真实页面上根本跑不通端到端流程。
而在构建 Web 应用的场景下,只要我们在提示词里明确要求 Claude 调用浏览器自动化工具、完全像真实人类用户那样去执行所有测试操作,它在端到端功能验证上的表现就会好得多。
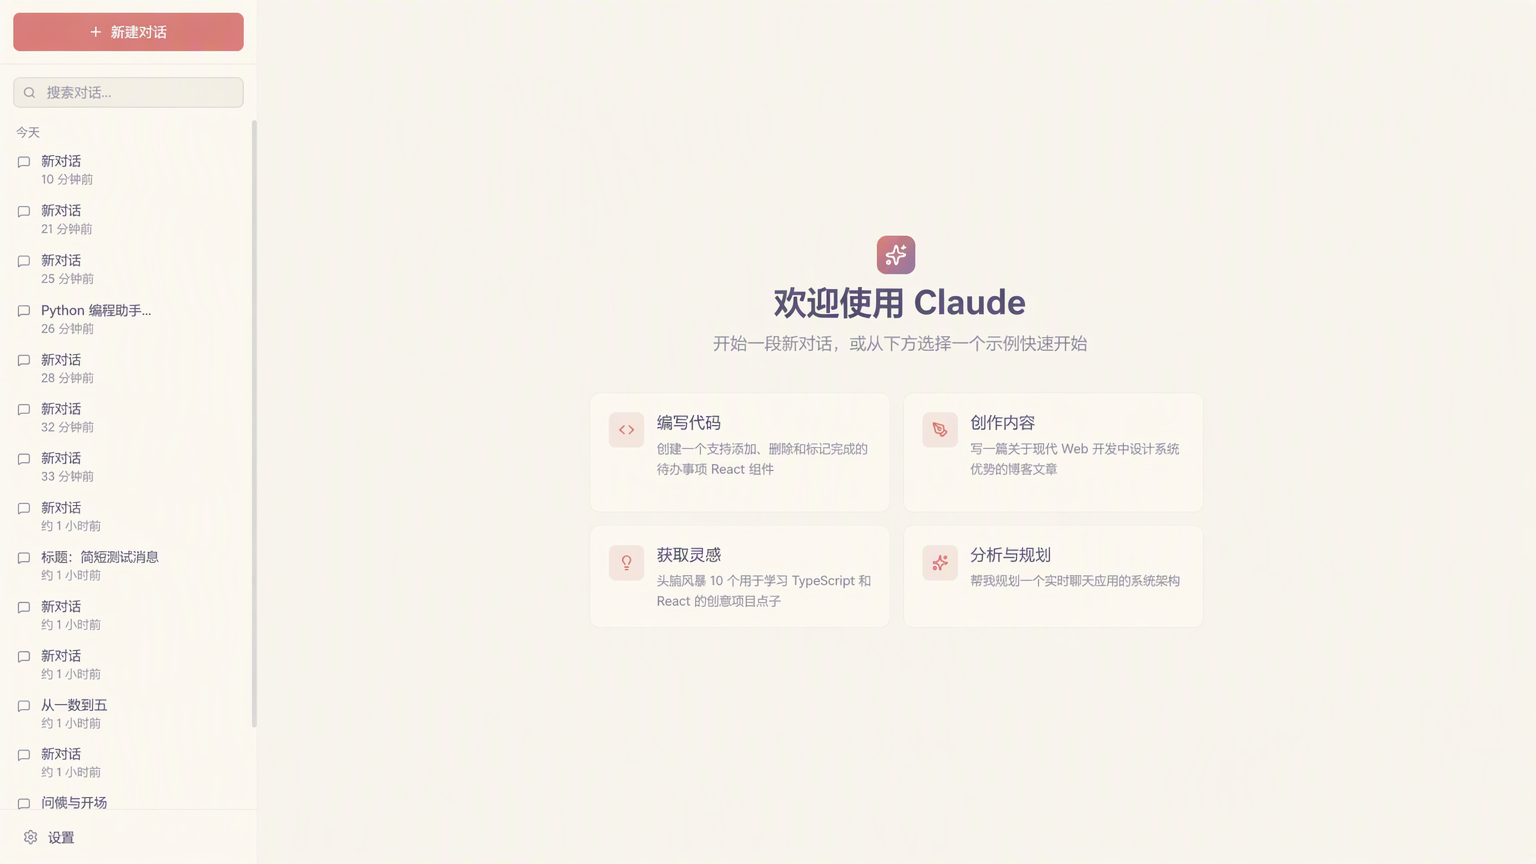
上图展示了 Claude 在测试 claude.ai 克隆应用时,通过 Puppeteer MCP 服务端(一种遵循模型上下文协议 MCP、让 Claude 能够直接驱动无头浏览器执行打开网页、点击按钮、输入文字和截屏操作的服务)拍摄的真实页面验证画面。
为 Claude 配备这类自动化测试工具后,整体交付质量得到了显著跃升,因为 Agent 能够亲眼抓出并修掉那些单看静态代码根本不易察觉的隐藏 Bug。
当然,目前仍然存在一些局限性:受限于 Claude 自身的视觉识别能力以及浏览器自动化工具的机制,它还很难做到百分之百捕捉所有类型的 Bug。举个例子,Claude 无法通过 Puppeteer MCP 看到浏览器原生的 alert 弹窗,因此依赖这类原生弹窗的功能模块,最终遗留 Bug 的概率就会明显偏高。
新会话如何快速进入状态(Getting up to speed)
当上述所有基础设施都就位后,每一个新启动的编码 Agent 都会在提示词的引导下,先按顺序走完一套标准动作来摸清现场情况——其中有些步骤虽然看起来非常基础,但在实战中却格外管用:
- 运行
pwd查看当前所在的工作目录。明确告知模型只能编辑该目录下的文件。 - 读取 Git 提交历史和进度文件(
claude-progress.txt),快速了解最近几轮会话刚刚完成了哪些工作。 - 读取功能清单文件(
feature_list.json),从中挑出当前优先级最高、且尚未完成的某一个功能开始动手。
这套固定动作能在每一轮会话中帮 Claude 省下不少 Token,因为它不需要从头摸索该怎么启动和测试代码。同时,让初始化 Agent 预先写好一个能一键拉起开发服务器的 init.sh 脚本,并要求编码 Agent 在动手写新功能之前先跑一遍基础的端到端冒烟测试,也会起到事半功倍的效果。
在克隆 claude.ai 的例子里,这意味着 Agent 每次开局都会先启动本地开发服务器,然后调用 Puppeteer MCP 新建一个对话、发送一条消息并确认收到回复。这一步能确保 Claude 第一时间发现应用是不是被上一轮会话留在了损坏状态;如果发现有问题,就立刻动手先把存量 Bug 修好。试想一下,如果 Agent 不做检查就直接在一个已经坏掉的代码库上硬写新功能,只会让问题雪上加霜、越改越乱。
有了这一整套规范,一次典型的编码 Agent 会话在开局时会呈现如下的执行轨迹:
[Assistant] I'll start by getting my bearings and understanding the current state of the project.
[Tool Use] <bash - pwd>
[Tool Use] <read - claude-progress.txt>
[Tool Use] <read - feature_list.json>
[Assistant] Let me check the git log to see recent work.
[Tool Use] <bash - git log --oneline -20>
[Assistant] Now let me check if there's an init.sh script to restart the servers.
<Starts the development server>
[Assistant] Excellent! Now let me navigate to the application and verify that some fundamental features are still working.
<Tests basic functionality>
[Assistant] Based on my verification testing, I can see that the fundamental functionality is working well. The core chat features, theme switching, conversation loading, and error handling are all functioning correctly. Now let me review the tests.json file more comprehensively to understand what needs to be implemented next.
<Starts work on a new feature>

# 中文说明(典型新会话的开局摸底与自检流程对照):
# [Assistant] 我先摸清当前的工作环境,了解项目的最新状态。
# [调用工具] <bash - pwd>                          # 1. 确认当前工作目录路径
# [调用工具] <read - claude-progress.txt>          # 2. 读取上一班 Agent 留下的进度交接日志
# [调用工具] <read - feature_list.json>            # 3. 读取全量功能验收清单
# [Assistant] 我来查看一下 Git 提交记录,看看最近完成了哪些工作。
# [调用工具] <bash - git log --oneline -20>        # 4. 查看最近 20 条 Git 提交历史
# [Assistant] 接下来检查是否有 init.sh 脚本可以用来重启服务。
# <执行脚本启动本地开发服务器>
# [Assistant] 太好了!现在我打开应用页面,先验证几项基础核心功能是否依然正常运转。
# <通过浏览器工具测试基础功能>
# [Assistant] 根据刚才的验证测试,基础功能运行良好:核心对话、主题切换、历史会话加载以及错误处理均工作正常。现在我来更全面地审阅测试清单文件,确定接下来要实现的下一个功能点。
# <正式开始开发某一个新功能>
Agent 常见失效模式与对应的解决方案
下表总结了长时间运行 AI Agent 最常见的四种失效模式,以及初始化 Agent 和编码 Agent 各自对应的解决动作:
| 常见失效问题(Problem) | 初始化 Agent 的动作(Initializer Agent Behavior) | 编码 Agent 的动作(Coding Agent Behavior) |
| --- | --- | --- |
| Claude 过早宣布整个项目已经完工。 | 建立功能清单文件:根据输入的规格要求,生成一份结构化的 JSON 文件,列出所有端到端功能描述与验收步骤。 | 每次会话开局先读取功能清单文件,从中只挑一个未完成的功能开始攻克。 |
| Claude 在结束会话时留下未修好的 Bug 或没有任何文档记录的半成品进度。 | 初始化 Git 代码仓库,并创建一份进度记录文件(claude-progress.txt)。 | 会话开始时先读取进度文件和 Git 提交日志,并在开发服务器上跑一遍基础测试以抓出未记录的遗留 Bug;会话结束时提交 Git 记录并更新进度文件。 |
| Claude 未经充分验证就草率地将功能标记为「已完成」。 | 建立结构化的功能清单文件(初始统一标为未通过)。 | 对所有功能进行端到端自检,只有在浏览器中严格测试通过后,才允许将该功能标记为 "passes": true。 |
| Claude 每次都要花大量时间重新摸索怎么启动和运行应用。 | 编写一个能够一键拉起开发服务器的 init.sh 启动脚本。 | 每次会话开局直接读取并执行 init.sh。 |
未来探索方向(Future work)
这项研究展示了在长时间运行的 Agent Harness 框架中,如何通过一套切实可行的工程机制,让模型在跨越多个上下文窗口时依然能稳步做出增量推进。不过,目前仍有几个开放性问题值得进一步探索。
最值得探讨的一点是:在跨上下文窗口的长周期任务中,究竟是让单个通用的编码 Agent 从头挑大梁表现最好,还是采用**多 Agent 协同架构(Multi-agent architecture)**能取得更优的效果?从直觉和工程经验来看,如果能拆分出专门的测试 Agent(Testing Agent)、质量保障 Agent(QA Agent)或代码清理重构 Agent(Code Cleanup Agent),让这些专精角色在软件开发生命周期的各个子任务上各司其职,很可能会比单打独斗做得更出色。
此外,本文展示的案例主要针对全栈 Web 应用开发做了专项优化。未来的另一个重要方向,是将这些经验推广到更广泛的领域。我们相信,这里总结出的相当一部分乃至全部工程经验,同样适用于科学研究、金融建模等其他需要 Agent 长时间自主运转的复杂任务场景。
致谢(Acknowledgements)
本文由 Justin Young 撰写。特别感谢 David Hershey、Prithvi Rajasakeran、Jeremy Hadfield、Naia Bouscal、Michael Tingley、Jesse Mu、Jake Eaton、Marius Buleandara、Maggie Vo、Pedram Navid、Nadine Yasser 以及 Alex Notov 为本项目做出的贡献。
这项成果凝聚了 Anthropic 内部多个团队的共同努力,正是他们让 Claude 能够安全、可靠地开展长周期自主软件工程,尤其要感谢代码强化学习(Code RL)团队与 Claude Code 团队。