 Manus 团队
在 Manus 项目刚起步时,我和团队面临一个决定生死的路线抉择:我们到底应该基于开源基础模型自己从头训练一个专属的 Agent 模型,还是不动模型参数,直接建立在前沿大模型的上下文学习(In-Context Learning)能力之上来构建 Agent?
所谓的「上下文学习」,指的是不重新训练模型修改权重,光靠往对话窗口(Context)里塞入清晰的指令、环境信息和参考示例,让大模型在推理时直接「现学现卖」完成新任务。
回想我做自然语言处理(NLP)的前十年,我们根本没有这样选择的福气。在遥远的 BERT 时代(没错,已经过去七年了),那时候的技术范式是「预训练 + 微调(Fine-tuning)」——每想让模型干一件新活,都必须先收集标注数据、微调修改模型参数、再跑一轮评估。哪怕当时的模型体积跟今天的大语言模型相比小得可怜,跑完一轮迭代也动辄需要好几个星期。
对于需要快速试错的应用来说——尤其是在产品还没找到真实市场需求(即 PMF,Product-Market Fit)之前——几周才能迭代一次是致命的。这是我在上一段创业经历中花真金白银买来的惨痛教训:当时我为了做开放信息抽取(Open Information Extraction,即从普通文章里自动提取「谁对谁做了什么」的结构化信息)和语义搜索,从头训练了一套内部专属模型。结果没过多久,GPT-3 和 Flan-T5 横空出世——它们证明了超大规模模型只需要看几条提示词或自然语言指令,就能直接跨任务泛化。我苦心训练的内部小模型一夜之间沦为了废铁。但颇具戏剧性的是,正是这批淘汰了旧做法的大模型,开启了「上下文学习」的新纪元,也为我们指明了一条全新的出路。
这段刻骨铭心的教训,让我们毫不犹豫地做出了选择:Manus 将全仓押注上下文工程(Context Engineering)。 这让我们能够以「小时」而非「周」为单位上线改进,并且让我们的产品架构不再跟某一个特定底层模型死死绑在一起:如果底层模型能力的演进是一场不断上涨的潮水,我们希望 Manus 是水面上借着潮水往上漂的船,而不是死死钉在海床上的石柱。
不过,真正动手做起来就会发现,上下文工程远没有听上去那么简单。它是一门彻头彻尾的实验科学——在做 Manus 的过程中,我们已经推倒重写了四次 Agent 框架,每一次重写,都是因为摸索出了更好的上下文组织方式。
在机器学习里,算法自动寻找最优参数的过程叫「随机梯度下降(Stochastic Gradient Descent,简称 SGD)」;而我们把这种靠工程师手动搜索架构、反复调整提示词、凭经验试错的过程,半开玩笑地称为「随机研究生下降(Stochastic Graduate Descent,同样简称 SGD)」。这个办法虽然不够优雅,但确实管用。
这篇文章分享的就是我们通过自己的「人肉 SGD」摸索出的六条局部最优解。为了让不熟悉大模型底层推理机制的朋友也能一眼看懂,我们在翻译原文的同时,也把文中涉及的所有底层机制、论文与技术概念直接揉进正文做了通俗拆解。如果你也在构建或使用 AI Agent,希望这些原则能帮你更快少走弯路。
导读:如何把 Manus 的六条上下文工程经验与全站方法论串联起来? 如果说 Anthropic 官方的《AI Agent 的高效上下文工程》从注意力预算出发搭起了理论总纲,那么 Manus 首席科学家季逸超(Peak)写的这篇复盘,就是一份极高密度的生产级 Agent 架构避坑指南。全篇六个章节其实只回答了四个最实际的工程问题:
- 怎么省下 90% 的时间和账单(第 1、2 节):为什么 Agent 的输入与输出 Token 比例高达
100:1?为什么在系统提示词开头放一个秒级时间戳、或者在中途动态删减工具,会让账单直接暴涨 10 倍?读懂 KV 缓存(复用上文计算结果) 与 提前写好回复开头(Response Prefill),你就能彻底明白为什么我们在《从 0 到 1 了解什么是 Skill》里强调「开头工具固定不动,靠末尾读文件按需加载」。- 怎么突破上下文窗口的容量极限(第 3 节):128K 甚至更长的窗口在面对网页与 PDF 时依然不够用。Manus 把沙盒文件系统当成「可恢复的外部记忆(上下文里只留 URL 或文件路径,用时再读)」,这与 Anthropic 在《为长时间运行的 Agent 构建高效 Harness》和 OpenAI 在《Harness Engineering》中用本地文件保存状态的思路完全一致。
- 怎么防止长任务跑到一半忘掉初心(第 4 节):一个任务平均调用 50 次工具,怎么防止模型跑偏?Manus 让 Agent 不断更新
todo.md,本质上是把全局目标反复写到上下文的最末尾,利用模型对最近文字最敏感的特性提醒自己别跑偏。- 怎么让 Agent 学会自己排错、不犯傻复读(第 5、6 节):工具报错时千万别在后台偷偷删掉报错记录重跑,留着报错现场才能让模型绕开死胡同;而在连审 20 份简历这类重复任务时,则要在返回格式里故意加一点小变化,防止模型被自己前面的历史记录带进机械复读的死循环。
1. 围绕 KV 缓存进行设计:为什么改一个时间戳,账单会贵 10 倍?
如果非要我在生产级 AI Agent 中只挑一个最重要的核心指标,我会毫不犹豫地选择 KV 缓存命中率(KV-cache hit rate)。因为它直接决定了你的 Agent 跑得快不快(延迟 Latency)、账单贵不贵(成本 Cost)。
为什么缓存命中率对 Agent 这么要命?我们先看看一个典型的 Agent(基于 ReAct 循环范式) 是怎么干活的:
普通聊天机器人是「你问一句,它答一大段话」,一轮就结束了;但 Agent 收到你的任务后,需要自己调一连串工具来干活。在每一轮循环(Iteration)里:
- 模型先读一遍当前的完整上下文,从工具箱(动作空间 Action Space)里挑出一个动作(Action,比如在命令行跑一条命令);
- 这个动作在外部环境(比如 Manus 的云端虚拟机沙盒)里执行,返回一段执行结果(观察结果 Observation,比如终端输出的日志);
- 系统把这一轮的「动作」和「观察结果」追加拼到原有上下文的末尾,作为下一轮循环的输入,让模型接着决定下一步干什么,如此循环往复直到任务完成。
你可以想象,随着步数一步步推进,塞给模型的上下文雪球会越滚越大(第 30 轮请求时,要把前 29 轮的所有历史记录全发过去);但模型每一步吐出来的输出,通常只是一行简短的工具调用指令。
在大模型底层推理中,这对应着两个完全不同的计算阶段:
- 预填充阶段(Prefilling):模型把你传进去的那一大长串输入上下文一次性读完算好,准备吐出第一个字(这一步的耗时叫 TTFT,首字延迟);
- 解码阶段(Decoding):模型顺着往下,一个字一个字地生成回答。
普通聊天是「输入短、输出长」;而 Agent 恰恰相反,是极端的「超长输入、极短输出」。以 Manus 为例,平均输入 Token 与输出 Token 的比例高达 100:1!也就是说,如果你不做优化,模型 99% 的算力和你的钱,其实都花在「每一轮把前面几十轮一模一样的历史记录重新读一遍」上了。
好消息是,大模型推理有一个省钱提速的神器叫 KV 缓存(KV-Cache,键值缓存)。原理其实很好懂:大模型在读输入文本时,会为每一个词(Token)算出一组注意力特征向量(Key 和 Value)。如果下一轮发过来的长上下文,前半截内容(前缀 Prefix)跟上一轮一字不差,模型服务商根本不需要重新计算,直接从显存里把上一轮算好的 KV 缓存拿过来复用,只计算末尾刚追加上去的那一丁点新内容即可!
无论你是自己用显卡部署开源模型,还是调商业 API,KV 缓存都能大幅砍掉首字等待时间(TTFT)和推理成本。而且省下的绝不是小钱:以 Claude Sonnet 为例,命中缓存的输入 Token 只要 0.30 美元 / 百万 Token,而没命中缓存则要 3 美元 / 百万 Token——价格相差整整 10 倍。
那么,为什么很多人的 Agent 吃不到这 10 倍的缓存红利?这就要说到大模型底层的自回归(Autoregressive)特性了。
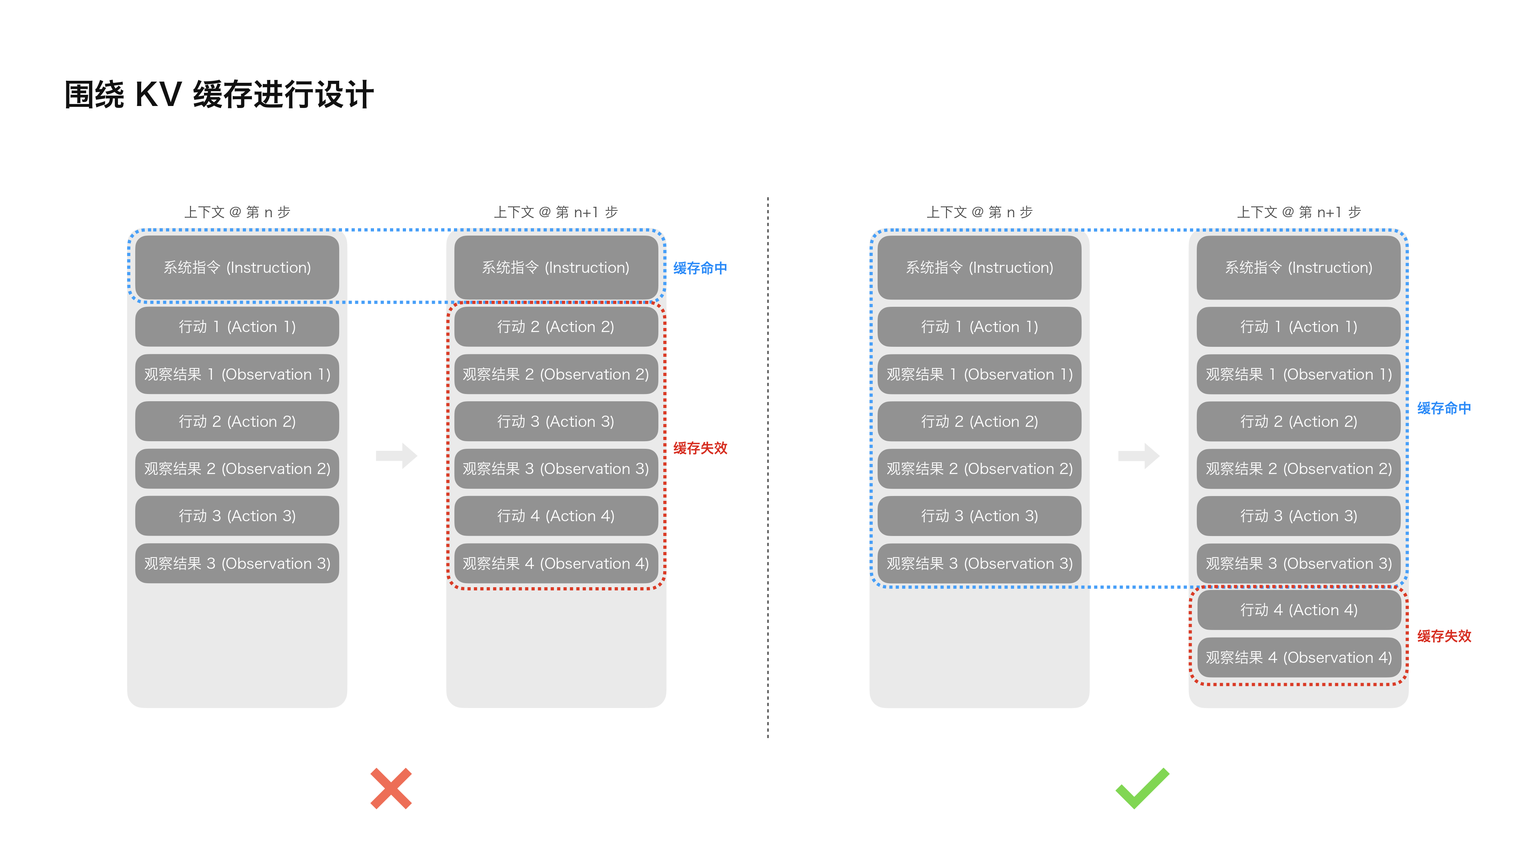
在自回归模型里,后面每一个词的计算结果,都严格依赖它前面出现过的所有词——就像一排首尾相连的多米诺骨牌。只要上下文里某一个位置的词变了(哪怕只改了 1 个标点或 1 个数字),从这个位置往后的所有缓存就会像多米诺骨牌一样全部倒塌作废(Cache Miss)!(如图 1 左半边所示,一旦前面的内容发生变动,后面红框里的整段历史就全部缓存失效,必须重新花 10 倍的钱重算一遍。)
因此,在上下文工程中想要保住 KV 缓存命中率,必须死守以下三条铁律:
1. 保持提示词前缀绝对稳定(千万别在开头塞动态时间戳)
新手最常踩的一个大坑,就是在系统提示词(System Prompt)的最开头写上一句动态的当前时间——尤其是精确到秒的时间戳(比如 Current time: 2025-07-18 14:20:05)。这样做虽然能让模型知道现在是几点几分几秒,但代价是:Agent 每一轮发请求时,提示词的第一行都在变!第一行一变,后面几万字的缓存直接全军覆没,你的缓存命中率瞬间归零。
2. 让上下文严格保持「只往后追加(Append-only)」,且字段排列顺序固定
永远只在上下文末尾往后追加新的动作和结果,绝不要回头去修改或删减前几轮已经发生过的历史记录(如图 1 右半边所示,前 $n$ 步纹丝不动,只有第 $n+1$ 步末尾新增的两块需要计算)。
同时,必须确保代码中把数据转成文本(序列化 Serialization)时,生成的文本格式每次都完全一致。这是一个极隐蔽的工程坑:很多编程语言在处理 JSON 对象时,默认并不保证字段名(Key)的排列顺序固定。如果同一条历史记录在上一轮转成字符串是 {"url": "...", "status": 200},下一轮变成了 {"status": 200, "url": "..."},虽然意思完全一样,但对按字匹配的 KV 缓存来说前缀已经变了,缓存就会在不知不觉中被击穿。
3. 手动标记缓存位置,并把同一会话固定分给同一台服务器
有些模型接口(比如 Anthropic Claude API)默认不会自动缓存整段对话,而是需要你在请求里手动给消息块加上「缓存断点(Cache Breakpoints,如 cache_control 字段)」标记,告诉服务端把截至该位置的前缀缓存起来。在打标记时要考虑缓存的过期时间,除了随着轮次推进把标记往后移,至少也要在系统提示词的末尾稳稳锁住一个缓存点。
另外,如果你用 vLLM 这类开源推理引擎自己部署模型,除了要在配置里打开前缀缓存(Prefix Caching)开关,还必须在负载均衡层根据会话 ID(Session ID)把同一个 Agent 任务的几十轮请求固定分发到同一台 GPU 服务器上。否则上一轮的缓存存在机器 A 的显存里,下一轮请求被随机分发到了机器 B,缓存照样落空。
2. 遮蔽,而非移除:工具太多让 Agent 变蠢时,为什么不能中途删工具?
随着你的 Agent 功能越来越丰富,它的动作空间(Action Space)自然会越来越庞大——说白了,就是挂在身上的工具(Tools)数量爆炸了。
最近大火的 MCP(模型上下文协议) 更是火上浇油。如果你在产品里允许用户自由挂载第三方 MCP 工具,请相信我:一定会有用户把成百上千个名字古怪、说明冗长的工具一股脑塞进你原本精心调好的动作空间里。结果就是,模型面对几百个相似工具瞬间挑花了眼,选错工具或者绕远路的概率直线上升。简而言之,把 Agent 武装到牙齿,反而会让它变蠢。
遇到这个问题,大家最自然的想法就是设计一个「动态工具箱」——比如借鉴 RAG(检索增强生成) 的思路:用户这一步要查网页,我就只把浏览器相关的 5 个工具塞进提示词;下一步要改代码,我就把浏览器工具删掉,换成文件读写工具。
我们在 Manus 里也试过这个方案。但实测结果给了我们当头一棒,也让我们总结出了一条铁律:除非万不得已,否则绝对不要在 Agent 循环的中途动态添加或删除工具定义。 原因主要有两个:
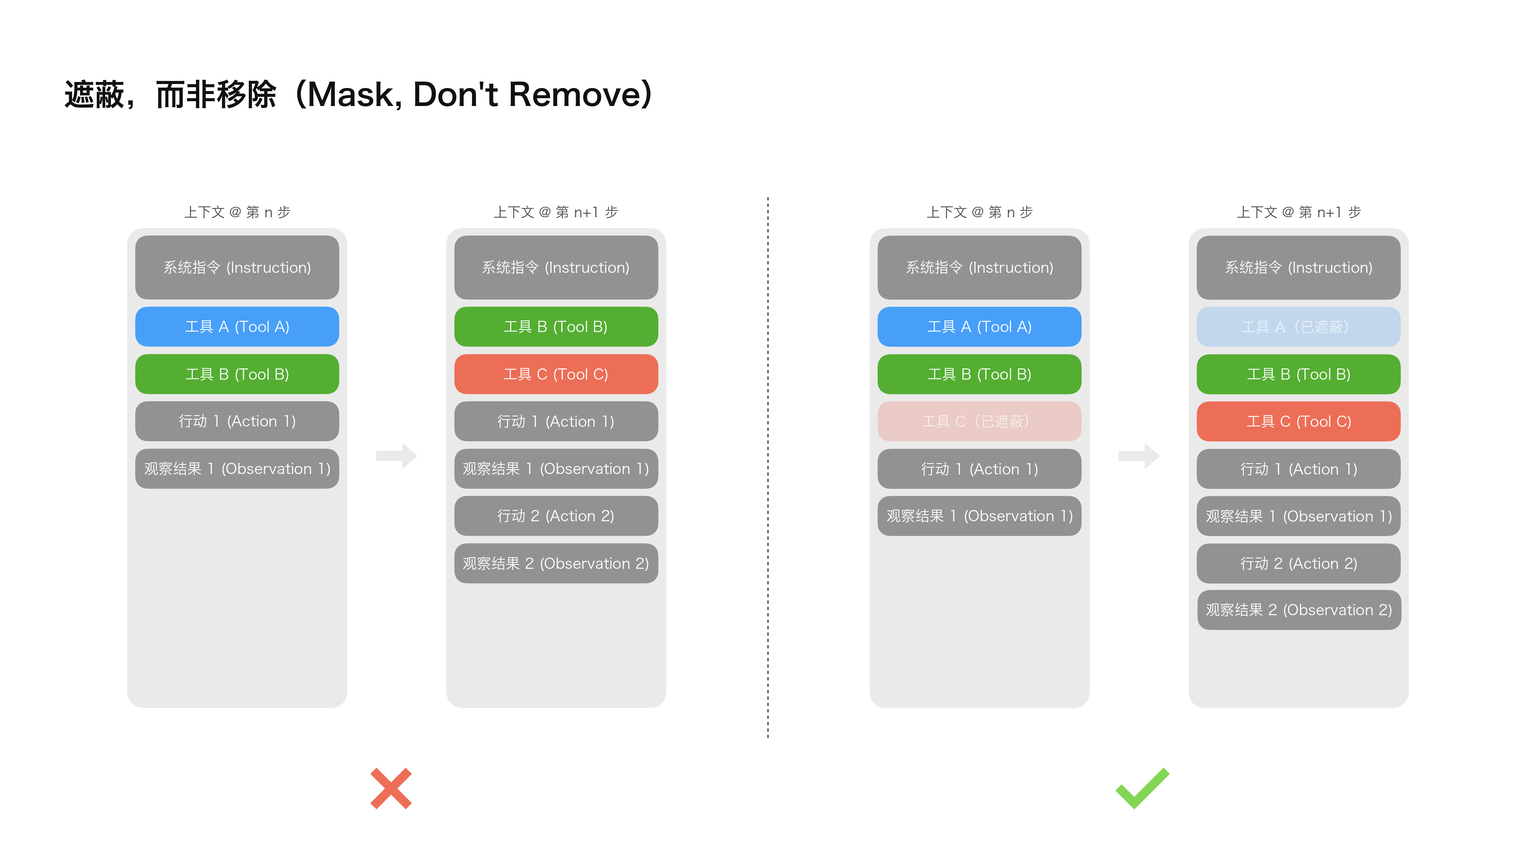
- 直接击穿整条 KV 缓存:在绝大多数大模型里,所有工具的定义说明(Tool Definitions)在拼接到上下文时,都排在最前面(紧挨着系统提示词)。根据我们上一节刚讲过的多米诺骨牌原理,如果你在第 10 轮把排在开头的
Tool A删了、换成了Tool C(如图 2 左半边所示),那么排在工具列表后面的前 9 轮历史记录的 KV 缓存就会全部作废! - 让模型陷入前后矛盾与幻觉:当前面第 3 轮的历史记录里明明还写着「我调用了
Tool A并拿到了结果」,到了第 4 轮,你把Tool A的定义从开头删掉了——模型回头看历史里有这个工具,抬头看工具说明书里却没有它,很容易当场陷入混乱。如果没有配置严格的结构化约束解码(Constrained Decoding,即强制模型只能按指定 JSON 格式输出的机制),模型就会开始传错参数格式,甚至凭空捏造根本不存在的幻觉工具。
那怎么做到既保证开头的工具列表一个字都不改(100% 保住 KV 缓存),又能在每一步精准限制模型只能选哪些工具?
Manus 的解法是:「遮蔽,而非移除(Mask, Don't Remove)」——所有工具的定义从头到尾稳稳留在上下文里不动(如图 2 右半边所示,Tool A/B/C 的位置始终固定),但外围代码会维护一个感知当前阶段(比如「刚收到用户新消息」或「正处于浏览器操作子流程」)的有限状态机(State Machine),在模型张嘴生成回答的那一瞬间,把当前不该用的工具「捂住(遮蔽 Token Logits)」,让模型选不到它。
这里可能有些朋友会好奇:到底什么是「遮蔽 Token Logits」?在调大模型 API 时具体是怎么做到的?
其实原理非常巧妙。大模型在生成回答时,每往下吐一个词(Token),底层都会先给词表里的几万个候选词各打一个原始分数(这个分数就叫 Logits),然后再挑高分的词输出。所谓「遮蔽 Logits」,就是在模型吐词的瞬间,把当前不允许调用的工具名字对应的词分数直接清零(设为负无穷),这样模型就绝对不可能选出被禁用的工具。
在实际工程中,我们甚至不需要自己去写复杂的底层打分过滤器,直接利用绝大多数模型平台和推理框架都支持的「响应预填充(Response Prefill)」功能,就能四两拨千斤地实现同样的效果!
什么是响应预填充?大模型本质上是一个「顺着上文往下接龙」的机器。平时我们发请求,是让模型从第一个字开始完全自由地生成回复;而「响应预填充」允许我们在发请求时,先替模型把回复的开头几个字符写好,逼着模型只能顺着我们写好的开头往下填空!
我们以开源社区常用的 NousResearch Hermes 函数调用格式 为例,看看怎么靠「替模型写好开头」来实现三种工具控制模式:
- 自动模式(Auto,可聊可调):我们只替模型预填助手的说话开头标签
<|im_start|>assistant。接下来模型既可以正常打字跟用户聊天,也可以自己输出<tool_call>去调工具。 - 强制调用模式(Required,必须调工具):如果当前步骤不允许闲聊、必须干活,我们就直接替模型预填到
<|im_start|>assistant<tool_call>。你看,既然开头已经替它把<tool_call>(调用工具)的标签写死了,模型往下接龙时就别无选择,必须调一个工具! - 指定工具组模式(Specified,只准从某一组工具里选):我们在设计 Manus 时,特意给所有工具起了带统一分类前缀的名字——比如所有浏览器工具一律以
browser_开头(如browser_navigate、browser_click),所有命令行工具一律以shell_开头(如shell_exec)。当状态机判断「当前这一步只允许操作浏览器」时,我们直接把模型的回复开头预填到:<|im_start|>assistant<tool_call>{"name": "browser_
看明白这招有多妙了吗?因为我们已经替模型把工具名的前一半 "browser_ 写在了草稿纸上,模型接着往下吐下一个词时,就只能在 browser_ 开头的那几个浏览器工具里二选一,从物理上断绝了它误调 shell_ 工具的可能!反过来,当用户刚发来一条新消息、状态机要求 Manus 必须先开口回复用户而不是直接乱调工具时,也只需要配合简单的单 Token 遮蔽把 <tool_call> 这个标签禁掉(或开启 API 的 none 模式),模型就只能乖乖打字回话。
不用改动开头的工具列表(保住了 10 倍 KV 缓存),也不用写复杂的有状态过滤器,光靠「统一工具命名前缀 + 预填半截回复开头」,Manus 就把完全由模型自主驱动的 Agent 循环管得服服帖帖。
💡 延伸印证:这和我们在《从 0 到 1 了解什么是 Skill》里讲的「按需加载 Skill」冲突吗? 完全不冲突,反而底层逻辑一模一样!很多新手以为「按需加载 Skill」是在系统提示词开头动态增删工具定义——那恰恰是 Manus 说的反面教材。真正的 Skill 机制是:上下文开头的工具列表里,从始至终只固定放一个
Read(读文件)工具和极简的 Skill 名字列表(前缀永远不变,100% 命中 KV 缓存);当 Agent 需要某个 Skill 时,是调用Read工具把对应的SKILL.md文档作为一条新的观察结果(Observation)追加在上下文的最末尾。这完美遵循了「头部不动、末尾追加」的黄金法则。
3. 将文件系统作为上下文:再大的窗口也不够塞时,怎么做到「瘦身但不丢信息」?
现在的顶级大模型动辄提供 128K 甚至上百万 Token 的超大上下文窗口。很多人会觉得:「窗口这么大,我把所有资料全塞进去不就完事了吗?」但在真实的 Agent 生产环境里,再大的窗口往往都不够塞,有时候大窗口反而是一种负担。原因有三个:
- 真实世界的返回数据太大了:一旦 Agent 开始抓网页、读长篇 PDF 或看长日志,随手操作两三步返回的非结构化文本,就能轻松把 128K 窗口撑爆。
- 上下文塞太满会让模型变笨:就算窗口在技术上塞得下,超过一定长度后,模型的注意力就会被稀释,指令遵循和推理准确率都会明显下降(也就是我们在 Anthropic《AI Agent 的高效上下文工程》中讲过的「上下文腐化 Context Rot」)。
- 长文本每一轮都在烧钱:就算有前面说的 KV 缓存打一折,十几万 Token 每一轮传过去预填充,几十轮累积下来的账单依然肉疼。
为了给上下文瘦身,很多 Agent 系统会做「直接截断(扔掉早期记录)」或者「摘要压缩(把长文缩成几句话)」。但只要压缩得太狠,就一定会丢信息。
这里的死结在于:Agent 走的每一步都环环相扣,站在第 3 步的当下,你根本没法未卜先知地算出,当前网页角落里的哪一行不起眼的数据,会在第 15 步突然变成破局的关键线索。 从逻辑上讲,任何「删了就找不回来」的不可逆压缩,都在给后面的步骤埋雷。
正因为想通了这一点,我们在 Manus 中做了一个核心设计:把沙盒里的文件系统(File System)当成终极上下文。 文件系统的容量没有上限、天生持久化不会丢,而且 Agent 自己本来就会用工具读写文件——那为什么不直接训练模型按需把数据写进文件、用时再按需读出来,把文件系统当成 Agent 的结构化外置硬盘(Externalized Memory)呢?
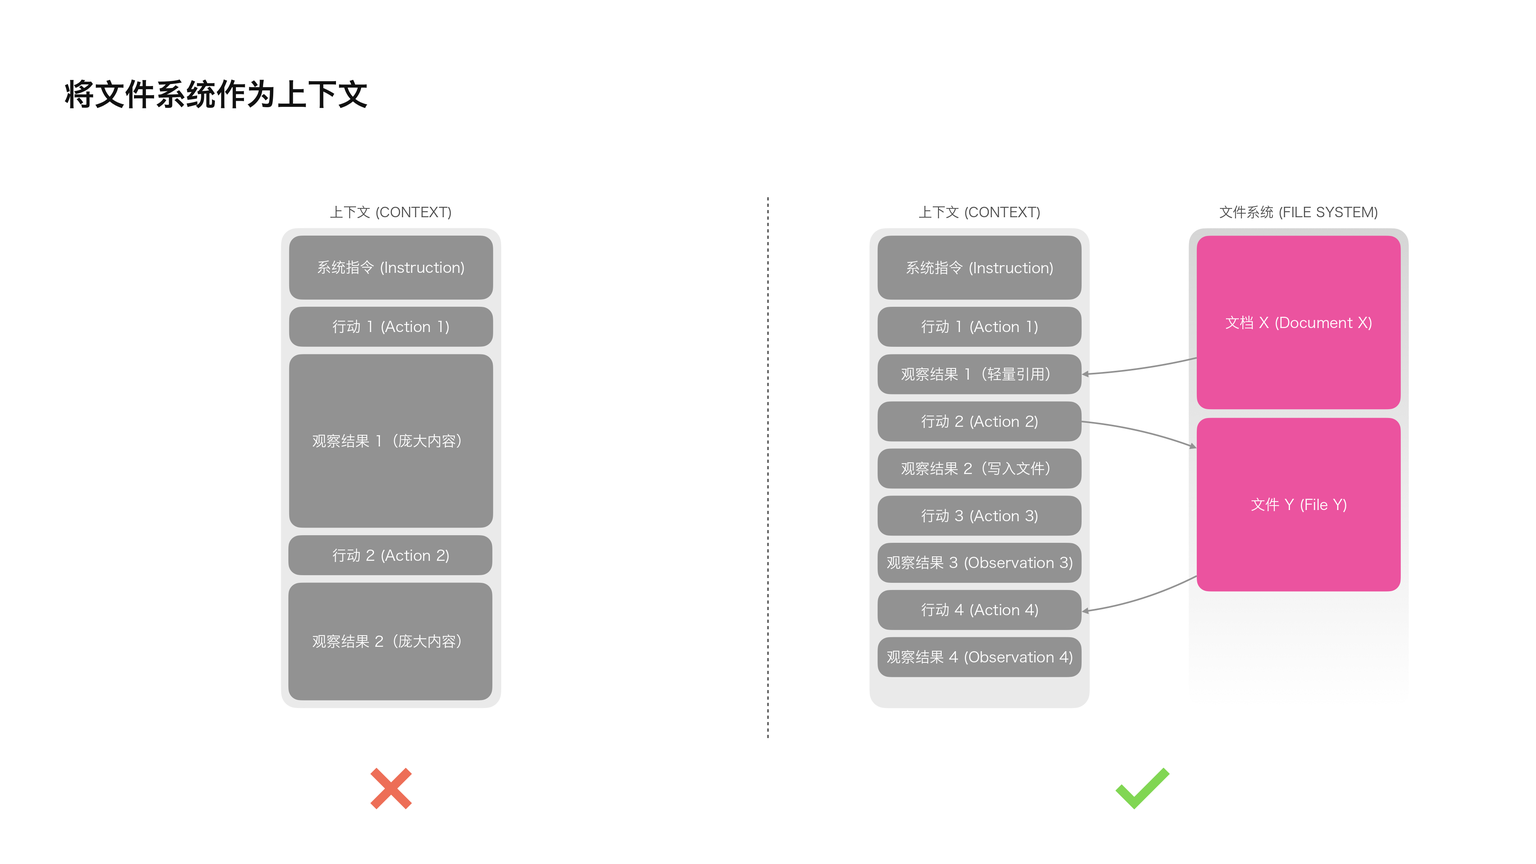
有了文件系统托底,Manus 的所有上下文压缩策略都遵循一条铁律:压缩必须是「可恢复的(Restorable)」(见图 3 右半边):
- 网页正文太长占地方?可以从上下文里直接清掉,但必须在原地保留那个网页的 URL 链接;
- PDF 或长文档内容太多?可以从上下文里省略掉,但必须在原地保留它在沙盒里的本地文件路径(如
/home/sandbox/doc_x.md)。
这就好比你不用把整座图书馆的书都背在书包里(上下文窗口),只需要在兜里揣一张写着「某某资料在第 3 排书架第 2 本」的索书条。上下文瞬间变轻了,而万一十步之后真的需要核对某处细节,Agent 随时可以顺着路径或 URL 把原文件重新打开读回来,真正做到了「瘦身但不丢任何信息」。
在开发这个功能的时候,我脑子里经常冒出一个更大胆的念头:如果未来不靠 Transformer,而是让状态空间模型(State Space Model,简称 SSM,例如近两年很火的 Mamba 架构)来跑 Agent,会怎么样?
这里简单补充一下背景:我们今天用的 GPT、Claude 底层都是 Transformer 架构,它之所以能记住上文的所有细节,是因为它每走一步都要回头跟前面所有词算一遍注意力,代价是越长越慢、越长越费显存;而 SSM(状态空间模型) 采用的是类似循环神经网络的思路,读完一段话就把意思浓缩进一个固定大小的内部状态里——所以它推理速度飞快、显存开销极低,但天生有个致命短板:记不住长距离之前的原文细节(没法像翻书一样精准回查)。
但如果让跑得飞快的 SSM 学会像 Manus 一样熟练读写外部文件系统呢?把需要死记硬背的长期状态全都外置存进本地文件里,模型脑子里只留当前推理逻辑——那么 SSM 的极致速度和效率,很可能会催生出一类全新的高速 Agent。从这个角度看,「会读写文件系统的 SSM」,或许才是深度学习界在 2014 年提出的神经图灵机(Neural Turing Machines,即给神经网络外挂一条可无限读写的图灵机纸带) 真正的现代继承者。
4. 通过「复述」操控注意力:为什么 Manus 总喜欢一边干活一边重写 todo.md?
如果你平时用过 Manus,一定注意过一个特别有意思的习惯:每当接手一个复杂任务时,Manus 总喜欢先在工作区里建一个 todo.md 待办清单文件——而且每做完一个小步骤,它就会去把这个文件重写更新一遍,给做完的事项打上勾([x])。
很多人以为这只是为了在界面上给用户展示进度、显得产品很贴心。其实不然——这背后是一套专门用来操控大模型注意力的硬核机制。
在 Manus 里,完成一个典型任务平均需要连续调用 50 次左右的工具。这是一条非常漫长的执行链条。前面我们说过,用户在第 1 步交代了初始目标,但随着中间执行了三四十轮搜索网页、跑脚本、看日志,上下文中间已经塞满了几万字的细节。
而所有大语言模型在处理长文本时,都有一个著名的通病叫「迷失在中间(Lost-in-the-Middle)」:模型对上下文最开头和最末尾(刚刚生成的最近几轮内容)注意力最集中,而对隔了好几万字、夹在中间的早期计划很容易慢慢淡忘,跑着跑着就偏离了主线(Drifting off-topic)。
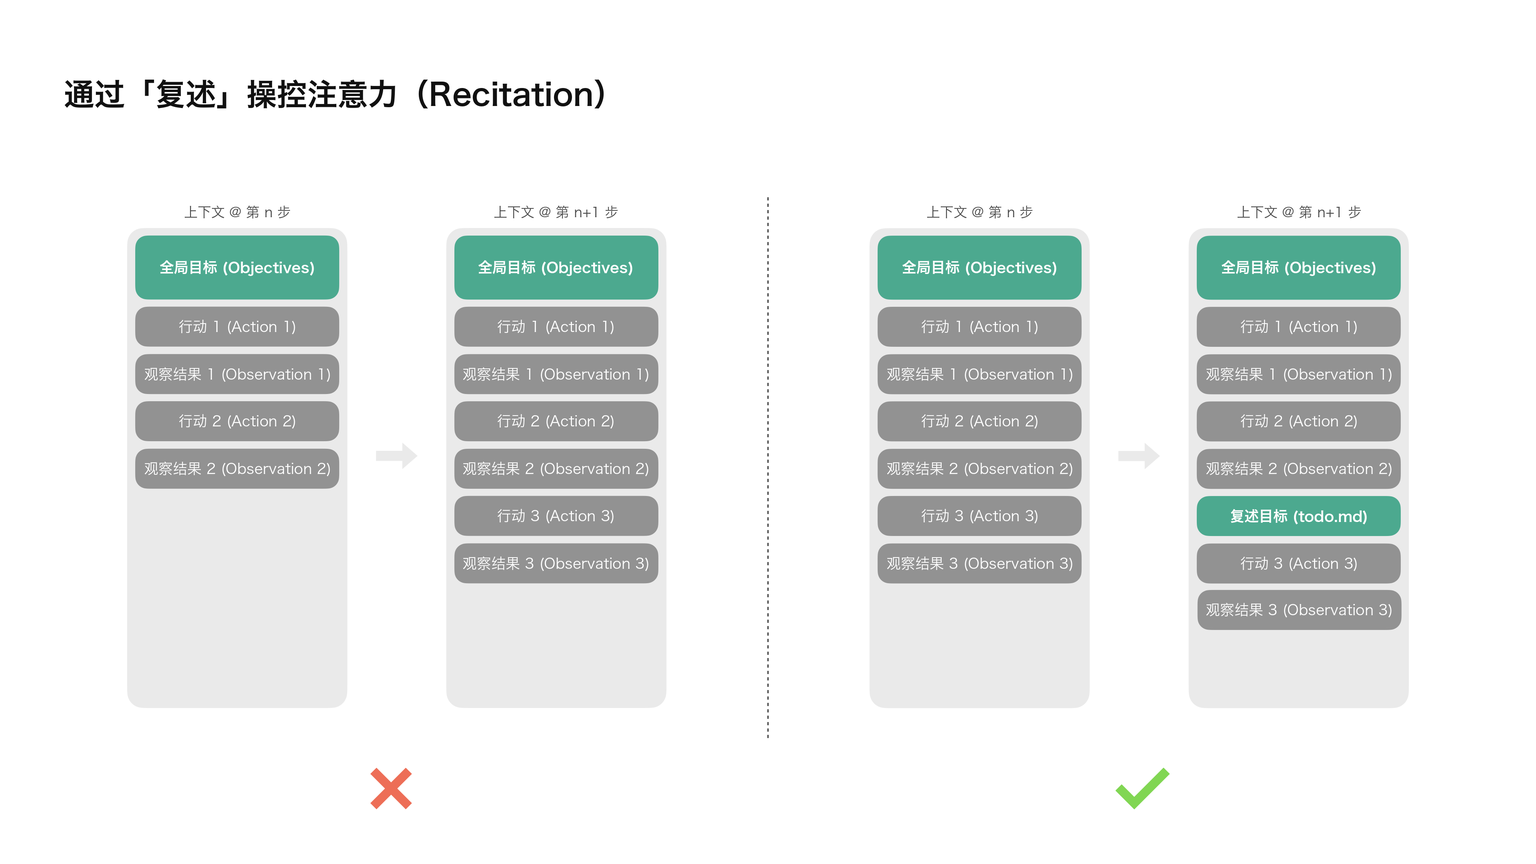
Manus 是怎么破局的?靠的就是让 Agent 不断重写 todo.md,把目标「复述(Recitation)」到上下文的最末尾(见图 4 右半边):
- 如果不复述(图 4 左半边),全局目标(绿色的
Objectives)永远停留在上下文最顶上,随着下面的灰色动作块越堆越多,目标离模型当前正在思考的位置越来越远; - 而当 Manus 每走几步就去读写更新一次
todo.md时,这份最新的全局计划和当前进度,就会作为最新一轮的记录直接出现在上下文的最底部(紧挨着模型即将生成的下一步动作Action 3)!
这相当于每隔几步,就让 Agent 自己把任务目标大声朗读抄写一遍,强行把全局路线图拉回模型最敏锐的「近期注意力窗口」里。不需要改动任何模型底层架构,光靠一套自然语言的 todo.md 读写习惯,就能稳稳锁住长程任务的方向盘。
5. 保留错误的尝试:工具报错了,千万别在后台偷偷抹掉重跑
只要让 Agent 在真实环境里干活,它就一定会犯错。这不是你代码没写好,而是客观现实:大模型偶尔会犯迷糊(产生幻觉),外部网页会打不开,命令行工具会报错,各种奇葩的边界情况随时都会冒出来。在几十步的长任务里,报错和失败从来不是意外,而是循环本身的常态。
但面对报错,很多开发者的第一反应是「家丑不可外扬」——在后台代码里把刚刚报错的记录偷偷删掉、恢复到上一步的状态,然后调高一点模型的温度参数(Temperature,控制输出随机性的旋钮),祈祷模型重新抽一次奖能蒙对。
这样做表面上让上下文看起来干干净净,实际上却犯了一个致命错误:抹掉失败记录,就等于销毁了现场证据;没有了报错证据,模型怎么知道刚才那条路走不通?
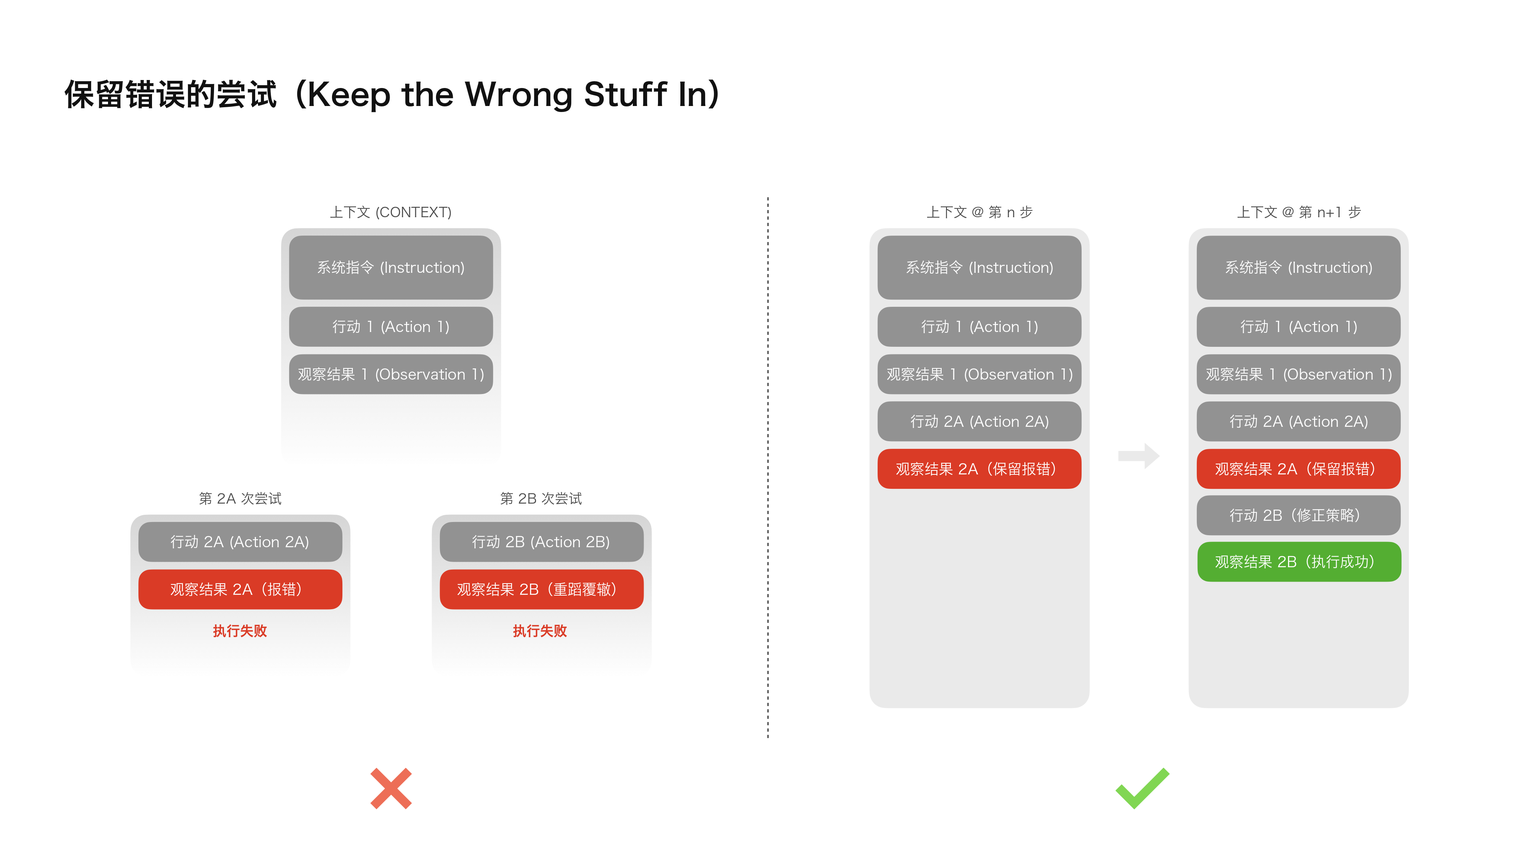
看看图 5 左半边的反面教材就明白了:模型在第 1 步之后尝试执行 行动 2A,结果报错失败了;如果你把 2A 的报错记录从上下文里擦掉,让模型面对一模一样的上下文重来一次(第 2B 次尝试),因为在当前上下文下模型本来就觉得那个动作最合理,哪怕你调了 Temperature 随机采样,它还是有极大概率重蹈覆辙,再摔进同一个坑里!
根据我们的实战经验,让 Agent 变聪明最立竿见影的办法之一,简单得不可思议:把走错的动作和报错信息原封不动地留在上下文里(见图 5 右半边)。
当模型在下一轮上下文里亲眼看到「我刚才执行了 行动 2A,结果环境返回了某段报错堆栈(Stack Trace)或权限拒绝提示」时,它会通过上下文学习自动修正自己的判断,知道「这条路是死胡同」,从而在下一步(行动 2B)主动换一套参数、先装缺失的依赖,或者换一个工具把任务跑通。而且别忘了,把报错留在原地、只在末尾追加新尝试,还顺便 100% 保住了前面的 KV 缓存!
事实上,我们认为「遇到报错后能不能自己爬出来(错误恢复能力 Error Recovery)」,才是检验一个系统算不算真 Agent 的试金石。只可惜目前的绝大多数公开测评榜单(Benchmarks)和学术论文,还停留在温室里测「一次跑通的成功率」,严重低估了真实世界里最关键的容错与自愈能力。
6. 别被「少样本示例」带进死胡同:为什么连审 20 份简历,Agent 会变成无脑复读机?
平时写提示词时,大家都学过一招叫少样本提示(Few-Shot Prompting)——在提示词里放两三个标准问答样例,模型就能照猫画虎输出高质量结果。
但在多轮循环的 Agent 系统里,这招背后的原理反而可能坑惨你。
为什么?因为大语言模型骨子里就是一台极其强大的「模式模仿机」,它最擅长的事情就是顺着上文的格式和节奏往下接龙。如果 Agent 的上下文历史里,连续出现了十几组长得一模一样的「动作 - 观察结果(Action - Observation)」记录,这十几轮历史在模型眼里,就变成了一个超级强力的 Few-Shot 催眠模板!模型会不由自主地顺着这个机械节奏一直重复下去,哪怕情况早就变了、不该再这么干了也停不下来。
在需要批量处理同类事项的任务里,这个毛病尤其致命。举个我们在 Manus 里碰到的真实例子:当用户让 Manus 帮忙批量审阅 20 份求职简历(或者批量抓取 20 个网页)时,如果前几轮的动作和环境返回提示全都一个模子刻出来(见图 6 左半边,一水儿的 打开网页 -> 内容已保存至 /home/example_x.md),Agent 审完前几份后就会彻底陷入机械的复读节奏——哪怕第 15 份简历格式完全不对、或者 20 份其实已经看完了,它还是会因为上文里满眼都是相同格式,继续机械地重复动作,导致跑偏、以偏概全,甚至开始凭空捏造幻觉结果。
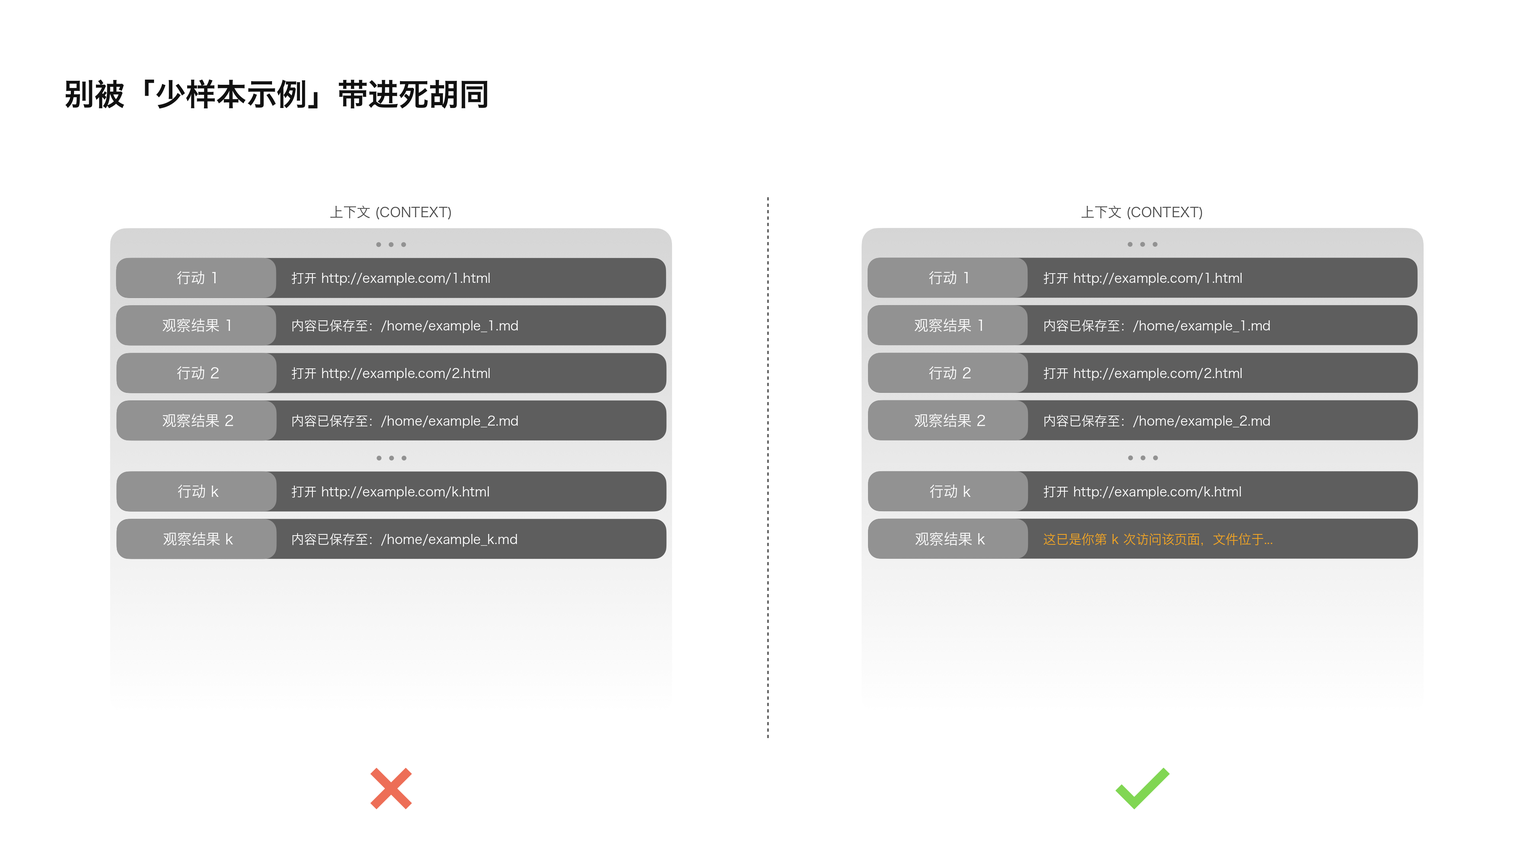
怎么把模型从这种机械复读的催眠状态里「晃醒」?解法就是主动在上下文里加一点变化(增加多样性 Diversity)。
Manus 会在把每一轮动作和环境返回结果拼成上下文文本时,刻意引入少量的结构化变化(受控的随机性 Controlled Randomness):比如准备几套不同的返回结果包裹模板交替使用、换几种近义措辞,或者在格式与提示语上加一点微小的变化(比如图 6 右下角,当检测到连续重复访问时,把千篇一律的保存提示换成橙色的 这已是你第 k 次访问该页面,文件位于...)。
请注意:我们是在每一轮新生成观察结果追加到末尾时换用不同模板,一旦写进历史就不再改动——所以既不会破坏前面的 KV 缓存,又能用末尾这点微小的格式变化打破单调的复读节奏,把模型的注意力重新唤醒。
用一句话总结就是:千万别让你的 Agent 被它自己的历史记录「少样本催眠」进死胡同。你的上下文格式越单一、越死板,你的 Agent 在长循环里就越脆弱。
结语:从打磨好每一个上下文开始
上下文工程至今仍是一门正在快速演进的新兴科学——但对于 AI Agent 系统而言,它早已经是决定体验生死的必修课。
底层大模型固然会变得越来越聪明、越来越快、越来越便宜,但再强大的原始模型能力,也替代不了外部记忆机制、运行环境设计与真实的错误反馈闭环。你如何组织和塑造上下文,最终直接决定了你的 Agent 会表现出怎样的水准:它响应有多快、犯错后能不能自己爬起来,以及在复杂的真实任务里到底能走多远。
在 Manus,我们正是通过四次推倒重写、踩过无数死胡同,并在数百万真实用户的日常使用检验下,才摸索出了上面这六条实战经验。这里分享的未必是放之四海而皆准的绝对真理,但它们确实是在 Manus 生产环境中被验证最管用的工程模式。如果这些经验能帮你省下哪怕一次痛苦的返工,这篇文章就没有白写。
Agent 的未来,就建立在每一个精心打磨的上下文之上。好好设计它们吧。