 Anthropic 团队
在 Anthropic,写代码本身已经不再是构建系统或推进研究的瓶颈了。Claude 能够以前所未有的速度和规模,自主迭代研究闭环、对复杂程序做微观性能优化,以及从零搭建全新的后端服务。如今真正的瓶颈,变成了所有当年按“人类规模”设计的研发基础设施:源码版本控制(source control)、构建系统以及持续集成(CI,每次提交代码后自动运行构建与测试的流水线)。
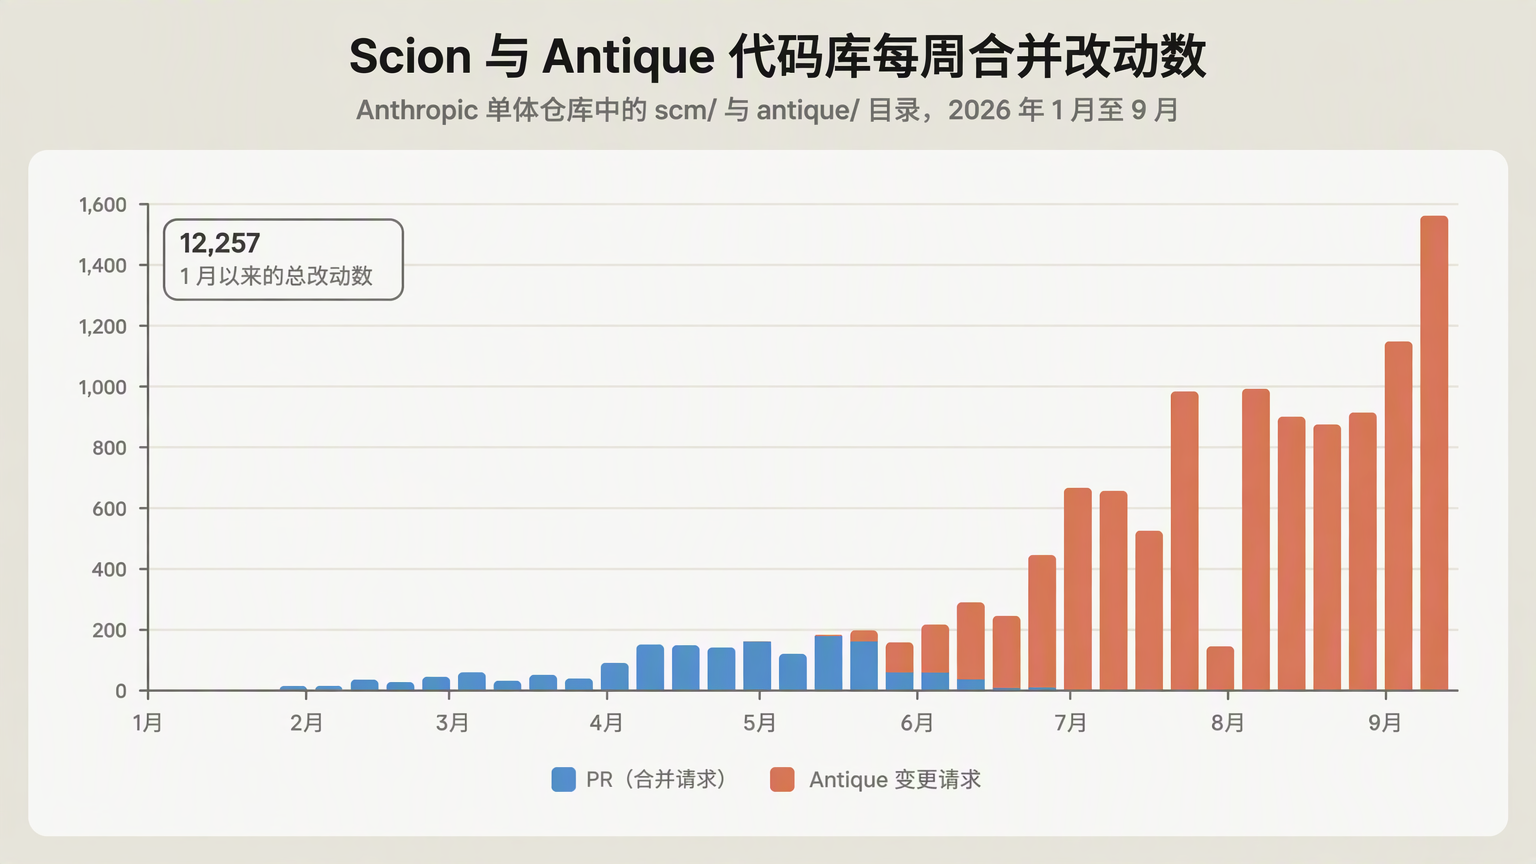
2026 年 5 月,Anthropic 平均每天合并约 2,500 个代码改动;而到了 9 月,我们每天合并的改动已经超过 30,000 个(其中 9 月 9 日单日合并达到 30,401 个)。我们预计这种增长速度在短期内不会放缓——团队对合并代码的潜在需求几乎是无限的,我们每消除一个基础设施瓶颈,产出的代码量就会立刻迎来新一轮暴涨。
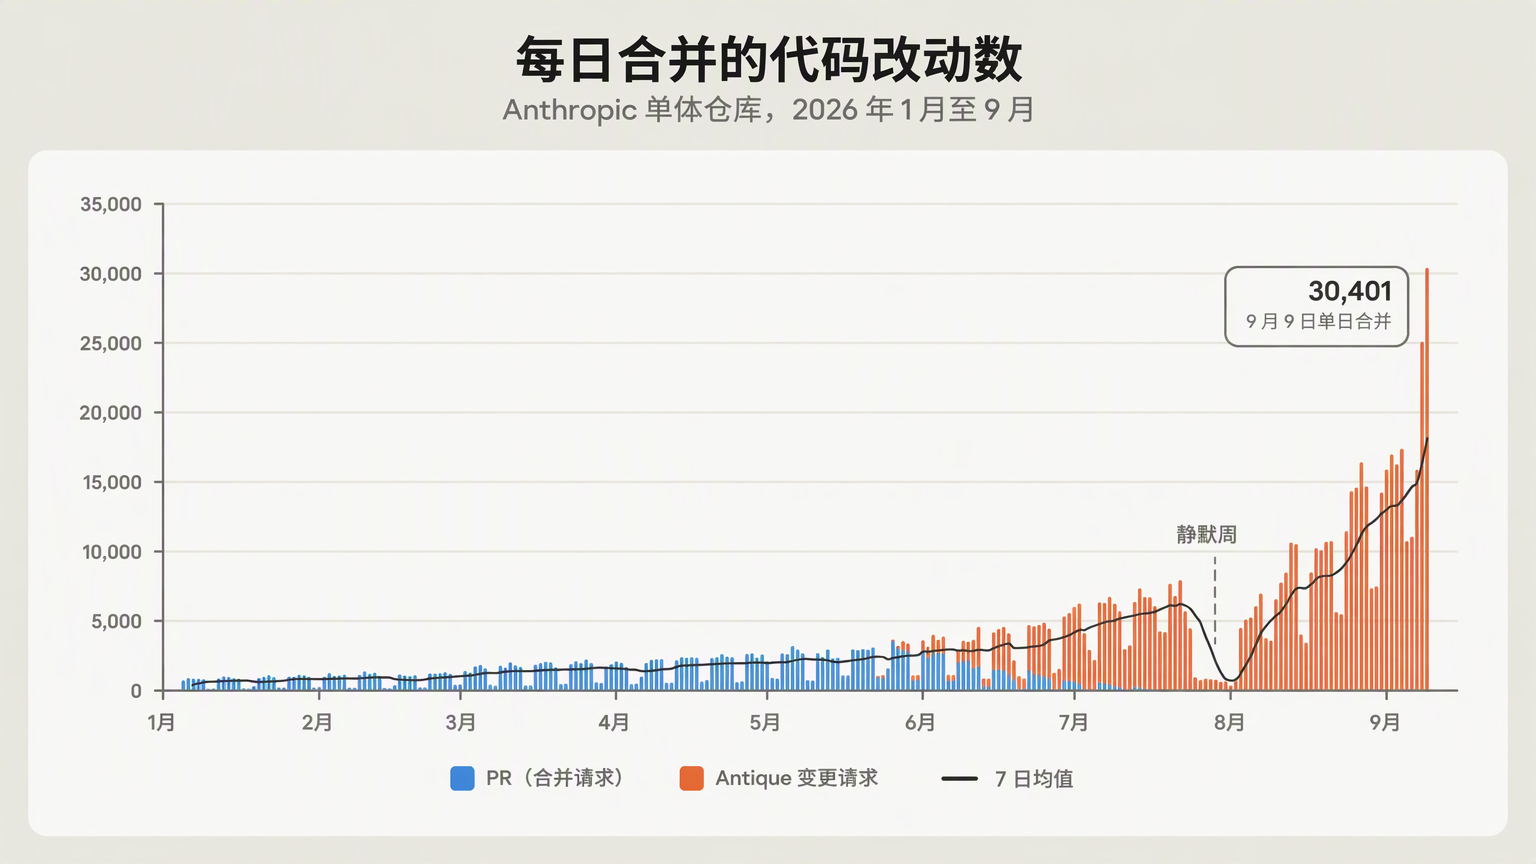
上图展示了 2026 年 1 月至 9 月期间,我们单体仓库(monorepo,把公司所有项目和模块集中在同一个代码仓库里管理)每天合并的代码改动数量。
为了支撑这种量级的增长,我们自研了一套名为 Scion 的版本控制系统,并在五个月内把整个单体仓库从 Git 全面迁移到了 Scion。在同一时期,我们还一并开发并上线了配套的代码审查平台(名为 Antique)、代码搜索系统、细粒度的源码权限管理(IAM)系统,以及一套用于管理和合入海量已审代码的新机制。在这篇文章中,我们会重点分享 Scion 本身的设计与构建过程。这是一个非常典型的案例:正是因为 Claude 写代码的能力太强,才把我们逼到了原有基础设施的极限;但也恰恰是因为有 Claude,我们才能在这么短的时间内造出一套高质量、可扩展的新系统来解决这个问题。
导读:即使你不维护超大型单体仓库,这篇文章有哪些值得借鉴的实战启发?
- 重新审视“默认给人类设计”的工具假设:当开发主力变成永远在线的 AI Agent 时,许多传统工程假设(例如每个节点都要克隆完整代码历史、所有改动必须在全局串行合并队列里排队上锁)都会从优势变成瓶颈。
- 工程师的核心价值正在转向“架构权衡与对 AI 说不”:在 Scion 迁移过程中,工程师最常做的事是拦截 Claude 为了快速跑通任务而破坏系统核心约束的做法(比如暴力线性扫描提交日志),以及防止它在对抗性审查中过度工程化。
- 让专门的 Agent 盯守单一组件(“超级粉丝”模式):与其只靠死板的阈值告警,不如在聊天频道里为每个核心服务配置一个接入了监控与日志的专属 Claude(superfan),像不知疲倦的资深工程师一样盯守异常信号。
扩展我们的单体仓库
在展开介绍技术细节之前,需要先说明一下我们的工作负载有多特殊。毫不意外,Anthropic 内部使用 Claude 编写软件的程度几乎远超任何其他公司,因此那些按人类规模设计的研发工具会在哪里先撑不住,往往也是我们先撞上。源码版本控制只是其中一个缩影。虽然大多数团队短期内还不会遇到同等量级的压力,但随着 AI 编程工具的普及,我们相信其他重度使用 AI 的团队用不了多久也会面临类似的瓶颈。这也是我们希望把这套架构与经验分享出来的原因。
Git 是一个去中心化(分布式)系统:每一次克隆(git clone)出来的都是一个完整、自包含的代码仓库。哪怕完全断网离线,你也可以在本地计算代码差异(diff)、查看提交历史和每一行代码的修改溯源(git blame),或者检出(checkout)任意历史版本。对于绝大多数代码仓库来说,这都是非常合理的设计,也是 Git 成为行业标准的重要原因。
但随着我们的单体仓库急速膨胀,它越来越不适应 Git 的这一设计前提。光是我们主干分支(main)的历史记录就已经接近 100 GB,哪怕是压缩后的本地工作区副本(working copy)也超过了 25 GB。还不算开发环境、Agent 沙箱和研究任务,单是 CI 流水线每天就要执行约 2,500 万次代码检出。如果全都按朴素的方式直接拉取,每天产生的 Git 网络流量将超过 600 PB。
当然,Git 本身也提供了一些只拉取仓库局部数据的工具,比如浅克隆(shallow clones,只拉取最近几层提交历史)、稀疏检出(sparse checkouts,只把指定子目录展开到磁盘上)以及承诺端远程仓库(promisor remotes,允许按需延迟下载缺失的 Git 对象)。除此之外,业界针对超大型单体仓库也有一套标准缓解方案,比如部署内部 Git 镜像集群,以及在云端对象存储(blob storage)里维护定期打包的仓库种子快照(seeds)。这些手段我们全都用上了——在高峰期,我们内部同时运行着几百台 Git 镜像服务器来分担负载。这确实帮我们争取到了喘息时间,但随着代码合并速率飙升,这套体系变得越来越难维持:两次刷新之间,种子快照与 main 分支最新提交的差距越拉越大;而在不完整的局部克隆上,要想保证 diff 和 blame 这类依赖历史记录的操作正常工作,需要付出的维护代价也越来越高。
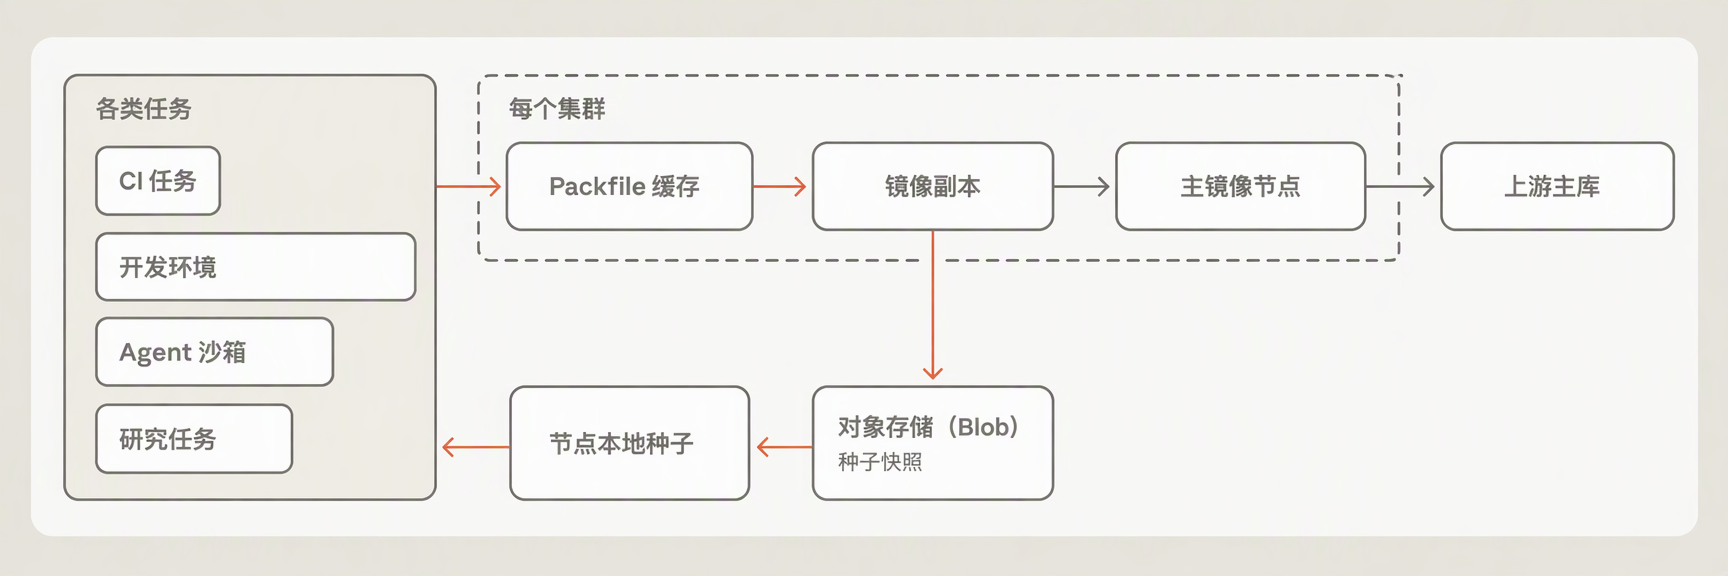
退一步看,我们注意到一个事实:和大多数公司一样,我们实际上是把 Git 当作一套“只有一个权威主库”的中心化系统在用,而且几乎所有的客户端都是天然实时在线的 AI Agent 和自动化任务。那些让 Git 在分布式离线协作中表现出色的特性,在仓库规模急剧扩大时,反而成了制约我们扩展的最大阻碍。于是我们问了自己一个问题:如果我们从一开始就围绕“客户端永远在线”这一前提来设计源码版本控制,它会是什么样子?
面向 Agent 规模的版本控制设计原则
进入 Agent 编程时代后,关于软件如何开发的许多传统假设都在发生改变。我们在构建 Scion 时主动拥抱了这些变化,从而在几项核心原则上走了一条与 Git 截然不同的路线。超大型单体仓库的版本控制此前已有先驱探索,最著名的是 Google 的 Piper 和 Meta 的 Sapling(尤其是其服务端组件 Mononoke 以及它开创的 Bonsai 数据模型),我们在设计 Scion 时充分吸收了它们来之不易的实战经验。我们的六项核心原则如下:
1. 客户端永远在线(Clients are always online)。 Git 默认客户端会在离线环境下工作,因此需要一份完整的本地仓库副本。既然我们的客户端几乎全是实时在线的 Agent 和计算任务,我们就围绕“服务端随时可达”这一前提来设计 Scion 的客户端与通信协议,让客户端只在真正需要数据时按需拉取。
2. 客户端与服务端非对称分工(Client-server asymmetry)。 在 Git 中,每一个客户端本身都具备完整服务端的能力。而在 Scion 中,查询文件历史与 blame、创建提交、执行合并(merge)与变基(rebase)等计算工作全部由服务端完成。客户端只负责维护一个容量受限的本地对象缓存、把工作区文件铺到磁盘上、监听文件系统变动,并为用户提供顺手的命令行交互体验。客户端自己几乎不做复杂计算,但作为交换,它在本地需要存储的数据量大幅减少。
3. 完备的版本控制服务能支撑大量新型应用(A comprehensive source control service can power many novel applications)。 在使用 Git 时,如果某个 CI 任务或内部工具想向代码库提问(比如“某一行代码最后是谁改的”或“两个提交之间是什么关系”),它要么得在本地维护一份代码库副本,要么只能寄希望于代码托管商提供了对应的专属 API。而在 Scion 中,客户端用到的所有版本控制查询能力都通过服务端 API 完整暴露出来,因此在很多场景下,自动化任务根本不需要在本地克隆任何代码仓库。我们内部的许多自动化工具——比如自动二分排查(automated bisect)和自动回滚(revert)流水线——如果没有这种低成本的编程式版本控制访问接口,在如此庞大的规模下根本无法落地。
4. 一切组件必须支持水平扩展(Everything must be horizontally scalable)。 在高峰期,我们曾同时运行数百台 Git 镜像节点,这不仅严重挤占了计算资源,而且一旦代码库体积涨破单台镜像节点的磁盘或内存上限,整套方案就会无法继续扩展。在 Scion 中,代码库的数据是分布式存储的,每一个组件都可以独立水平扩容;哪怕在服务端,也没有任何一台机器上存放着代码库的完整实体副本。同时,Scion 里没有类似 Git packfile(把大量松散对象打包压缩成的巨型归档文件)的概念,因此也完全不需要执行仓库垃圾回收与整理维护(如 git gc)。
5. 提交必须低成本、增量式且无锁(Commits must be cheap, incremental, and lock-free)。 在 Git 中,你先在本地提交(commit),再通过推送(push)把改动分享出去。而在 Scion 中,每一次提交、变基或合并都直接在服务端完成,根本没有 push 这一步,但这也要求每一次服务端操作都必须足够快。创建一次提交并更新下游数据结构的开销,必须只跟本次改动的体积成正比,而不能跟整个代码库的总体积挂钩,否则服务端根本扛不住吞吐压力。此外,Scion 的开发生命周期不鼓励随意创建 ref(指向提交的引用指针,例如分支和标签),通常只保留 main 主干引用或发布分支——因为任何需要所有服务器达成一致的“全局状态”,在规模化时都会变成棘手的扩展瓶颈。
6. 本地工作区是可选的,且默认按稀疏方式设计(The working copy is optional, and sparse by design)。 因为我们的单体仓库体积巨大,而 CI 每天又要检出代码数千万次,我们的原则是“能不检出就尽量不检出”。有了 Scion,如果一个 CI 任务只需要获取某个提交与其合并基点(merge base)之间的代码差异(diff),直接调服务端接口拿结果即可。写操作也是如此:许多自动化写任务同样可以跳过本地检出,完全通过 API 完成代码修改与提交。同时,Scion 的协议从底层就围绕稀疏检出(只包含客户端请求的子目录)和虚拟化检出(按需将文件真正写入磁盘)构建,哪怕任务确实需要落盘文件,客户端也只需要为它实际读取到的那部分文件付出开销。
Scion 是如何工作的
理解上述原则如何在 Scion 的工程实现中落地,是一件很有意思的事。这些设计思路不仅适用于版本控制系统,也能推广到软件开发生命周期的其他基础设施中。
数据结构
在 Scion 中,基本的工作单元叫做**“变更集(changeset)”,它是预写式日志(write-ahead log)中的一条记录。一个变更集存储的信息与 Git 中的 commit 大同小异;但关键区别在于:Git 的 commit 存储的是指向整棵目录树(tree)的指针,而 Scion 的 changeset 只存储相对于其第一个父节点发生变动的文件列表**(在基于主干开发的单体仓库中,大家实际上只关心主干主线上的历史记录与代码溯源,因此只记录相对于第一个父节点的文件变动是一种兼顾性能与实用性的设计选择),同时附上指向云端对象存储中压缩文件内容的、按内容哈希寻址(content-addressed)的指针。变更集直接在服务端创建,一旦生成即可在全球所有节点瞬间可见。
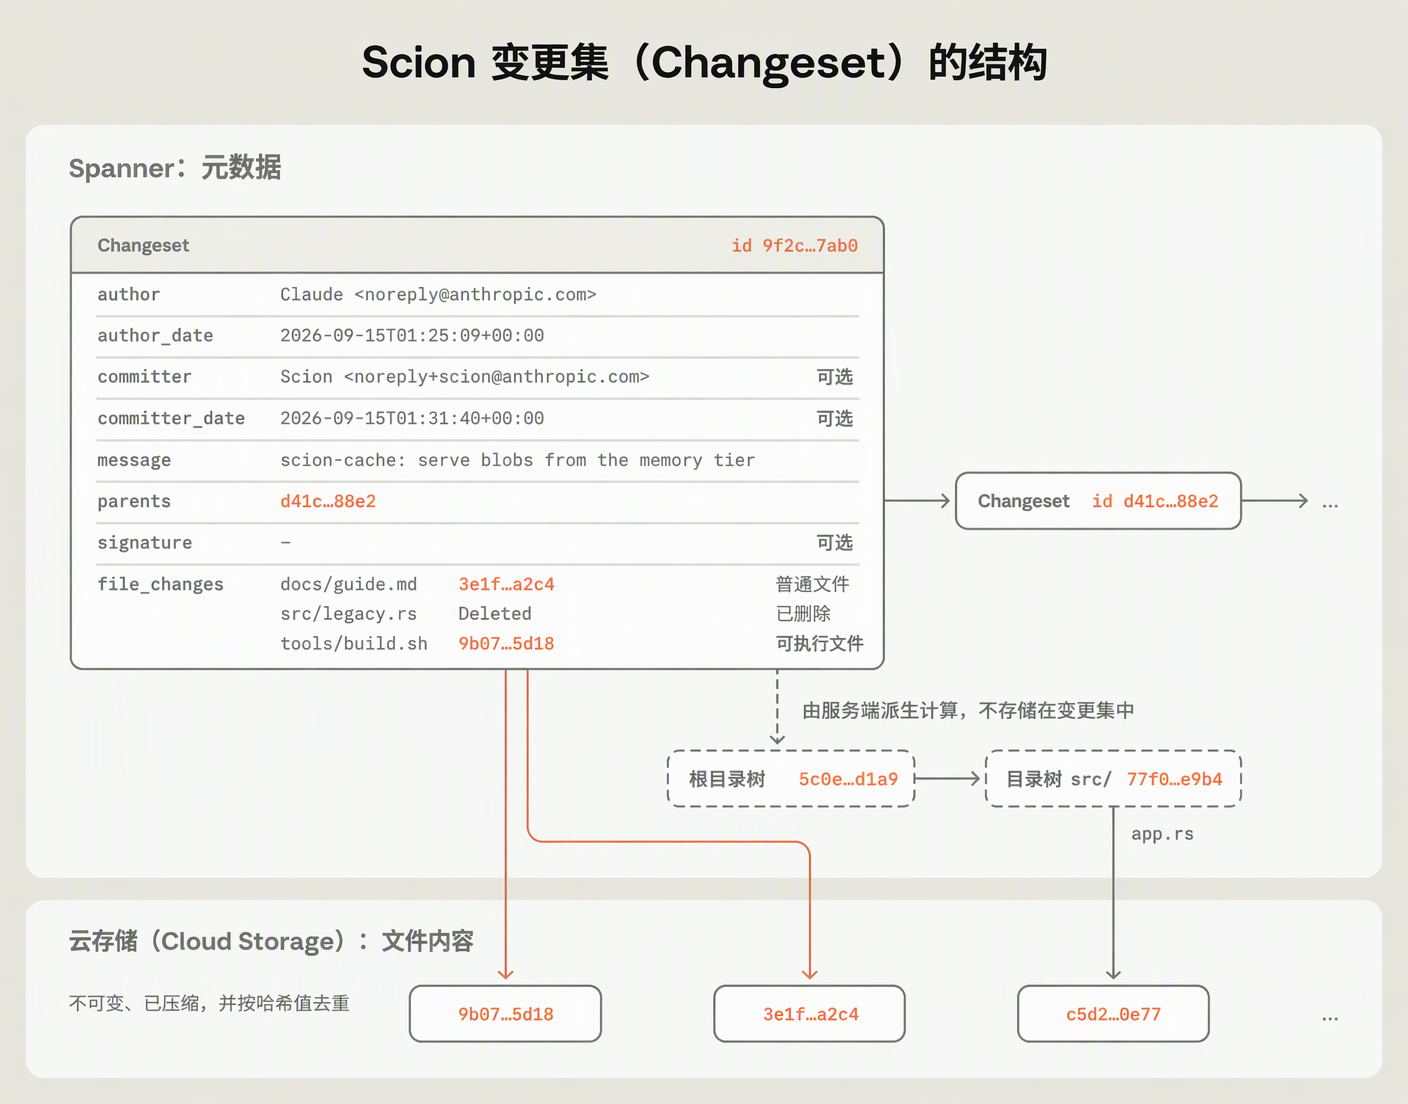
为了方便理解上图中变更集的元数据字段,下面给出对应的结构与中文说明:
# Scion Changeset(变更集)存储在 Spanner 中的核心结构示例
Changeset: id 9f2c...7ab0
  author: Claude <noreply@anthropic.com>              # 作者信息(例如由 Claude 提交)
  author_date: 2026-09-15T01:25:09+00:00              # 创作时间戳
  committer: Scion <noreply+scion@anthropic.com>      # 提交者信息(可选)
  committer_date: 2026-09-15T01:31:40+00:00           # 提交时间戳(可选)
  message: "scion-cache: serve blobs from the memory tier"
  # 中文说明:提交说明(示例意为“scion-cache:直接从内存层提供文件对象服务”)
  parents: d41c...88e2                                # 父变更集 ID
  signature: -                                        # 加密签名(可选)
  file_changes:                                       # 仅记录相对于父节点发生变动的文件列表:
    docs/guide.md   -> 3e1f...a2c4 (Regular file)     # 普通文件:指向云存储中的不可变哈希对象
    src/legacy.rs   -> Deleted                        # 已删除文件:仅标记删除状态
    tools/build.sh  -> 9b07...5d18 (Executable)       # 可执行文件:指向云存储中的不可变哈希对象
这种数据结构让我们能够以极高的吞吐量接收代码提交:既不需要接收和解包庞大的 packfile,也不需要跨服务器加锁协调,更不需要频繁移动分支引用指针(refs)。技术上 Scion 依然支持 ref,但由于创建和拉取提交都不涉及 ref,移动分支指针的操作被解耦成了在 Google Cloud Spanner 分布式数据库的单行记录上执行一次原子性的比较并交换(compare-and-swap,简称 CAS),与创建变更集互不阻塞。
不过,由于变更集本身只记录“改了哪些文件”,单靠它是无法快速回答“某一行代码最后是谁改的”或者“历史上有哪些提交修改过某个文件”这类问题的。为了高效回答这些查询,Scion 会基于变更集构建额外的数据结构,包括专门用于文件级 blame 和路径历史的索引结构,以及用于加速提交图(commit graph)遍历的跳表(skip lists)。我们把所有不属于变更集本体的附加数据统称为**“派生数据(derived data)”**,并通过一套通用机制来统一计算。每一种派生数据都采用递归定义:当前变更集的派生数据值,直接由其父节点的派生数据值增量计算得出。
这套派生数据机制带来了三大好处:
- 易于扩展新索引:每当我们需要通过新增数据结构来加速某类操作时,只需轻松定义一种新的派生数据类型即可。随着系统演进,我们已经多次添加新的派生数据类型,例如用于复制检测(copy detection)或基于路径的文件搜索的新索引。
- 按需或提前计算自由切换:针对每一种派生数据类型,我们都可以选择在提交时立即计算(eagerly),或者推迟到首次查询时再按需计算(defer),从而避免具象化那些根本没人用得上的数据。
- 对客户端完全透明:由于客户端永远不会直接接触这些底层数据结构的内部格式,我们可以随时在服务端优化索引结构,而无需升级或改动客户端。
Scion 的水平扩展架构
在服务端,一小群 scion-server 服务器对外提供版本控制 API,涵盖客户端所需的全部操作:获取变更集、计算 diff、查找合并基点以及拉取文件对象(blobs)。由于所有版本控制数据都是按内容哈希寻址的(content-addressed),任何一份数据一旦写入就永远不会改变,因此任意一台服务器都可以放心地在本地缓存数据,而无需与其他服务器核对一致性。这使得服务端天然支持水平扩展,几乎不需要节点间协调。本质上,scion-server 就是一层大型缓存,同时能够实时计算派生数据并将结果写回 Spanner。
得益于此,Scion 的众多下游调用方再也不需要在本地维护自己的代码仓库副本了。过去,对于那些需要查询提交血缘关系(ancestry)和 blame 的 CI 任务或内部工具来说,拉取并维护本地 Git 仓库是一项沉重的负担。在迁移早期,当我们还没有写好自己的客户端、仓库格式和传输协议时,Scion 就是先从接管这些“元数据查询”切入的。相比之下,拉取海量文件内容并在磁盘上铺开工作区副本属于数据密集型操作,需要一套专门的传输与缓存设计。
Scion 的命令行客户端 scn 在拉取协议上与 Git 做了几处关键背离,从而造就了一套极易扩展、且服务端 CPU 消耗远低于 Git 服务器的架构:
- 不汇报“我有什么”,只请求“我要什么”:Git 的拉取协商(negotiation)需要客户端告诉服务端自己本地已经有哪些提交,服务端再现场计算差集并打包成
packfile;而scn客户端只针对自己需要的目录树(trees)和文件对象(blobs)发起请求。客户端从根目录树出发,检查本地存储中缺失的子目录树并递归发起请求,随后对文件对象重复这一过程。 - 天然契合多级缓存且支持断点续传:因为每一次请求都是在索取一个永不改变的特定哈希对象,任何一层缓存节点都能直接响应,整体架构与传统的多级 CDN/缓存体系高度相似。同时,由于不再依赖单次动辄数 GB 的巨型
packfile响应,拉取过程不仅高效,还天然支持断点续传。稀疏检出甚至虚拟化检出都不需要编写额外的特殊逻辑——客户端只要不去请求它不需要的子目录树即可。
在计算集群内部,scn 客户端通过本地套接字(socket)与宿主机节点上的守护进程 scion-daemon 通信,由 scion-daemon 统一存储整台物理节点共享的代码对象。因为集群里绝大多数节点都需要访问单体仓库,同一台机器上运行的多个任务可以高度复用相同的对象。每个 scion-daemon 启动时会先加载一份定期刷新的快照,随后只与当前可用区(region)内的目录树与文件对象缓存服务器 scion-cache 通信。这些 scion-cache 服务器直接从内存中以 scion-daemon 落盘所需的原生格式流式传输对象,因此完全不需要花 CPU 时间去计算客户端缺失的对象,也不需要做增量压缩(delta compression)。只有当区域级缓存未命中(cache miss)时,它才会向上游权威的 scion-server 发起请求,由后者按需从 Spanner 或云存储中读取。
更重要的是,scion-daemon、scion-cache 和 scion-server 三层组件响应该协议时使用的是完全一致的 RPC 接口,因此客户端根本不需要感知缓存拓扑结构。理论上任何一层都可以直接与另一层对话,但我们在生产环境中严格强制按层级顺序调用,以此隔离故障域(failure domains)——避免某个区域的 scion-cache 出现故障时,海量请求直接击穿到上游的 scion-server 并拖垮整套系统。
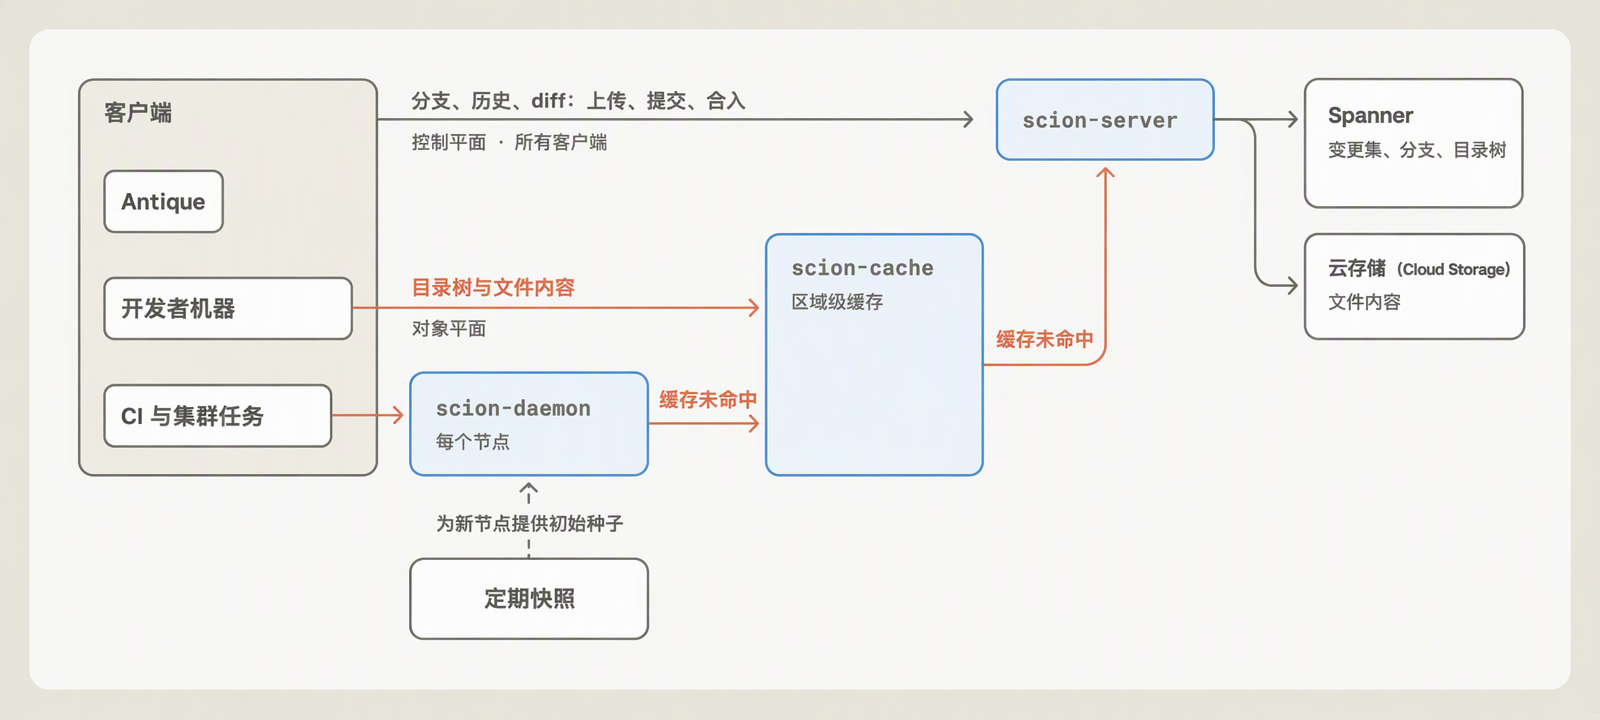
在这套分级架构中,每一层都保持着 99% 以上的缓存命中率,且不需要维护长生命周期的有状态会话,随时可以按需横向扩容。与此前庞大的 Git 镜像集群相比,Scion 基础设施占用的 CPU 和内存资源缩小到了原来的 1/200(缩减 200 倍)。CI 与研究任务检出代码的速度提升了两个数量级(从原来的几分钟缩短到几秒钟),为整个计算集群释放了可观的算力——单是 CI 集群就因此直接省出了 25% 的 CPU 容量。无论是客户端还是缓存层都不再需要执行仓库维护任务,任务生命周期管理也随之大幅简化。
构建 Scion 带给我们的启示
我们启动 Scion 项目的时间点,恰好与内部上线 Claude Mythos Preview 和 Claude Tag 的时间高度重合。这两个新工具的内部发布,一方面让代码产出量暴增、进一步放大了对 Scion 的迫切需求;另一方面也实实在在地加速了我们构建 Scion 的进程。
这里有一个令人印象极其深刻的例子。今年早些时候,我们基本靠纯手写完成了第一版“从 Git 到 Scion 的数据导入流水线(ingestion pipeline)”原型。当时我们觉得自己写得已经挺不错了——直到我们拿到了 Claude Mythos Preview 的早期内部测试版本。我们只让它把整条导入流水线重写一遍,没有给任何额外的细节指令,结果它交出的新版本内存占用降低了 20 倍,运行速度提升了 4 倍,而且完整保留了数据导入顺序和底层数据结构中所有隐含的不变性约束(invariants)。
回顾构建和运维 Scion 的全过程,我们总结出了几条关于“如何构建面向 Agent 规模的软件系统”的核心启示:
1. 精干小团队的高速开发将成为常态。 仅仅 7 个人的团队,在五个月内同时造出了 Scion 和 Antique(我们的代码审查平台,光它本身就足够单写一整篇技术博客了),外加五六个配套周边系统,并完成了全公司的无缝迁移。而且这一切都是在公司每天合并的代码量暴涨 10 倍的背景下完成的。放在过去,研发并落地这样一套分布式版本控制系统,通常需要一家大公司投入几十上百名工程师、历经数年迭代迁移才能完成。我们认为,这种由极小团队驱动的快速、敏捷迁移在未来会变得越来越普遍。
2. 工程师的价值丝毫没有降低,但工作重心正在发生改变。 参与这个项目的所有工程师现在都一致认为:单论**写代码(writing code)**这件事,Claude 已经比他们写得更好了。但工程师依然提供了不可替代的核心价值——理解跨系统的高层组件交互、把握架构设计层面的权衡取舍(tradeoffs),并围绕“我们要解决什么真正的问题”和“我们必须达到怎样的扩展规模”做出关键决策。
很多时候,我们发现工程师最重要的职责其实是对 Claude 说“不”。Agent 有时会为了凑出某个看似跑得通的实现,去违背系统的核心架构约束,写出那些从一开始就绝不该被允许的模式。这在我们的迁移过程中尤为常见:比如有好几个外围系统在需要查询“某次改动是什么时候合并进 main 分支”时,试图通过暴力线性扫描提交日志(commit log)来硬查,而不是去调用我们代码审查工具提供的接口。此外,Anthropic 内部广泛使用对抗性代码审查(adversarial review,让多个 AI 审查者专门挑刺找漏洞),这套机制在很多方面极其有效,但有时也会显得目光短浅——为了防御某个纯属假设的边缘风险,Claude 会顺着审查意见把系统的某些部分改得过度工程化(over-engineering)。例如,有一次审查对另一个内部服务表现出了过度的防御性不信任,结果导致 Claude 加上了大量冗余的校验逻辑和复杂度,这时就需要有经验的工程师及时叫停并把方向拉回来。现在,我们的团队成员依然会审查系统的每一个变更请求,但大家审查的重点已经从“逐行读代码语法”转向了审视改动的整体意图(intent)与架构边界。
3. 系统的性能优化与测试质量达到了前所未有的高度。 正因为 Claude 编写海量代码的速度远超人类,Scion 成为了我们职业生涯中测试最完备、防御最严密的代码库之一。哪怕工期如此紧张,我们依然为曾经遇到过的每一种复杂的底层设施交互与版本控制边界场景构建了完全密闭的仿真测试(hermetic simulations),并配齐了模糊测试(fuzzing)和精细的限流机制(rate limiting)。不仅如此,Claude 还经常顺手找出重大的性能优化点——比如它曾发现某类提交血缘查询(ancestry queries)漏用了一个索引,并给出了算法级优化;这种问题如果靠资深专家去分析调优,往往要花上好几天甚至好几周,而 Claude 第二天又在其他模块重现了同样的神勇表现。
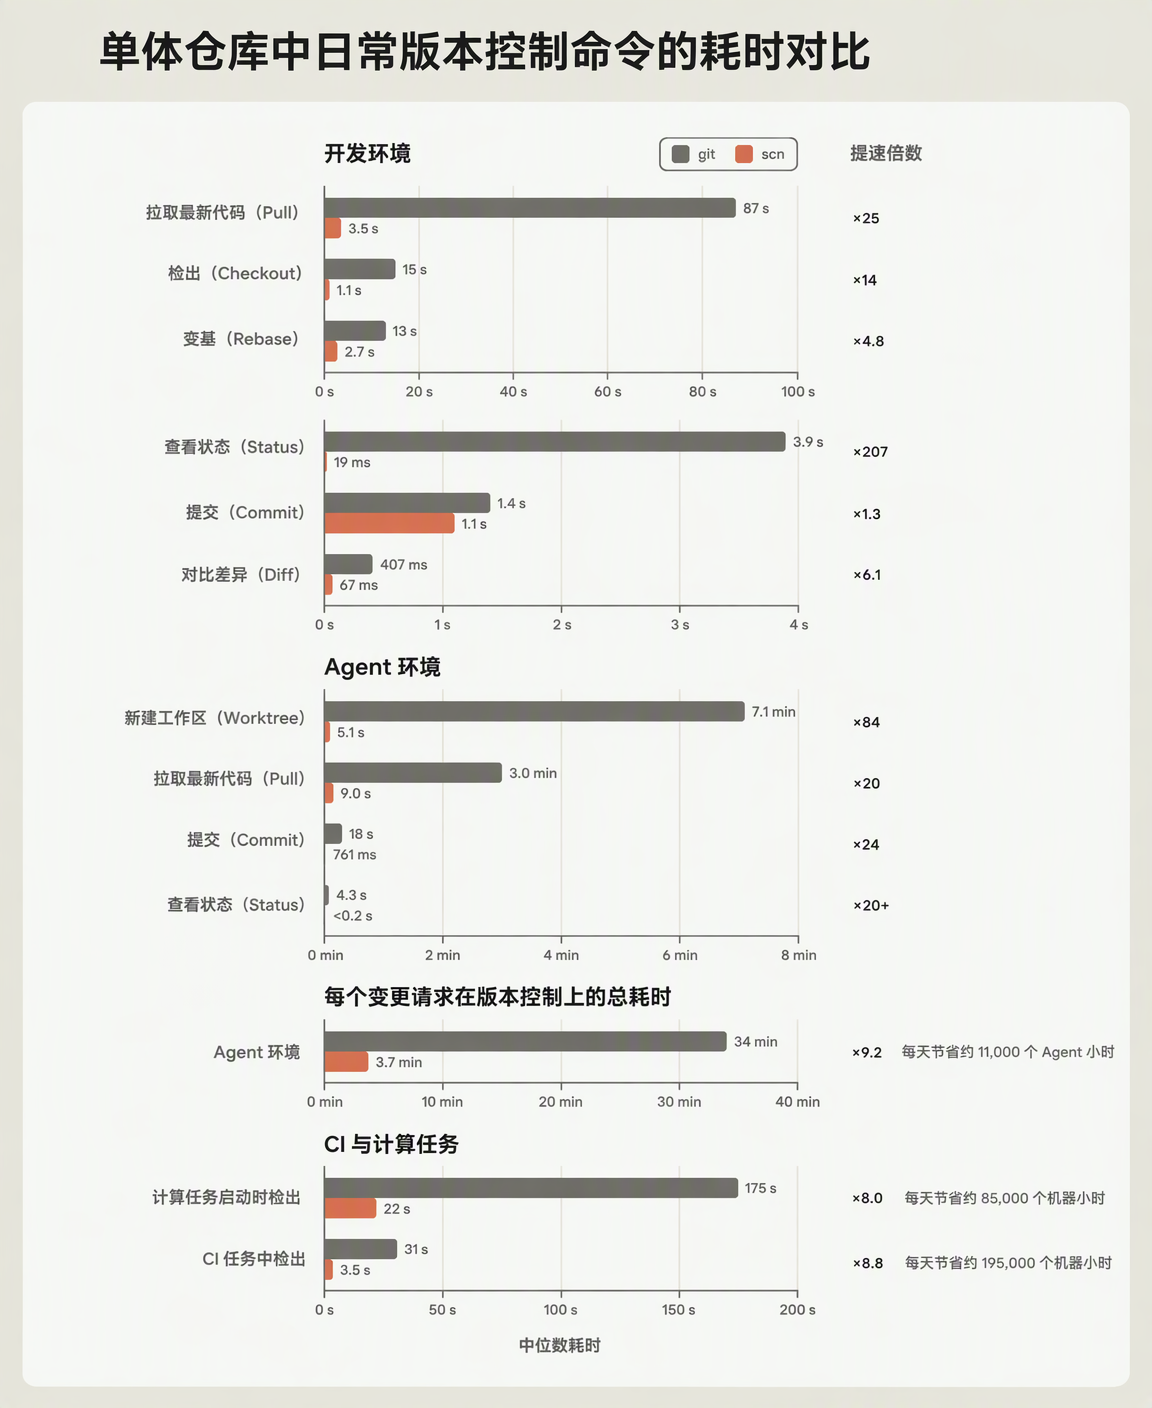
上图展示了单体仓库迁移到原生 Scion 后,日常版本控制操作在开发环境、Agent 环境以及 CI/计算任务中的中位数耗时对比。为了方便大家直观对照 Git 与 Scion(命令行工具为 scn)的常用命令及实测差距,我们整理了如下对照说明:
# 1. 拉取最新主干代码(开发环境耗时从 87s 降至 3.5s,提速 25 倍;Agent 环境从 3.0min 降至 9.0s,提速 20 倍)
git pull
scn pull

# 2. 检出指定分支或版本(开发环境从 15s 降至 1.1s,提速 14 倍;CI 任务从 31s 降至 3.5s,提速 8.8 倍)
git checkout <revision>
scn checkout <revision>

# 3. 变基到最新主干(开发环境从 13s 降至 2.7s,提速 4.8 倍)
git rebase main
scn rebase main

# 4. 查看当前工作区状态(开发环境从 3.9s 降至 19ms,提速 207 倍!)
git status
scn status

# 5. 提交代码改动(Agent 环境从 18s 降至 761ms,提速 24 倍;Scion 直接在服务端生成变更集,无需 git push)
git commit -m "feat: update cache" && git push
scn commit -m "feat: update cache"

# 6. 为并行 Agent 创建独立工作区(Agent 环境从 7.1min 降至 5.1s,提速 84 倍!)
git worktree add ../agent-task-1
scn worktree add ../agent-task-1
# 中文说明:综合下来,每个变更请求在 Agent 环境中的版本控制总耗时从 34 分钟骤降到 3.7 分钟(提速 9.2 倍),
# 每天直接为 Anthropic 节省约 11,000 个 Agent 小时与约 280,000 个机器小时(85,000 计算任务小时 + 195,000 CI 小时)。
4. 为全新的单体仓库安全管控打下了地基。 在超大规模单体仓库中,管理安全性、权限隔离与合规性,和应对数据体量扩张同样重要。我们在构建 Scion 时从第一天起就把安全能力纳入了底层设计:它不仅支持丰富的仓库级访问控制,还能将读写权限精确下沉到单个子目录级别,让我们既能严密保护最核心的敏感代码,又不会丧失单体仓库跨项目协作的优势。此外,我们配套构建的代码审查工具支持用复杂的语义约束来定义审批规则,从而自动区分“仅修改注释的简单改动”与“涉及核心逻辑的敏感改动”,让人类审查者把精力集中在真正影响重大的改动上。
5. 运维卓越性(Operational Excellence)迈上了新台阶。 我们的团队重度使用 Claude Tag 来监控系统的每一个组件。举个例子,我们在 Slack 里建了一系列专门的频道,给每个频道里的 Claude 指派一项极其专注的任务:死磕某一个单一组件的健康状态。我们把这些 Claude 称作组件的**“超级粉丝(superfans)”**——我们有专门盯 scion-daemon 的超级粉丝、专门盯 scion-cache 的超级粉丝、专门盯 Antique 合并队列的超级粉丝等等。它们直接接入了我们的遥测指标(telemetry)和实时日志,表现得就像一位经验极其丰富、而且全天唯一爱好就是不停刷新监控图表寻找蛛丝马迹的资深工程师。当然,我们依然保留了传统的静态阈值告警,但在“超级粉丝”能够敏锐捕捉到的微妙异常和新型故障面前,传统告警显得过于单薄和平面了。
6. 我们正在彻底重塑对研发流程的固有认知。 这个项目促使我们重新审视其他按“人类规模”设计的传统流程。举个最典型的例子:传统的合并队列(merge queue)在 Agent 规模下已经不太讲得通了。 当一次测试还在运行的短短几分钟里,主干上就已经有几百甚至上千个改动合并进去时,传统的合并前 CI 究竟还意味着什么?在实际运作中,我们已经无法像行业标准做法那样,靠在合并队列上加一把“全局仓库锁”来串行验证每一个提交;相反,我们把重心转向了合并后(post-merge)与部署前(pre-deploy)的自动化测试。这确实意味着并发合入的改动之间可能会产生冲突,但实际情况是:Claude 自动修复这些冲突的速度,往往比人类发现冲突的速度还要快。
回馈更广泛的开发者生态
面对日新月异的 AI Agent 带来的工程规模挑战,Scion 只是我们交出的其中一部分答卷。我们之所以把这些架构细节公开分享出来,是希望为同样在思考类似挑战的工程团队提供一个真实样本——尽管我们非常清楚,我们的具体方案和取舍并不适合直接照搬到所有公司。
对于通用场景而言,Scion 绝不是用来替代 Git 的。我们在文中阐述的这些设计理念,只有在体量真正极其庞大的单体仓库(要么拥有数万名人类工程师,要么有成群结队的 AI Agent 在昼夜不停地高产写代码)中才有意义。更何况,Anthropic 自身有一个非常特殊的条件:我们在内部研发上愿意且能够投入的 Token 消耗量,远超任何普通商业公司在现阶段愿意承担的成本。我们这么做,既是为了解决自身的软件研发需求,也是为了在极限高压场景下锤炼和测试 Claude 的能力边界。
从现实落地的角度看,我们也很难把 Scion 直接打包成一个对其他企业开箱即用的通用开源产品。因为它在底层模型上与 Git 分道扬镳,任何公司要想直接采用它,就得把整个软件开发生命周期里的每一环全都迁移一遍,并配套替换掉自己的代码审查、代码搜索和 CI 系统。我们内部使用的这些配套组件都带有极强的内部定制色彩,外部团队很难直接接入;而如果我们试图为了迎合所有人的需求去改造出一个大而全的公开版本,最终做出来的东西反而可能谁都觉得不好用。
不过我们预计,在接下来的 6 到 12 个月内,这类由 Agent 规模引发的基础设施瓶颈会在行业里变得越来越普遍。如果让每一家使用 Git 的公司都各自从零去趟一遍同样的坑,显然是对工程资源的巨大浪费。正因如此,我们认为当下最有价值的贡献,就是把我们的底层思考毫无保留地分享出来,让广大开发者和工具团队能够在不脱离 Git 整体生态模型的前提下,将 Scion 最成功的核心设计思想引入 Git:
- Git 服务端不必复刻客户端的工作方式:完全可以构建全新的 Git 服务端架构来实现数量级的扩展能力提升;
- 标准化的服务端查询 RPC:各大代码托管平台(Git forges)可以像 Scion 一样提供完备的服务端版本控制查询 RPC,甚至形成跨平台的标准化接口,让未来的 Git 客户端直接调用;
- 更高效的拉取协商与稀疏组合:对象拉取的协商协议不必永远停留在今天的形态,Git 现有的各类稀疏检出(sparse checkout)与浅克隆(shallow clone)特性也完全可以被打磨得能够无缝组合使用。
最后,我们要向 Git 社区致以崇高的敬意——过去近二十年里,正是 Git 社区的不懈努力,才让这一平台成功支撑起了全球数千万开发者的日常协作。相比之下,我们所做的只是一小步探索:分享当“软件开发生命周期”撞上“AI 指数级增长曲线”时我们最前线的早期观察,并期待与 GitHub、GitLab 以及广大开源社区携手合作,共同支撑开发者不断演进的新需求。在这场变革中,我们所有人都在同一条船上。
注释与致谢
- 关于变更集仅记录相对于第一个父节点的文件变动:这是我们在工程上做出的取舍。在采用基于主干开发(trunk-based development)的单体仓库实践中,我们发现开发者和自动化工具几乎只关心主干主线(main line)上的提交历史与
blame溯源。 - 关于先驱项目:具体而言是 Meta 开源的 Sapling 版本控制系统中的服务端组件 Mononoke。它开创了我们在 Scion 中使用的许多核心技术,尤其是将提交历史与全量目录树解耦的 Bonsai 数据模型。
本文由 Nick G. 与 Anthropic 源码版本控制团队共同撰写,团队成员包括:S.G.、R.K.、Dan C.、Garrett H.、Ben L.、Colin M.、Joe P.。特别感谢 Vilas J. 与 Sergiu D. 在这段雄心勃勃的旅程中对版本控制团队的大力支持,以及 Amir O. 对 Antique 的早期贡献。