 OpenAI 团队
Codex CLI 是 OpenAI 打造的跨平台本地编程 Agent,核心目标是安全、高效地在开发者的本地电脑上运行,并稳定交付高质量的代码变更。
自今年 4 月首次发布这款命令行工具以来,我们在构建生产级编程 Agent 的过程中踩过不少坑,也沉淀了一套行之有效的工程方法。为此,我们推出了这组技术拆解系列文章。作为开篇之作,本文将带你深入 Codex 的内部机制,剖析它的底层运转原理与关键架构取舍。(如果你想直接查阅源码实现,可以访问我们的开源仓库:https://github.com/openai/codex,许多具体的设计权衡都完整记录在 GitHub Issues 和 Pull Requests 中。)
第一篇我们将聚焦于 Agent 核心循环(Agent Loop)——它是 Codex CLI 的中枢引擎,负责协调用户、大模型与本地工具三者之间的全部交互。希望通过这次拆解,能帮你看清底层的运行框架(Harness)在驾驭大语言模型(LLM)时究竟扮演着怎样的角色。
在正式展开前,先简要统一一下术语:在 OpenAI 内部,“Codex”既代表一整套软件 Agent 产品矩阵(涵盖 Codex CLI、Codex Cloud 以及 Codex VS Code 插件),也指代它们共享的底层运行框架(Harness)。这套框架封装了最核心的 Agent 循环与执行逻辑,并通过 Codex CLI 开源提供。为了行文简洁,下文提到的“Codex”与“Codex CLI”均指代这一核心运行框架。
导读:本文拆解了 Codex 驱动智能体运转的四大工程支柱
- 核心循环与会话生命周期:一次用户提问对应一个对话轮次(Turn),内部往往包含多轮“模型推理 ↔ 工具调用”的闭环迭代,而它真正的交付物往往是直接落在本地磁盘上的代码变更。
- 上下文的分层组装:Codex 在调用
Responses API时,会按严格的优先级(system→developer→user→assistant)把沙盒权限、全局配置、跨目录聚合的AGENTS.md、技能(Skills)以及本地运行环境拼装成结构化提示词。- 无状态架构与提示词缓存(Prompt Caching):为了原生兼容企业级的零数据保留策略(ZDR),Codex 放弃了有状态的
previous_response_id,转而通过“只追加、不原地修改”的上下文设计保证精确前缀匹配(Exact Prefix Match),将多轮推理的算力开销从平方级($O(N^2)$)压降至线性级($O(N)$)。- 自动上下文压缩(Compaction):当长对话逼近上下文窗口上限时,Codex 会调用
/responses/compact端点,利用带加密潜层状态的type=compaction数据块替换冗长的历史记录,在不丢失任务记忆的前提下释放上下文空间。
Agent 核心循环(The Agent Loop)
几乎所有 AI Agent 的底座,都是一套被称为 Agent 循环(Agent Loop) 的执行机制。把细节抽离后,它的主干流程可以用下面这张图来概括:
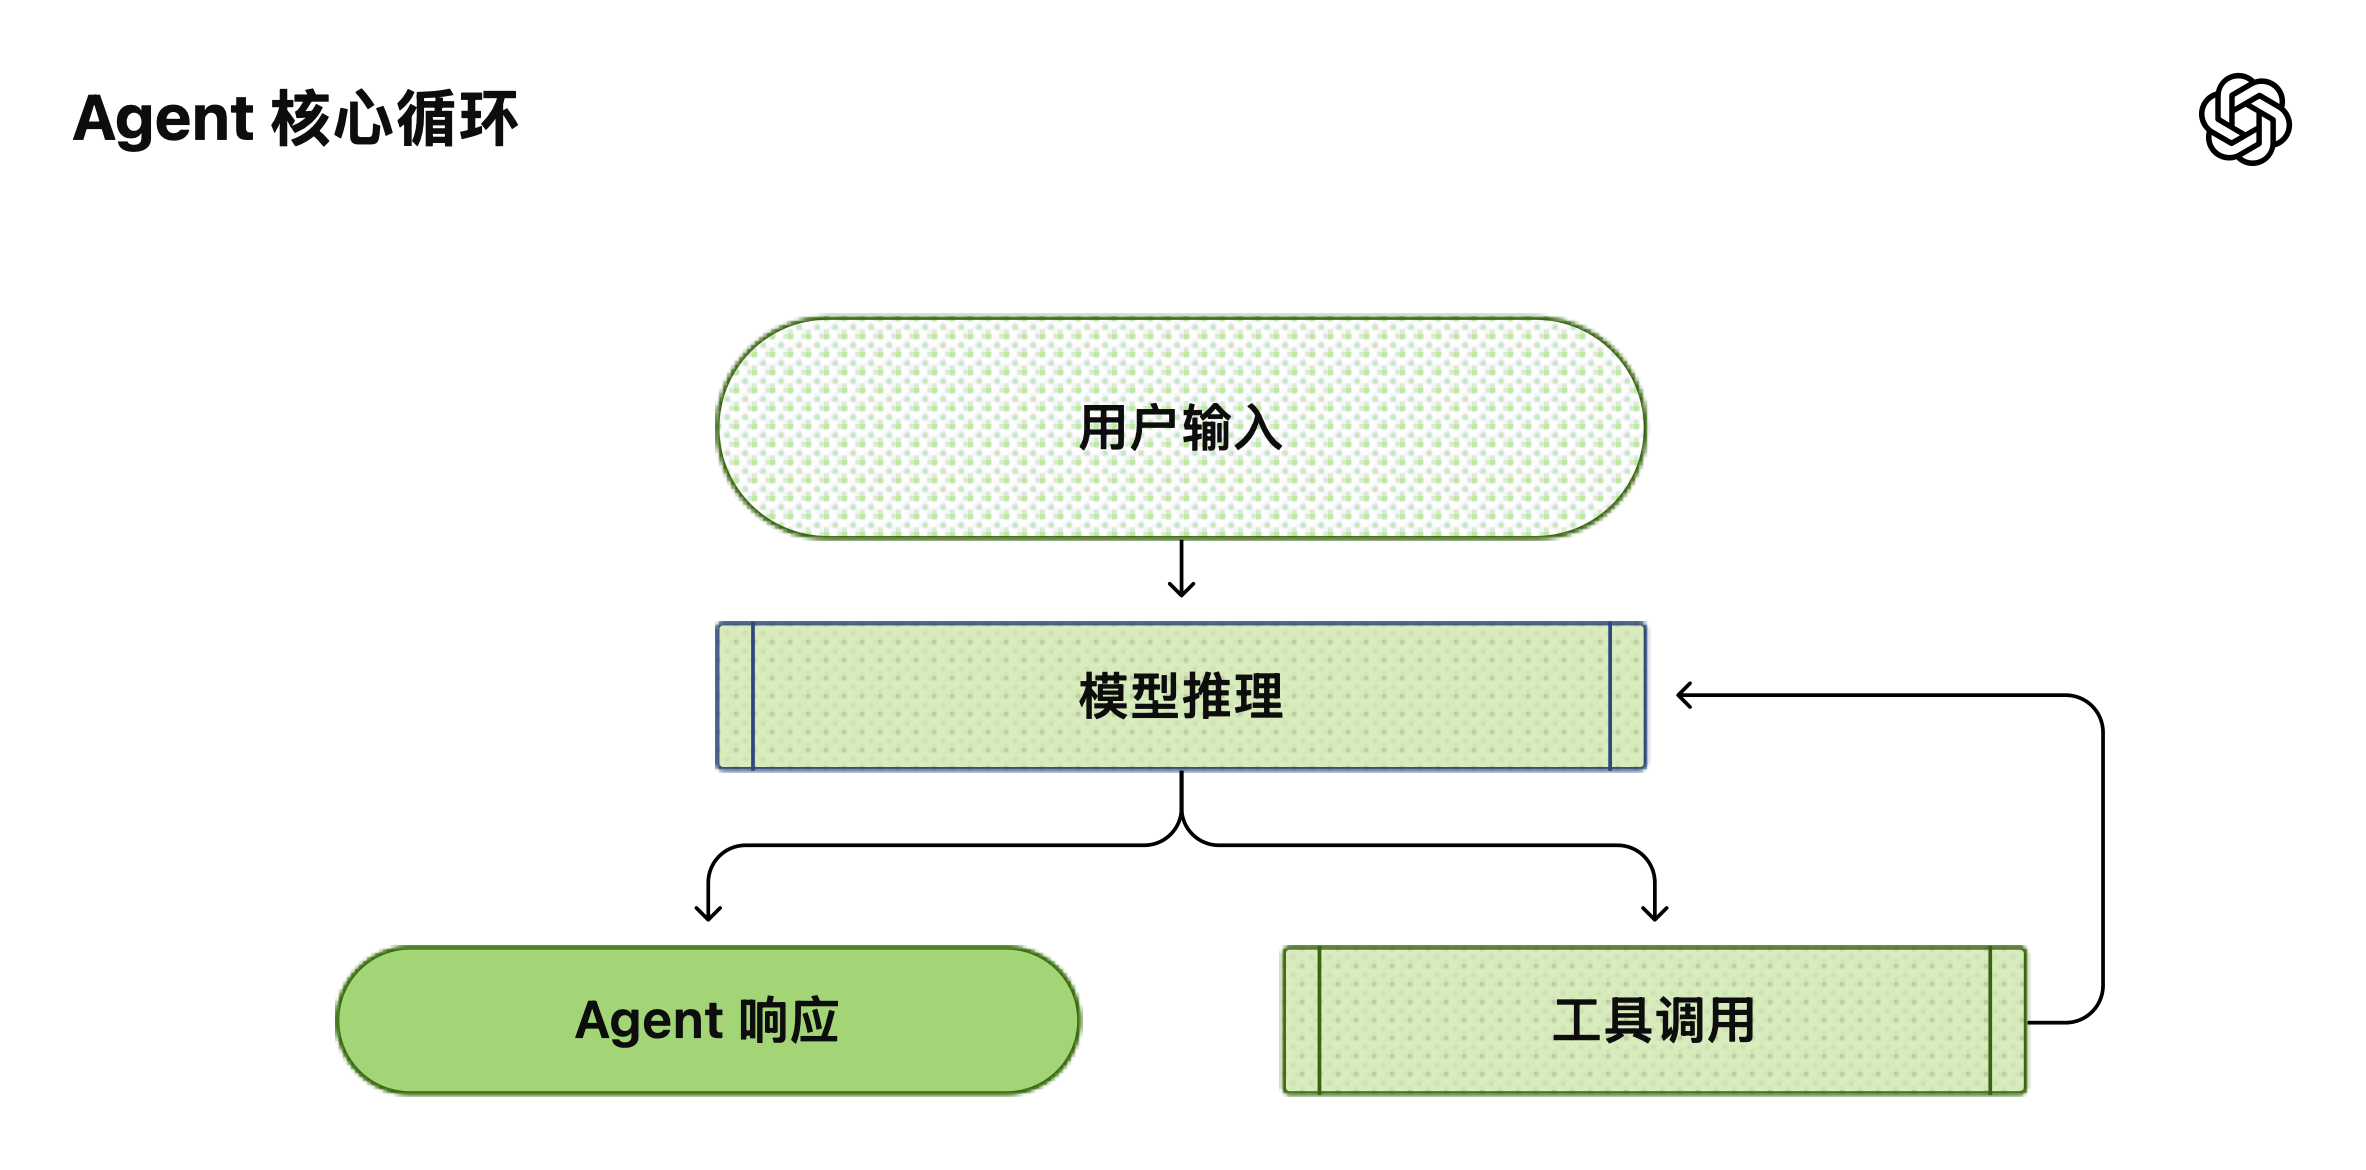
整个循环按以下步骤推进:
- 组装提示词(Prompt):Agent 先接收用户的原始输入,并结合当前上下文,将其整理成一组可供大模型理解的文本指令,也就是提示词(Prompt)。
- 执行模型推理(Inference):Agent 将提示词发送给模型,请求生成回答。在推理阶段,文本提示词会先被切分并编码为一串输入 Token(模型处理文本的最小词元单位,本质上是映射模型词表的整数索引);随后模型基于这串输入 Token 进行采样计算,逐个生成新的输出 Token。
- 流式解码输出:生成的输出 Token 会被实时解码回人类可读的文本。由于 Token 是逐个产出的,解码过程可以与模型生成同步进行,这也是为什么绝大多数大模型应用都能做到流式输出(Streaming)。在实际工程中,底层 API 会直接接收和返回文本,把繁琐的 Token 编解码细节屏蔽在接口内部。
一轮模型推理结束后,通常会走向两个分支之一:
- 分支一:直接给出最终答复,回应用户的初始请求;
- 分支二:请求执行工具调用(Tool Call),例如向运行框架发出指令:“执行
ls命令并把输出结果发给我”。
如果走向分支二,Agent 运行框架就会在本地环境中执行对应的工具调用,并将拿到的工具执行结果追加到原有提示词末尾,拼成一份更新后的上下文,再次发给模型开启新一轮推理。
这个“模型推理 ↔ 工具调用”的闭环会不断迭代,直到模型认为不再需要调用工具,转而输出一条面向用户的总结消息——在 OpenAI 的接口体系中,这被称为助手回复(Assistant Message)。大多数情况下,这条消息是对用户任务的完成汇报,但有时也会是模型向用户发出的追问。
由于 Codex 能够调用直接修改本地文件系统的工具,它的核心“产出物”其实并不局限于终端里打印出来的那条助手回复。在绝大多数开发场景下,编程 Agent 最核心的交付物,是它直接在你电脑上新建或修改的源码文件。不过,无论中间修改了多少文件,每一个执行周期最终都会以一条助手回复收尾(例如汇报 “已按你的要求新增 architecture.md 文件”),这标志着当前 Agent 循环正式进入终止状态(Terminal State)。此时,Agent 的本轮任务宣告完成,终端控制权重新交还给用户。
上图中从“接收用户输入”到“返回助手回复”的完整周期,在交互层面被称为一次对话轮次(Turn,在 Codex 内部也称为一个对话线程 Thread)。一次对话轮次内部,可能包含数十乃至上百次“模型推理 ↔ 工具调用”的循环迭代。而当你在同一场会话中继续追问、开启下一轮对话时,之前所有轮次积累的用户消息、模型思考、工具调用及输出结果,都会作为历史上下文完整并入新一轮的提示词中:
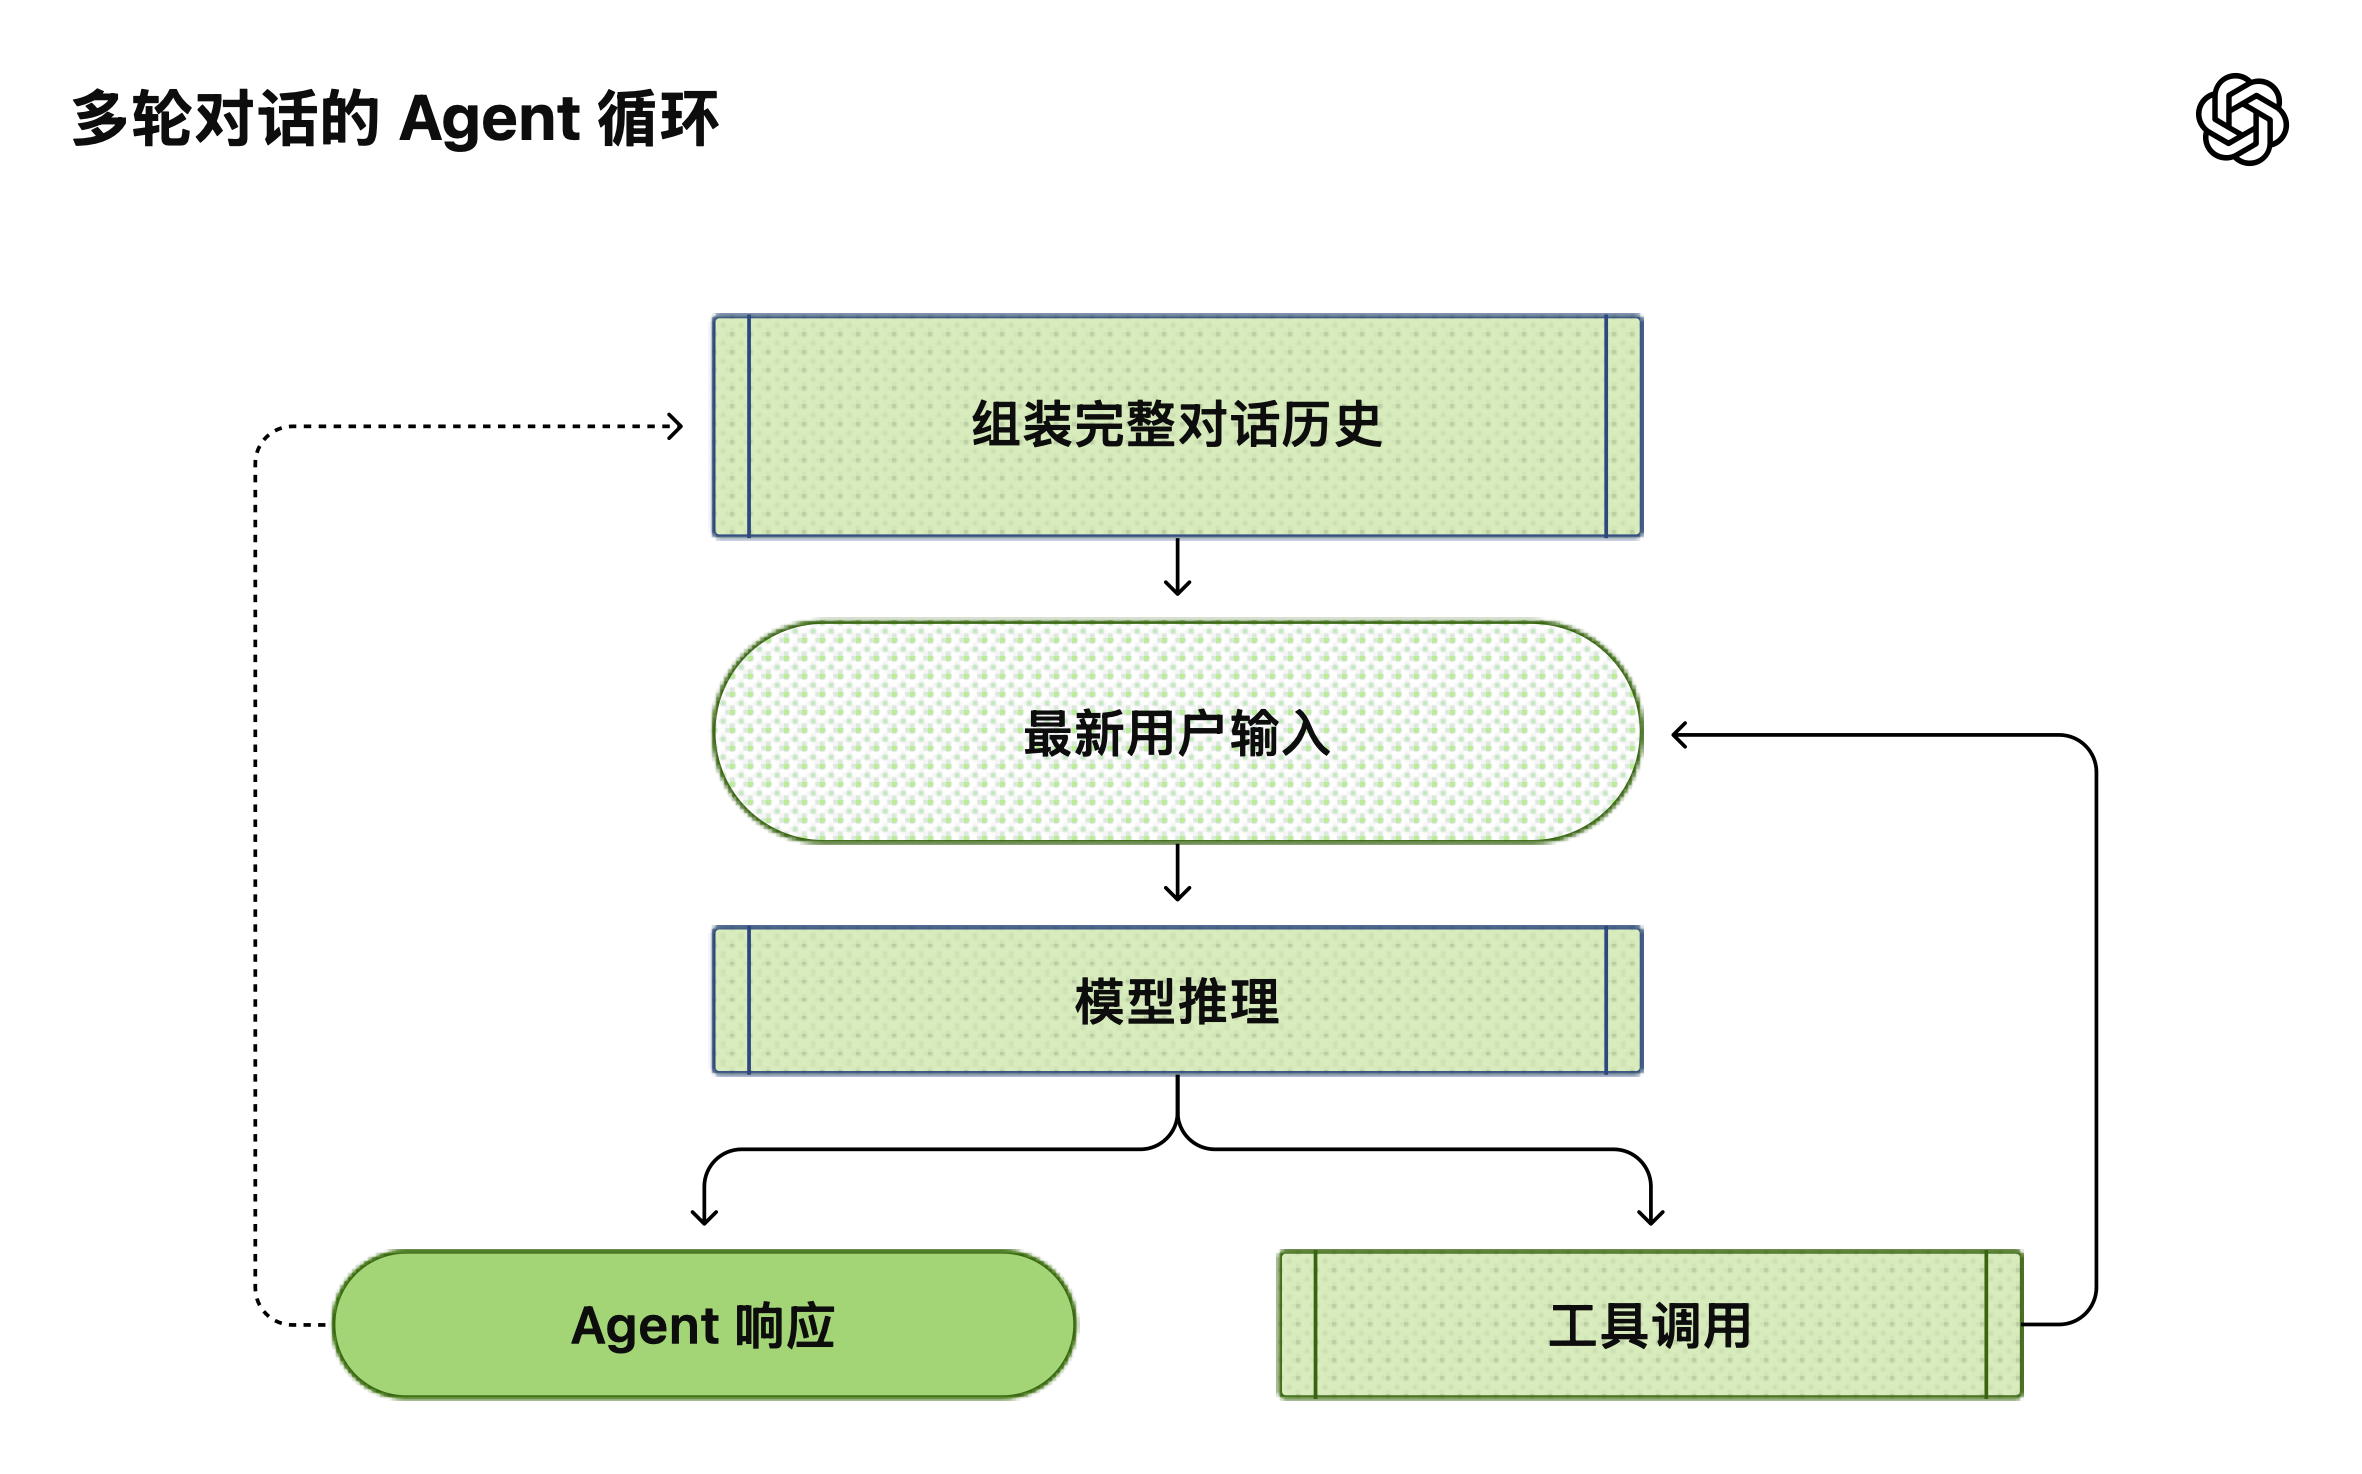
这就带来了一个关键的工程挑战:随着对话轮次不断推进,每次发给模型做推理的提示词会滚雪球般越来越长。
提示词的长度之所以至关重要,是因为每个大模型都有固定的上下文窗口(Context Window,即单次推理请求所能容纳的输入与输出 Token 总量上限)。要知道,在一个复杂的编程任务中,Agent 往往在单轮对话里就会发起上百次命令执行与文件读写,极其容易把上下文窗口撑爆。因此,上下文窗口的精细化管理,是决定一个 Agent 能否胜任真实工程任务的核心职责。
接下来,我们就钻进 Codex 的源码内部,看看它是如何借助 Responses API 跑通并优化这套循环的。
模型推理与端点架构
在底层实现上,Codex CLI 通过向 Responses API(OpenAI 专为多步推理与工具调用设计的模型接口)发送 HTTP POST 请求来驱动模型推理。
为了让不同环境的开发者都能顺畅使用,Codex CLI 将 Responses API 的服务端点(Endpoint)设计成了完全可配置的架构。这意味着只要后端服务遵循 OpenResponses 标准规范,Codex 就能无缝对接:
- 使用 ChatGPT 账号登录时:Codex CLI 默认将请求发送至
https://chatgpt.com/backend-api/codex/responses。 - 使用 OpenAI API Key 认证时:Codex CLI 默认将请求发送至
https://api.openai.com/v1/responses。 - 使用
--oss参数运行本地开源模型时:配合 gpt-oss(并结合 Ollama 0.13.4+ 或 LM Studio 0.3.39+ 使用),默认端点会指向本地运行的http://localhost:11434/v1/responses。 - 对接企业云平台时:Codex CLI 同样支持直接配置并连接 Azure 等云服务商托管的
Responses API实例。
搞清楚请求发往哪里之后,我们来看看 Codex 是如何为一轮对话的第一次推理请求组装初始提示词的。
构建初始提示词(Building the Initial Prompt)
作为开发者,当你调用 Responses API 时,并不需要手动把所有内容拼接成一长串纯文本提示词。相反,你只需要在请求中传入结构化的输入项,服务端会自动将这些信息组装成模型底层所需的提示词序列。
你可以把最终喂给模型的提示词想象成一个有序的数据项列表(List of Items)。在初始提示词中,列表里的每一项都绑定了一个 role(角色)属性,用来决定该项内容在模型注意力中的指令优先级。优先级从高到低依次为:
system > developer > user > assistant。
具体来说,Responses API 的创建接口接收一个 JSON 请求体(Payload),其中最核心的是以下三个顶层参数:
instructions:注入到模型上下文顶部的系统级或开发者级核心指令。tools:模型在生成回答过程中有权调用的工具定义列表。input:提供给模型的文本、图像、文件以及历史交互记录列表。
我们逐一拆解 Codex CLI 是如何构造这三个参数的。
1. instructions:模型专属的基础指令
在 Codex 中,instructions 字段支持两种加载方式:如果用户在 ~/.codex/config.toml 中显式配置了 model_instructions_file,Codex 就会直接读取该文件的内容;如果没有指定,则会回退使用与当前所选模型绑定的内置 base_instructions。
这些针对不同模型深度调优的基础指令直接维护在 Codex 源码仓库中,并随 CLI 二进制包一起分发(例如专为 GPT-5.2 Codex 调优的 gpt-5.2-codex_prompt.md)。
2. tools:三类工具的统一注册
tools 字段是一个遵循 Responses API JSON Schema 规范的工具声明数组。在 Codex 的运行环境中,这份列表通常会汇聚三大来源的工具:
- Codex CLI 内置的本地工具(如执行终端命令的
shell、管理任务进度的update_plan); - 由
Responses API原生提供的托管工具(如联网搜索web_search); - 用户通过 MCP 服务器接入的自定义扩展工具(MCP,即 Model Context Protocol,模型上下文协议,用于将外部工具与数据源按统一标准接入大模型)。
一个典型的 tools 声明列表如下所示:
[
  // 1. Codex 默认内置的 shell 工具,用于在本地派生新进程执行命令
  // 源码实现:codex-rs/core/src/tools/spec.rs
  {
    "type": "function",
    "name": "shell",
    "description": "Runs a shell command and returns its output...",
    "strict": false,
    "parameters": {
      "type": "object",
      "properties": {
        "command": {"type": "array", "description": "The command to execute", ...},
        "workdir": {"description": "The working directory...", ...},
        "timeout_ms": {"description": "The timeout for the command...", ...},
        ...
      },
      "required": ["command"],
    }
  },

  // 2. Codex 内置的任务计划管理工具
  // 源码实现:codex-rs/core/src/tools/handlers/plan.rs
  {
    "type": "function",
    "name": "update_plan",
    "description": "Updates the task plan...",
    "strict": false,
    "parameters": {
      "type": "object",
      "properties": {"plan":..., "explanation":...},
      "required": ["plan"]
    }
  },

  // 3. 由 Responses API 原生提供的联网搜索工具
  {
    "type": "web_search",
    "external_web_access": false
  },

  // 4. 用户在 ~/.codex/config.toml 中配置的外部 MCP 服务器工具(以天气查询为例)
  {
    "type": "function",
    "name": "mcp__weather__get-forecast",
    "description": "Get weather alerts for a US state",
    "strict": false,
    "parameters": {
      "type": "object",
      "properties": {"latitude": {...}, "longitude": {...}},
      "required": ["latitude", "longitude"]
    }
  }
]
(相关源码可参阅 Codex 的默认 Shell 工具定义、内置 Plan 工具实现以及 OpenAI 的 Web Search 工具文档。)
3. input:按层级注入的环境与项目上下文
JSON 请求体中的 input 字段同样是一个有序数组。在真正把用户的提问放进 input 之前,Codex 会先按固定顺序向 input 数组依次注入以下 4 类上下文消息:
- 沙盒权限说明(
role=developer):向模型明确说明当前沙盒的读写与网络边界。需要特别注意的是,Codex 的沙盒机制仅约束tools列表中由 Codex 内置提供的shell工具;对于外部接入的其他工具(例如来自 MCP 服务器的工具),Codex 沙盒不会拦截,必须由对应工具自身负责安全防护。 这条消息由内置模板动态渲染而成,核心片段取自随 CLI 打包的 Markdown 规范文件,例如workspace_write.md(工作区写入模式)和on_request.md(按需审批策略):
<permissions instructions>
  - description of the sandbox explaining file permissions and network access
  - instructions for when to ask the user for permissions to run a shell command
  - list of folders writable by Codex, if any
</permissions instructions>- 自定义开发者指令(
role=developer,可选):如果用户在config.toml中配置了developer_instructions字段,Codex 会将其作为第二条开发者消息插入此处。 - 多源聚合的用户与项目指令(
role=user,可选):这条消息并非读取自单一文件,而是按“从全局到局部”的顺序聚合多个来源的规则文档——越贴近当前目录的具体规则,在文本中排得越靠后:- 全局配置目录
$CODEX_HOME下的AGENTS.override.md与AGENTS.md内容; - 在体积上限(默认 32 KiB)范围内,从当前工作目录(
cwd)所属的 Git 仓库根目录(或项目根目录)出发,沿着目录树逐级向下扫描直至cwd本身,依次拼入沿途每个目录中的AGENTS.override.md、AGENTS.md(或config.toml中通过project_doc_fallback_filenames指定的回退文档); - 如果配置了任何 Codex 技能(Skills),还会依次附加上:一段简短的技能导言、每个已注册技能的技能元数据(Metadata),以及一段指导模型何时与如何调用技能的说明章节。
- 全局配置目录
- 本地运行环境上下文(
role=user):向模型告知 Agent 当前所处的本地系统环境,主要包括当前工作目录(cwd)与用户默认 Shell 类型:
<environment_context>
  <cwd>/Users/mbolin/code/codex5</cwd>
  <shell>zsh</shell>
</environment_context>
完成上述 4 项初始化上下文的装配后,Codex 最后才把用户本轮输入的原始提问追加到 input 数组末尾,正式开启新一轮对话。
上面的例子主要展示了消息体内部的文本结构。在实际传输的 JSON 中,input 数组的每一个元素都是一个包含 type、role 和 content 字段的标准 JSON 对象。例如最后追加的这条用户提问,结构如下:
{
  "type": "message",
  "role": "user",
  "content": [
    {
      "type": "input_text",
      "text": "Add an architecture diagram to the README.md"
    }
  ]
}
当完整的 JSON 请求体组装完毕后,Codex 会读取 ~/.codex/config.toml 中配置的 Responses API 端点地址,附带 Authorization 认证头(以及用户额外配置的自定义 HTTP Header 与 Query 参数),发出 HTTP POST 请求。
当 OpenAI 的 Responses API 服务器收到这份 JSON 请求后,会在服务端将其展开并推导为模型底层真正消费的提示词序列(注:第三方自定义的 Responses API 服务端实现可能会采用略微不同的内部排布策略):
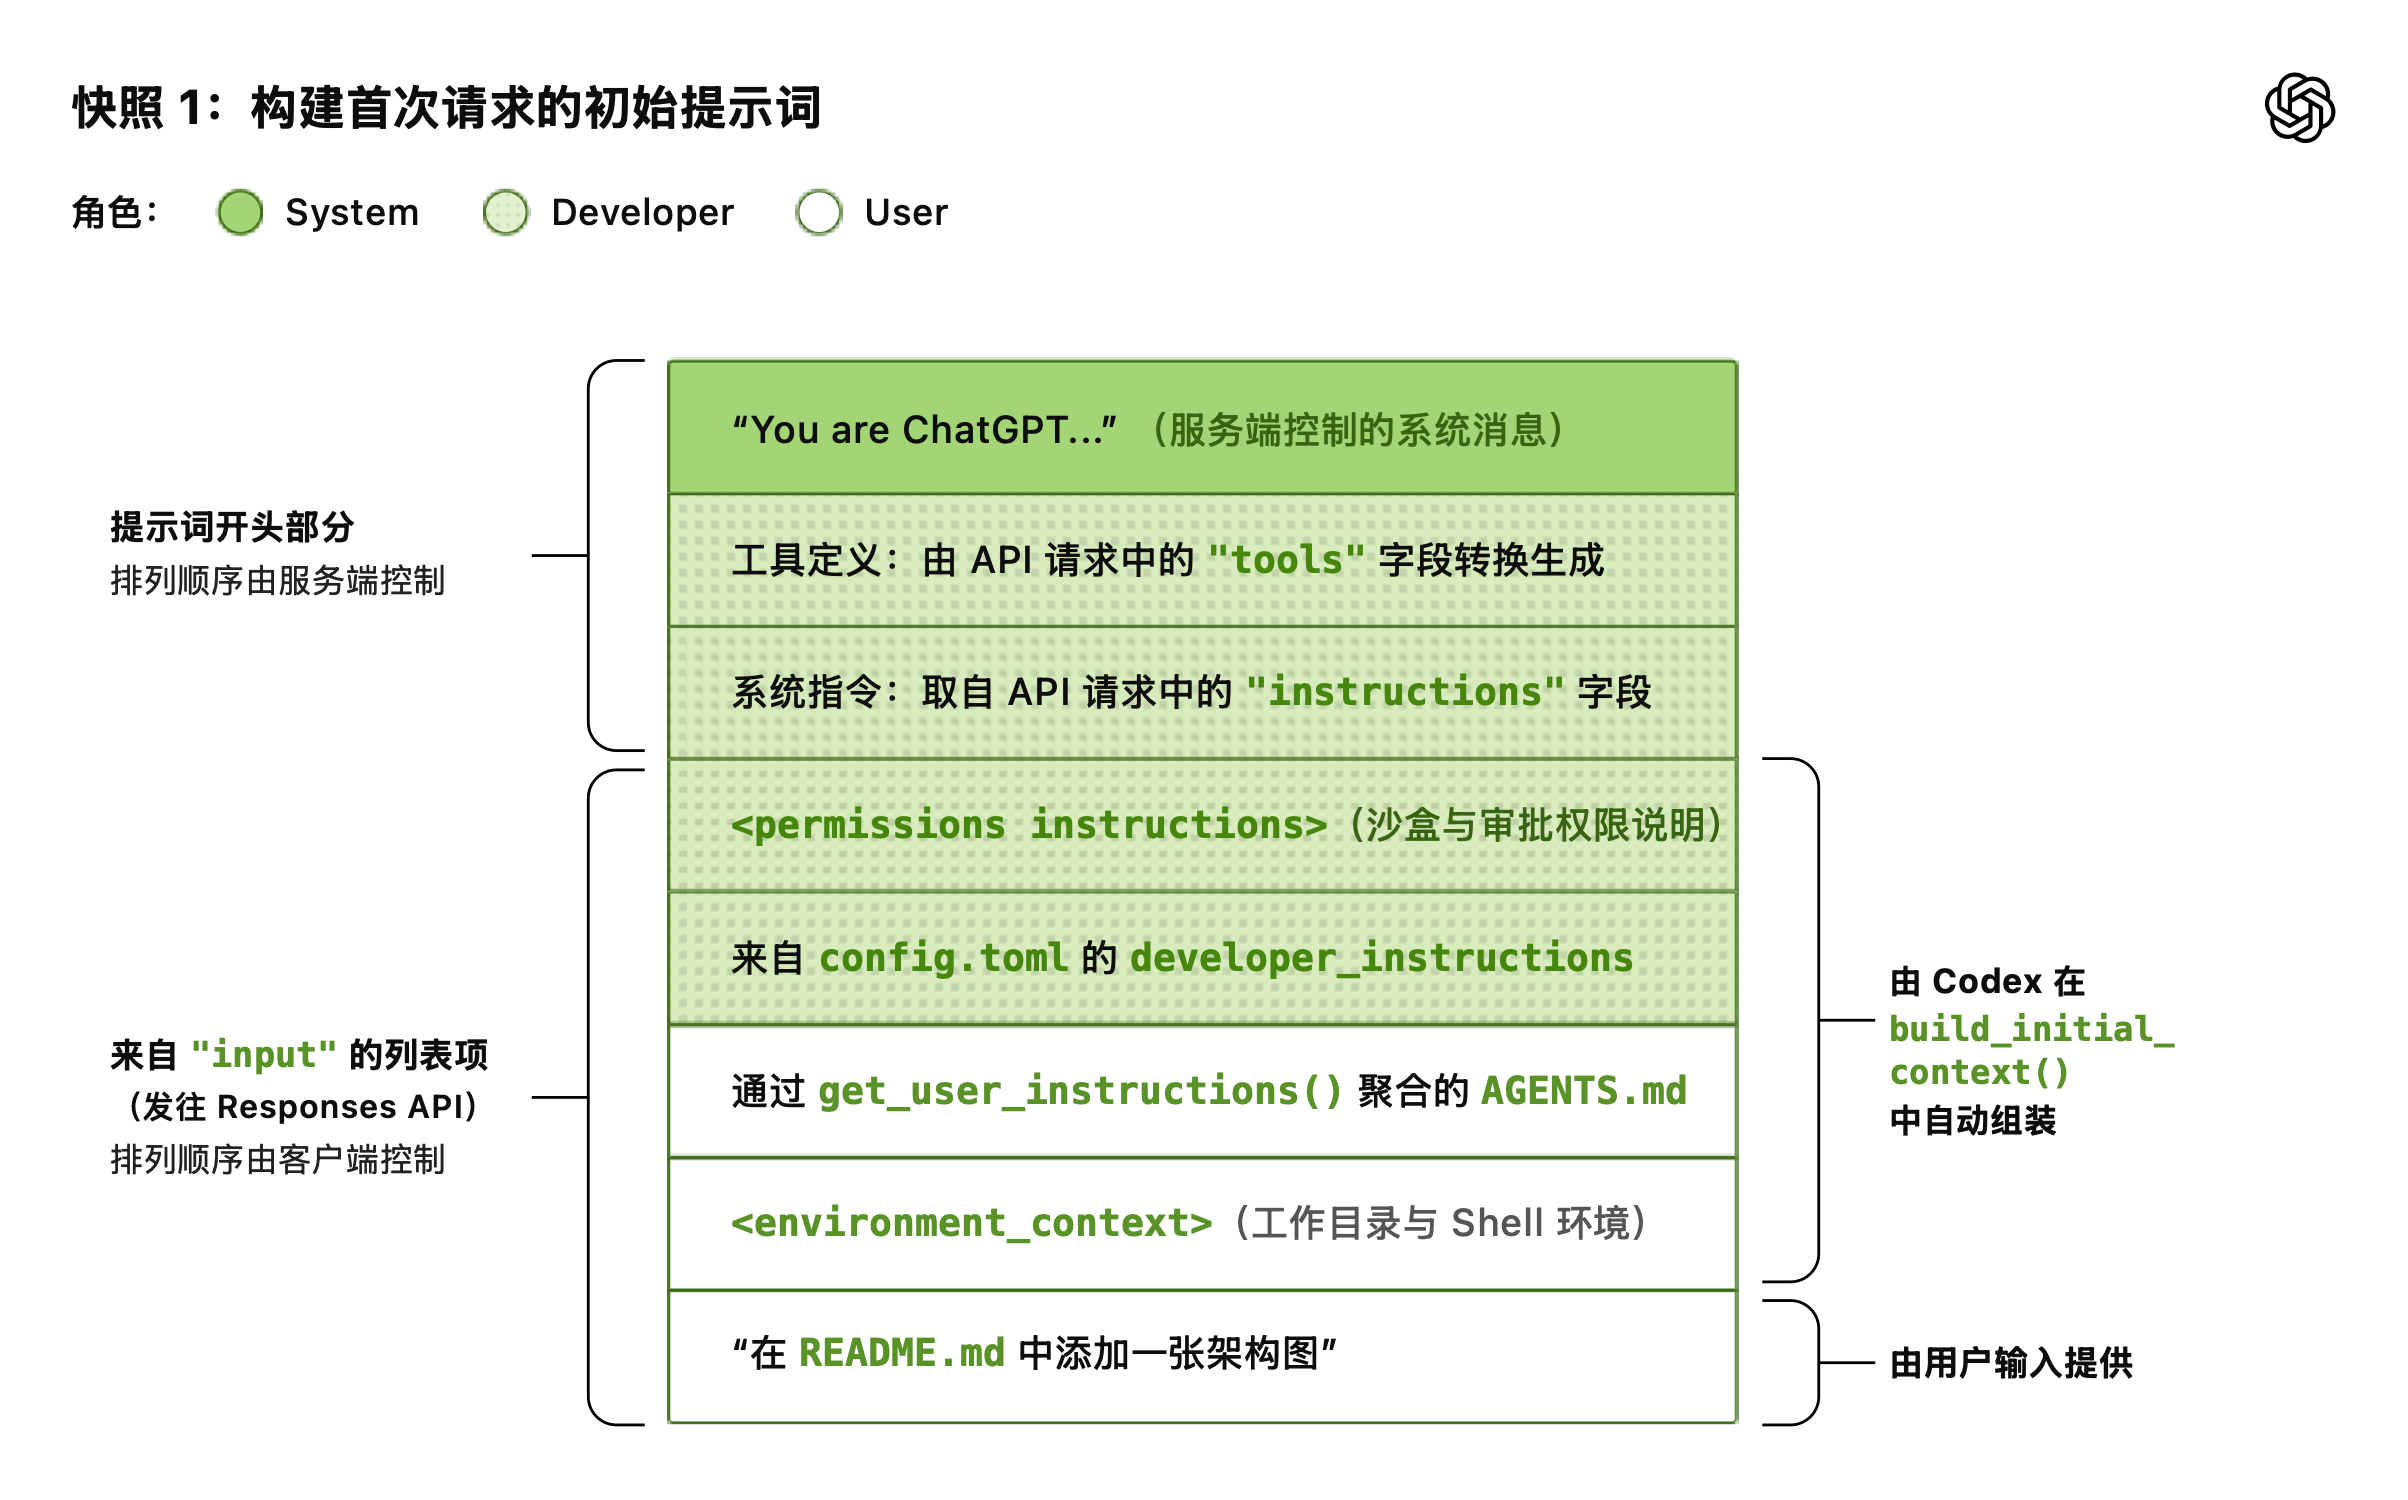
从上图的对照中可以清楚看到:最终提示词最开头的三个模块(服务端系统消息、工具列表 tools、开发者基础指令 instructions),其排列顺序是由服务端决定的,而非客户端。不过在这三项当中,只有最顶部的 system message 内容完全由服务端掌控,tools 和 instructions 的具体内容依然由客户端传入。紧随这三项之后的,就是客户端 JSON 请求体里的 input 数组——两部分合流,共同构成了首次推理的完整提示词。
至此,初始提示词全部就绪,服务端正式开始调用模型生成回答(采样推理)。
第一轮对话的流式运转(The First Turn)
这次发往 Responses API 的 HTTP 请求,正式拉开了 Codex 第一轮对话的序幕。
服务端不会等所有内容生成完毕才一次性返回,而是直接建立一条 SSE(Server-Sent Events,服务端流式推送事件) 数据流。流中的每一个事件都携带一段 data JSON 负载,其 type 字段均以 "response." 开头。一段典型的实时事件流如下所示(完整的事件类型清单可查阅 Responses API 流式文档):
data: {"type":"response.reasoning_summary_text.delta","delta":"ah ", ...}
data: {"type":"response.reasoning_summary_text.delta","delta":"ha!", ...}
data: {"type":"response.reasoning_summary_text.done", "item_id":...}
data: {"type":"response.output_item.added", "item":{...}}
data: {"type":"response.output_text.delta", "delta":"forty-", ...}
data: {"type":"response.output_text.delta", "delta":"two!", ...}
data: {"type":"response.completed","response":{...}}
在客户端一侧,Codex 的 SSE 解析模块会实时消费这条事件流,并将其转化为内部事件分发给上层组件:
- 像
response.output_text.delta和response.reasoning_summary_text.delta这类增量文本事件,会被直接推给终端 UI,实现丝滑的逐字流式渲染; - 而像
response.output_item.added与response.output_item.done这类完整的数据项事件,则会被反序列化为结构化对象,原封不动地追加到input数组末尾,为接下来的下一次Responses API调用做好准备。
举个具体例子:假设模型在第一次推理请求中,先后完成了两个输出项(触发了两次 response.output_item.done 事件):第一个是 type=reasoning(模型的内部思考过程与摘要),第二个是 type=function_call(请求调用本地 shell 工具查看 README.md)。
当 Codex 在本地执行完这条 cat README.md 命令、拿到终端输出后,它会把模型刚才产出的 reasoning、function_call 以及本地执行得到的 function_call_output 一并追加到原有的 5 个初始 input 项后面,发起第二次请求:
[
  /* ... 沿用首次请求中 input 数组原有的 5 个初始项 ... */
  {
    "type": "reasoning",
    "summary": [
      "type": "summary_text",
      "text": "**Adding an architecture diagram for README.md**\n\nI need to..."
    ],
    "encrypted_content": "gAAAAABpaDWNMxMeLw..."
  },
  {
    "type": "function_call",
    "name": "shell",
    "arguments": "{\"command\":\"cat README.md\",\"workdir\":\"/Users/mbolin/code/codex5\"}",
    "call_id": "call_8675309..."
  },
  {
    "type": "function_call_output",
    "call_id": "call_8675309...",
    "output": "<p align=\"center\"><code>npm i -g @openai/codex</code>..."
  }
]
当这第二次请求到达服务端时,推导出的完整提示词序列如下图所示:
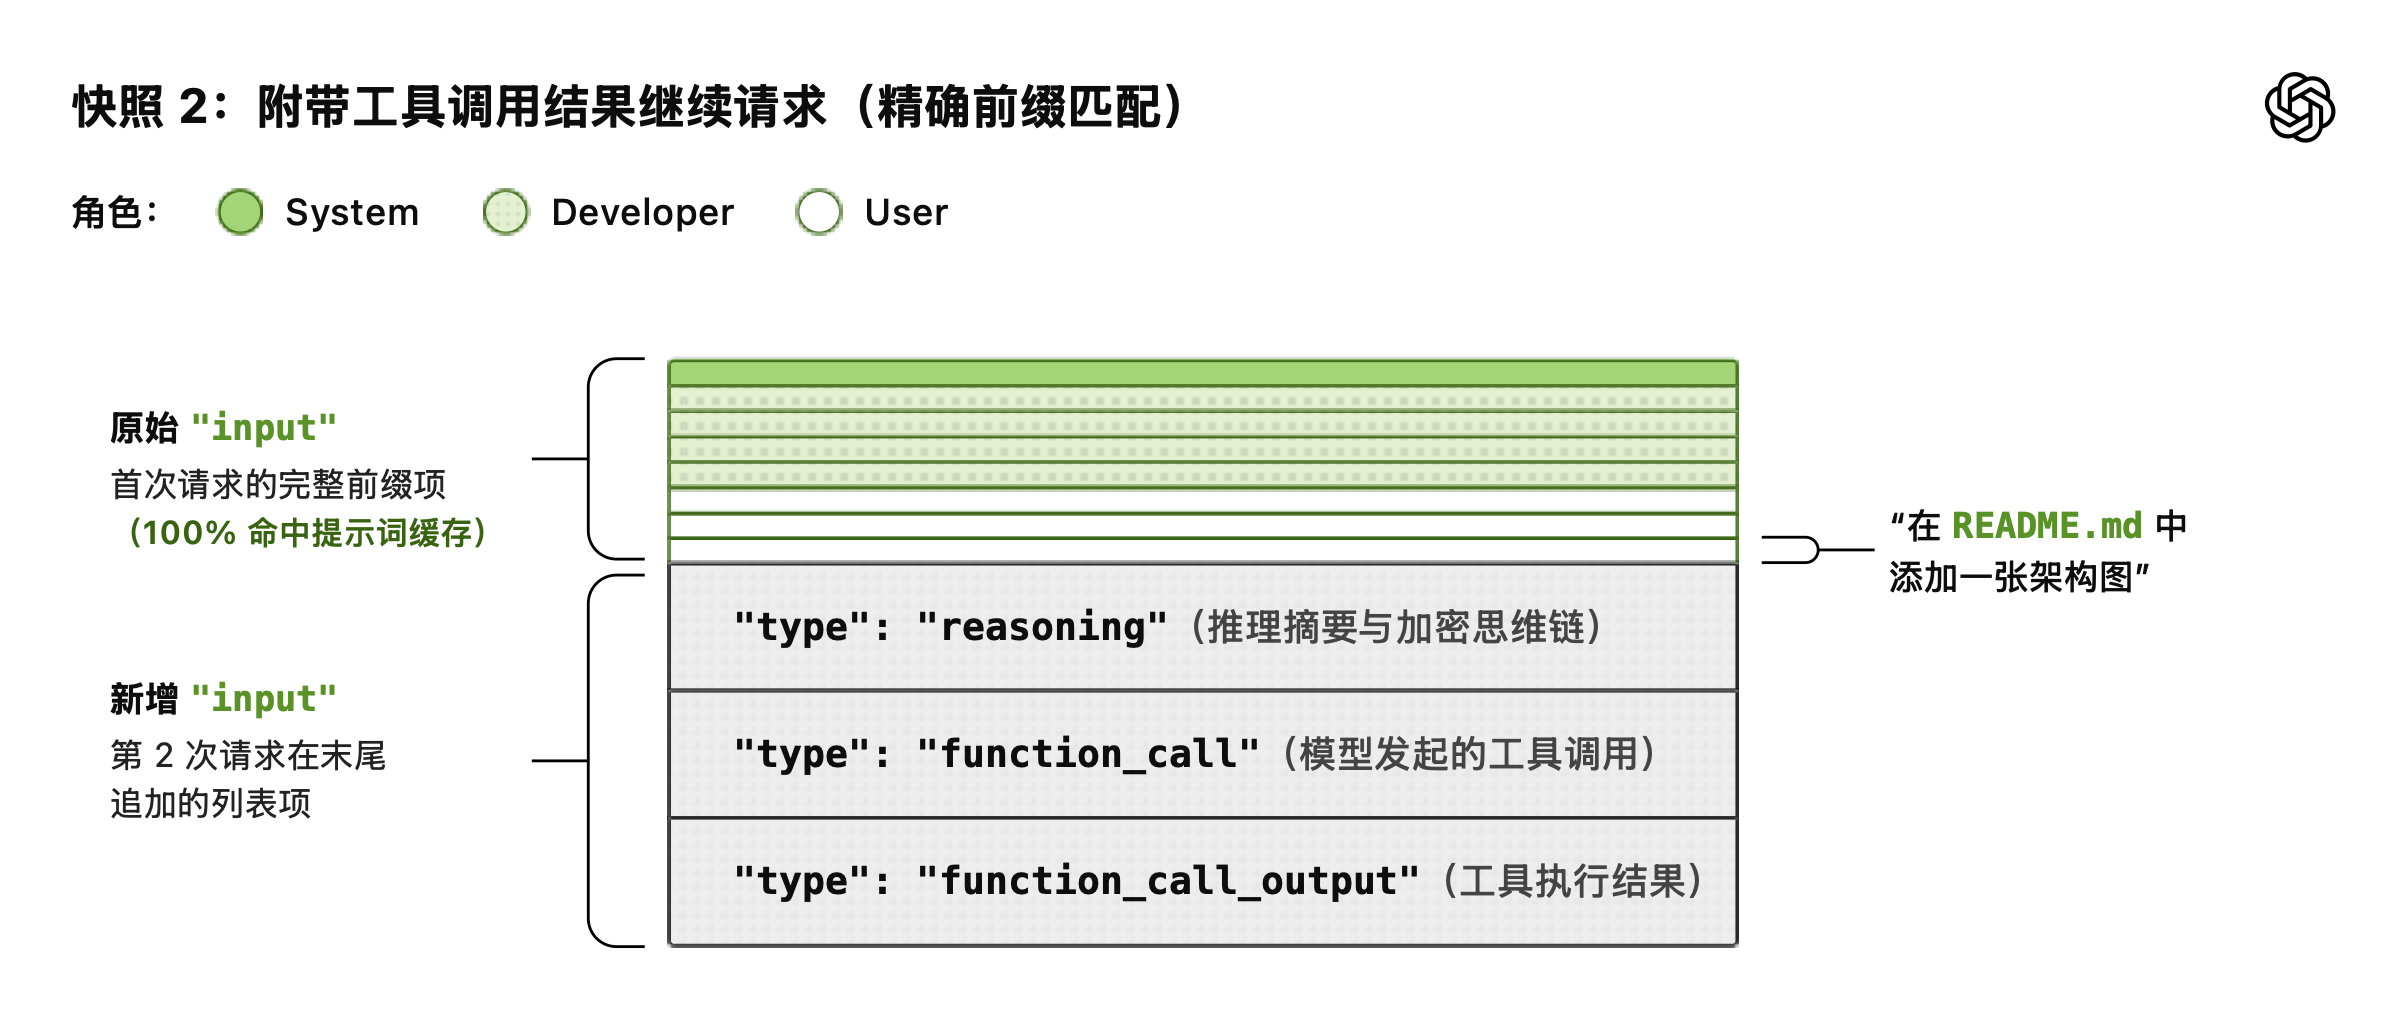
请特别留意上图左侧的括号标注:上一次请求的旧提示词,恰好构成了这一次新提示词一字不差的精确前缀(Exact Prefix)。
这种“只追加、不改动前文”的结构绝非巧合,而是 Codex 极其核心的工程设计——因为它能让后续每一次请求都最大化命中提示词缓存(Prompt Caching),将重复计算开销降到最低(下一节我们会深入算这笔性能账)。
回到第一张 Agent 循环图,模型在拿到 README.md 的内容后,可能会继续发起多次工具调用(比如查看源码目录、修改文件、运行测试),提示词序列也会随之不断向后追加增长,直到模型最终返回一条不再包含工具调用的助手回复,标志着第一轮对话圆满结束:
data: {"type":"response.output_text.done","text": "I added a diagram to explain...", ...}
data: {"type":"response.completed","response":{...}}
在 Codex CLI 的终端界面中,这条助手回复会展示给用户,同时光标自动聚焦回输入框,等待用户的下一条指令。如果用户接着输入了修改意见(开启第二轮对话),那么上一轮末尾的助手回复(role=assistant)以及用户刚刚输入的新消息(role=user),都会继续追加到 input 数组末尾:
[
  /* ... 完整保留上一次 Responses API 请求中的所有 input 项 ... */
  {
    "type": "message",
    "role": "assistant",
    "content": [
      {
        "type": "output_text",
        "text": "I added a diagram to explain the client/server architecture."
      }
    ]
  },
  {
    "type": "message",
    "role": "user",
    "content": [
      {
        "type": "input_text",
        "text": "That's not bad, but the diagram is missing the bike shed."
      }
    ]
  }
]
再看一眼此时的服务端提示词全景图,随着多轮对话与工具调用的层层叠加,发往 Responses API 的 input 列表正在持续拉长:
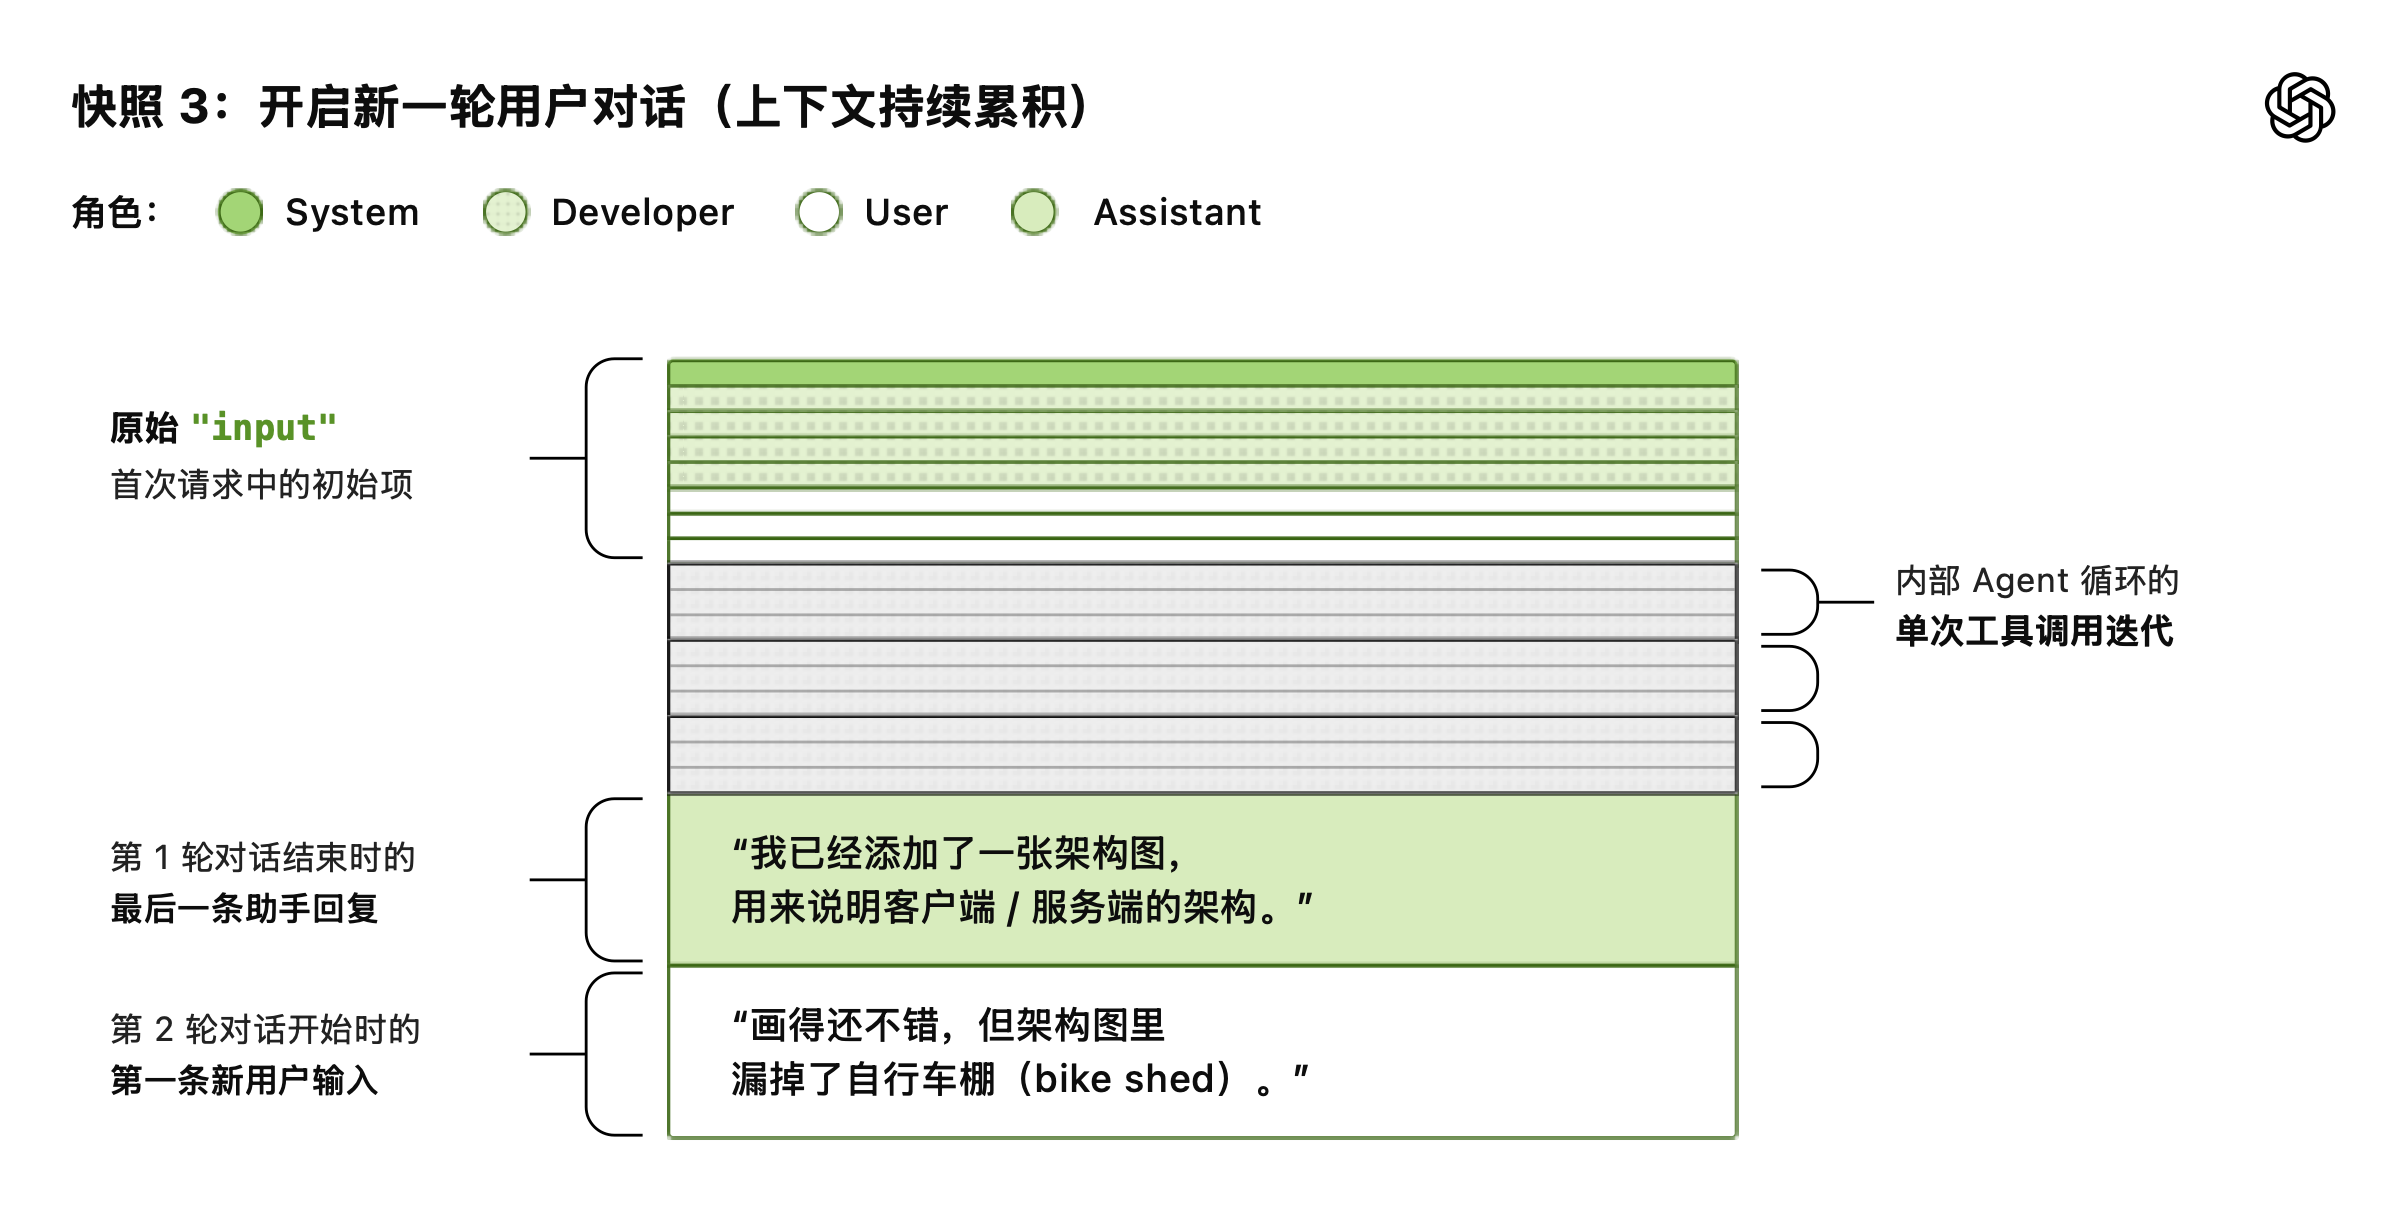
那么问题来了:这样一个不断膨胀的提示词序列,究竟会对系统性能和上下文容量造成多大的冲击?我们又是如何化解的?
性能考量与上下文压缩(Performance Considerations)
看到这里,对算法敏感的读者恐怕已经产生了一个疑问:
“如果每次请求都要把从头到尾的完整对话历史重发一遍,那整个会话周期里发往 Responses API 的 JSON 数据总量,岂不是呈平方级($O(N^2)$)增长?”
这个直觉完全正确。
事实上,Responses API 原生提供了一个可选的 previous_response_id 参数,允许客户端只传增量消息、由服务端关联历史状态来避免重复传输。但 Codex 目前刻意选择不使用 previous_response_id,背后的核心考量有两个:保持所有 HTTP 请求完全无状态(Stateless),以及原生支持零数据保留策略(ZDR,Zero Data Retention)。
为什么这么做?
- 简化多后端适配:不依赖
previous_response_id,意味着任何兼容Responses API的服务端都不需要维护复杂的会话状态存储,大大降低了第三方或本地开源推理引擎的接入成本。 - 严守企业级 ZDR 合规底线:对于启用了零数据保留策略(ZDR)的企业客户而言,服务端严禁落盘存储任何客户会话内容;一旦依赖
previous_response_id,服务端就必须在数据库里保存上一轮的上下文,这与 ZDR 原则直接冲突。
你可能会问:如果不保存服务端状态,ZDR 客户还能享受到推理模型(Reasoning Models)跨轮次复用内部思维链的优势吗?答案是完全不受影响。
回看前面代码片段里的 type=reasoning 对象,除了人类可读的 summary 摘要外,它还携带了一段不透明的 encrypted_content(加密思维链内容)。客户端每次将其原样传回,服务端只需用内存中保存的客户专属密钥实时解密,就能完整恢复模型在之前轮次的深层推理状态——OpenAI 只保存解密密钥,绝不留存客户的业务数据。(关于 Codex 支持 ZDR 的具体实现细节,可参阅 PR #642 和 PR #1641。)
靠“精确前缀匹配”把推理成本从 $O(N^2)$ 降到 $O(N)$
在真实的大模型系统中,GPU 采样推理的计算成本远远高于传几百 KB JSON 的网络带宽成本。因此,优化的核心靶心不是减少 HTTP 请求体的字节数,而是避免 GPU 重复计算已经处理过的历史 Token。
这正是 提示词缓存(Prompt Caching) 发挥决定性作用的地方。只要命中提示词缓存,服务端就能直接复用此前推理请求算好的 KV Cache(键值缓存,即模型推理时保存历史 Token 注意力计算结果的内存状态),将整个会话期间的模型推理计算开销从平方级复杂度($O(N^2)$)直接压降为线性复杂度($O(N)$)。
正如我们在《提示词缓存开发指南》中所强调的黄金法则:
缓存命中(Cache Hit)的前提,是新旧提示词之间存在严格的“精确前缀匹配(Exact Prefix Match)”。 为了最大化缓存收益,请务必将系统指令、工具定义、少样本示例等静态内容固定在提示词最开头,而把用户输入、工具输出等动态变化的内容追加在提示词末尾。这一原则同样适用于图片和工具列表——它们在连续多次请求之间必须保持完全一致。
理解了“精确前缀匹配”的严苛要求后,我们就能一眼看出哪些操作会破坏前缀一致性,导致 Codex 遭遇代价高昂的缓存未命中(Cache Miss):
- 在对话中途增删或修改模型可用的
tools列表(因为tools排在提示词的第 2 项,改动它会使其后所有内容的缓存全部失效); - 在对话中途切换目标模型(
model)(这会直接改变排在提示词第 3 项的模型专属基础指令instructions); - 直接原地修改初始的沙盒配置、审批模式或当前工作目录消息。
正因如此,Codex 团队在为 CLI 引入任何新特性时,都会把“是否破坏提示词缓存”作为一条硬性红线来审查。举个真实的踩坑案例:我们在早期接入 MCP 工具时,曾因为存储工具列表的数据结构没有固定排序,引入了一个每次请求枚举 MCP 工具顺序不一致的 Bug(PR #2611),直接导致后续缓存全部失效。
更棘手的是,MCP 协议允许外部服务器随时通过 notifications/tools/list_changed 通知动态更新其提供的工具列表。如果在一场已经积累了几万 Token 的长对话中途立即响应这个通知、改写顶部的 tools 数组,就会瞬间击穿整条对话的缓存,造成严重的延迟抖动与算力浪费。
那么,如果用户在对话中途确实修改了沙盒权限或切换了工作目录,Codex 怎么在不破坏前缀缓存的前提下通知模型呢?
答案依然是“只向 input 尾部追加新消息,绝不回头修改历史消息”:
- 当用户在会话中途更改了沙盒配置(Sandbox Mode)或审批策略(Approval Policy)时,Codex 不会去改动
input开头的第 1 条消息,而是在当前input数组的末尾追加插入一条全新的role=developer消息,内部依然采用相同的<permissions instructions>标签格式声明最新权限。 - 当用户的当前工作目录(
cwd)发生变化时,Codex 同样会在input数组末尾追加插入一条全新的role=user消息,用<environment_context>标签告知模型最新的目录路径。
通过这种“追加覆盖(Append-Only Override)”的设计,前缀里的每一个历史字节都纹丝不动,缓存命中率得到了最大程度的保障。
上下文窗口的救星:自动压缩(Compaction)
保住了缓存命中率,我们还必须面对另一道物理极限:模型的上下文窗口终有被填满的一天。
为了防止长任务中途因为 Token 超限而崩溃,我们的核心策略是上下文压缩(Compaction):一旦监测到当前对话消耗的 Token 总量突破预设水位线,就用一份体积浓缩得多的新 input 列表替换掉原本冗长的历史记录,让 Agent 既能记住此前完成的关键进展,又能腾出充足的窗口空间继续干活。
在演进过程中,Codex 的上下文压缩经历了两代架构:
- 第一代:手动触发的摘要压缩(
/compact) 在早期的压缩实现(PR #1527)中,用户需要手动输入/compact命令。触发后,Codex 会把当前积累的完整对话历史连同一份专门编写的总结提示词(SUMMARY.md)发给Responses API,让模型生成一段详尽的任务交接摘要;随后 Codex 将这条包含摘要的助手回复作为全新的input起点,开启后续轮次。 - 第二代:基于
/responses/compact端点的潜层状态自动压缩 随着架构演进,Responses API专门推出了原生支持高效压缩的/responses/compact端点。调用该端点后,服务端会返回一个精简后的压缩数据项列表(Compacted Object List),可以直接用来无缝替换原有的长input,大幅释放上下文窗口:
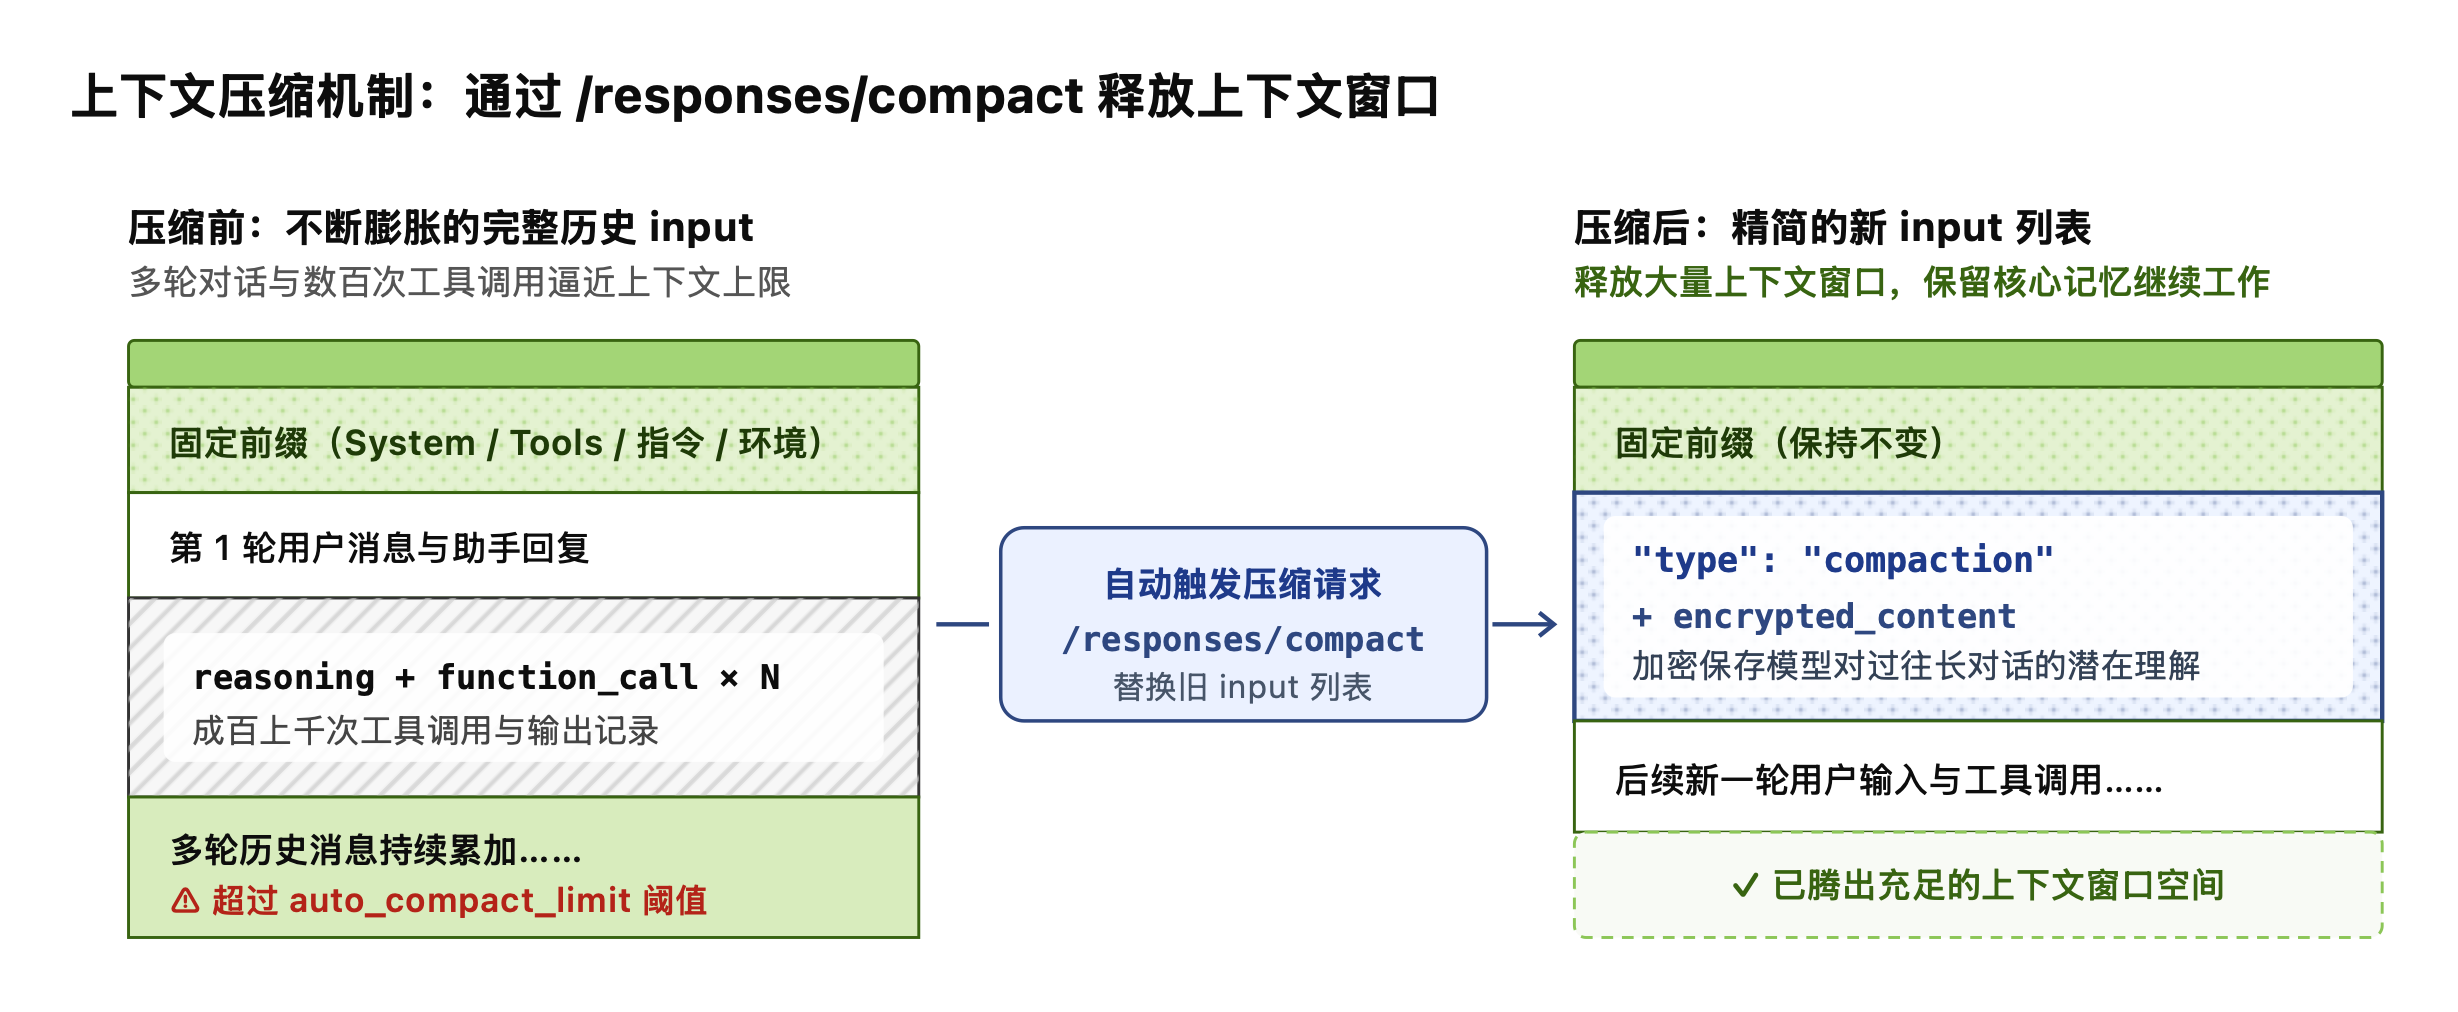
在这份返回的精简列表中,包含了一个极其关键的特殊数据项:type=compaction。它内部携带了一段不透明的 encrypted_content 加密载荷——不同于第一代仅靠纯文本摘要传递信息,这段加密载荷直接保留了模型对原始长对话的底层潜层理解(Latent Understanding),既大幅压缩了 Token 占用,又避免了纯文本总结常见的细节失真。
如今,这套能力已经完全自动化:只要单次会话累计的 Token 数量超过配置的 auto_compact_limit(自动压缩阈值),Codex 就会在后台自动调用 /responses/compact 完成上下文瘦身,让开发者几乎感知不到长对话的边界。
下期预告
在本文中,我们完整拆解了 Codex 的 Agent 核心循环,顺着一条请求从组装、流式推理、工具调用到多轮累积的生命周期,剖析了 Codex 如何构建并管理模型的上下文,以及在 Responses API 之上打造高性能无状态 Agent 的工程最佳实践。
不过,Agent 循环只是支撑 Codex 运转的第一块基石。在本系列的后续文章中,我们将继续深入 Codex CLI 的内部架构,带你剖析工具调用的底层实现机制,并深入审视 Codex 的本地安全沙盒模型(Sandboxing Model)。
特别感谢参与构建 Codex CLI 的全体团队成员。