 Cognition 团队
本文编译自 Cognition(Devin 背后团队)联合创始人兼联席总裁 Walden Yan 于 2025 年 6 月发表的架构文章 Don't Build Multi-Agents。针对开源社区与企业工程中一股脑采用「主控拆分 + 多子 Agent 并发执行」的风潮,Walden Yan 从 Devin 大规模长周期编码任务的实战教训出发,剖析了多 Agent 架构在真实生产环境中频频失灵的根源,并提炼出决定 Agent 可靠性的两条上下文工程原则。
导读:为什么盲目并发多 Agent 往往不如单线程 + 上下文压缩?
- 原则一:共享上下文(Share context),而且是共享完整的行动轨迹。只把一句孤立的子任务指令丢给子 Agent,就像玩传话游戏——子 Agent 看不到此前尝试过的死胡同与全局意图,很容易做出南辕北辙的假设。
- 原则二:每一个动作都隐含着决策(Actions carry implicit decisions)。让两个互不通气的子 Agent 并行写代码或改设计,哪怕都读了同一份初始背景,各自在推进中做出的隐性取舍(如命名规范、物理碰撞模型、画风细节)也会在合并时撞出严重冲突。
- 长周期任务的可靠解法:写入型任务优先采用「单线程线性主干 + 上下文压缩模型(Context Compression LLM)」,把过时的终端噪音压掉、把关键决策留住;若一定要用子 Agent,请严格限制为只读探索或回答单一明确问题,绝不让多个子 Agent 并发写核心逻辑。
寻找 Agent 时代的「React 哲学」:为什么架构原则比脚手架更重要
回看 Web 前端工程的演进史,有一个极具启发性的时间跨度。HTML 诞生于 1993 年,此后的二十年里,无数开发者在原生 HTML、CSS 与意大利面条式的 DOM 操作脚本中摸爬滚打;直到 2013 年 Facebook 开源了 React,前端开发才迎来真正的范式收敛。到了 2025 年,React 及其衍生框架几乎统治了现代 Web 与客户端应用的构建方式。
为什么 React 能完成这场长达十余年的统治?因为它提供的远不止一套省掉几行样板代码的脚手架,它确立了一套严密的工程哲学。当你选择 React 时,你被迫接受了「声明式 UI」「单向数据流」与「组件化状态隔离」的约束。今天任何一位工程师都会把这些约束奉为理所当然的行业标准,可在早期直接操作 jQuery 节点的年代,这些原则一点也不显眼。
站在 2025 年的时间节点上看大语言模型(LLM)与 AI Agent 工程,整个行业依然处在「手写原生 HTML 与 CSS 并试图把它们拼凑出好体验」的蛮荒阶段。如果你想跑通一个 5 分钟的玩具级 Agent 演示,社区里有成百上千篇教程和开箱即用的脚手架;可一旦进入严肃的企业级生产环境,试图让 Agent 在长达数十分钟甚至数小时的复杂任务里保持高可靠性,整个行业还没有形成公认的架构标准。
更糟糕的是,一些极具影响力的开源项目——例如 OpenAI 发布的 openai/swarm 以及微软推出的 microsoft/autogen——正在积极向开发者灌输一种极具诱惑力却往往走向死胡同的构建方式:多 Agent 协作架构(Multi-Agent Architectures)。
许多团队在项目立项的第一天,就迫不及待地画出一张精美的组织架构图:一个负责统筹全局的「产品经理 Agent」、一个负责写前端的「UI 工程师 Agent」、一个负责写后端的「API 工程师 Agent」,外加一个负责挑刺的「测试 QA Agent」。这种拟人化的分工符合人类公司的管理直觉,但在真实的大模型工程中,它往往会制造出一套脆弱不堪、错漏百出的系统。
长周期 Agent 的可靠性根基:从提示词工程走向「上下文工程」
当我们需要让 Agent 在长周期任务中持续运行、调用数十次工具并维持前后一致的对话与状态时,系统的头号敌人是复合误差(Compounding Errors)。只要中间某一步出现轻微的语境偏差,后续的每一次推理和工具调用都会将这个偏差指数级放大,整条任务链条很快就会分崩离析。
决定长周期 Agent 可靠性的核心命门,正是上下文工程(Context Engineering)。
到了 2025 年,主流基座大模型的单次推理智商已经非常惊人。但哪怕是世界上最聪明的人类专家,如果在接手任务时拿不到完整的背景材料、历史决策记录和前因后果,他照样无法把活干好。早期聊天机器人时代流行「提示词工程(Prompt Engineering)」,研究的是人类如何用单次对话把问题描述清楚;而在动态运行的 Agent 系统中,「上下文工程」将这个问题推向了更高的维度:系统如何在不断推进的多轮工具调用与状态变迁中,动态、自动地为每一次模型推理组装最完整、最准确的上下文。这已经成为今天所有 AI Agent 工程师排在第一位的核心工作。
为了看清上下文工程是如何决定系统生死的,我们先来看一种在社区中最流行、看起来最符合直觉的多 Agent 拆分架构:
- 主控 Agent(
Orchestrator Agent)接收用户的顶层任务,将其拆解为多个相互独立的子任务(Subtasks); - 主控 Agent 同时拉起多个并发运行的子 Agent(
Subagent 1、Subagent 2……),分别认领各自的子任务; - 等所有子 Agent 执行完毕后,主控 Agent 收集各路返回的结果,将它们拼装合并成最终产物。
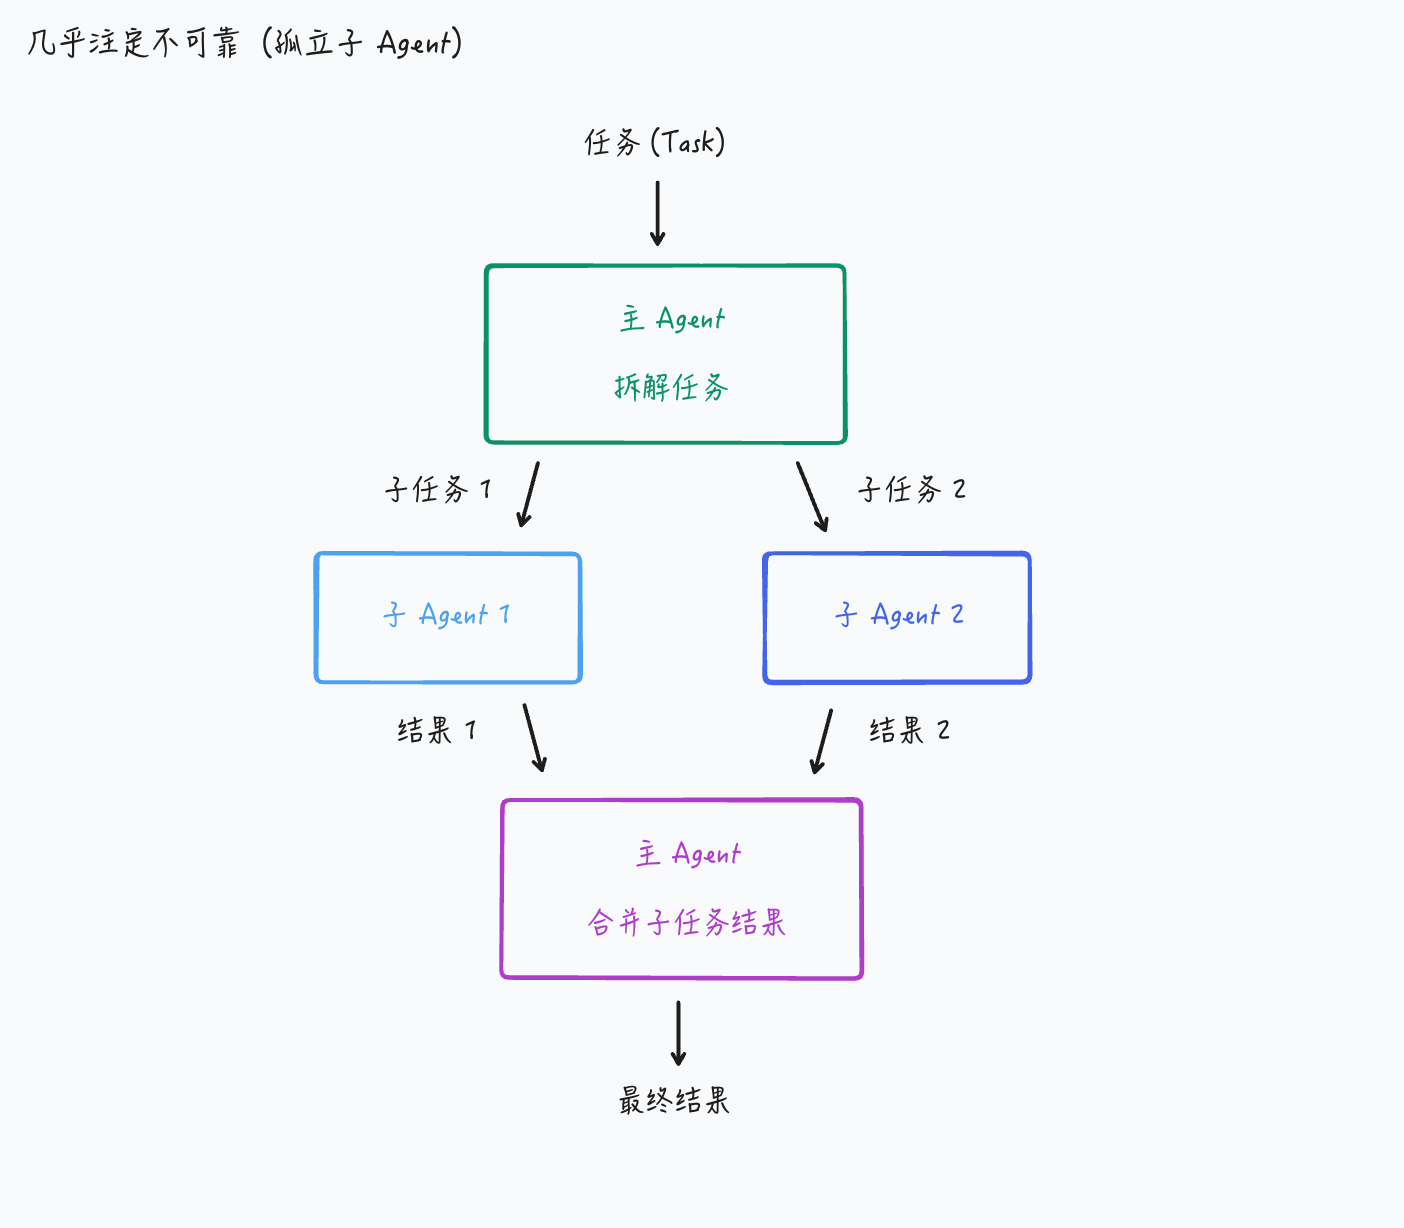
如果业务场景刚好包含几个看似能够并行的模块,这种「分而治之」的架构简直让人难以抗拒。然而在真实的工程实践中,这套架构几乎注定不可靠(Almost Surely Unreliable)。
一场代价高昂的「传话游戏」:以克隆 Flappy Bird 为例
为什么这套看似清晰的分工一上生产就会崩盘?我们不妨看一个具体的编程案例。
假设你给主控 Agent 下达了一个顶层任务:「帮我写一个《Flappy Bird》克隆版小游戏」。主控 Agent 经过思考,把任务一分为二,分发给两个互不通气的子 Agent:
- 派给
Subagent 1的指令是:「构建一个不断向后滚动的游戏背景,包含绿色的上下水管以及碰撞检测盒(hit-boxes)」。 - 派给
Subagent 2的指令是:「构建一只可以受玩家控制上下移动的小鸟角色」。
表面上看,这两个子任务边界清晰、分工明确。但当两个子 Agent 各自埋头写完代码交差时,灾难发生了:
Subagent 1在没有看到「Flappy Bird」全局要求的情况下,看到「绿色水管(green pipes)」和「滚动背景」,立刻联想到了《超级马里奥兄弟》(Super Mario Bros)。于是它用像素风贴图写了一套横版卷轴陆地关卡,水管全都牢牢长在地面上,而且用的是基于网格(Tile-based)的静态碰撞体积。Subagent 2只收到了「写一只可以上下移动的小鸟」的指令。它根本不知道这是一个需要重力加速度与空格键瞬时脉冲跳跃(Impulse Jump)的街机游戏,于是它用SVG画了一只写实风格的飞鸟图标,并绑定了键盘上下方向键(ArrowUp/ArrowDown)做匀速平滑平移。
最后,当负责收尾的主控 Agent 拿到这两份代码时,它面对的是一个《超级马里奥》风格的地面水管地图,外加一只用方向键匀速平移的 SVG 小鸟。两套代码在坐标体系、渲染循环(requestAnimationFrame)、物理引擎假设以及视觉画风上完全驴唇不对马嘴,主控 Agent 无论如何修补,都没法把这两段充满误解的产物缝合成一个能玩的《Flappy Bird》。
你可能会觉得这个例子有些极端,但只要你仔细审视真实世界里的软件工程任务,就会发现几乎每一个需求都包裹着数十层类似的隐性细节。
上下文工程的两条黄金原则
原则一:共享上下文,而且必须共享完整的执行轨迹,而非零散的单条指令
面对上面《Flappy Bird》的翻车现场,很多工程师的第一反应是:「那我把用户最初的原始任务提示词也一并复制给每一个子 Agent 不就行了吗?只要大家都知道是在写《Flappy Bird》,就不会把绿色水管写成《超级马里奥》了。」
这种修补在单轮 Demo 里或许能奏效,但在真实的生产级 Agent 系统中依然远远不够。因为在生产环境中,任务往往建立在长达十几轮的多轮对话之上;主控 Agent 在决定如何拆解任务之前,通常已经调用了文件检索工具(如 grep 或 glob)、读取了项目的 package.json、检查了现有的 Canvas 渲染器代码,并在内部推理中排除掉了好几种不可行的方案。这些前置探索过程中的任何一个微小发现,都会直接决定子任务应当如何被解读。
如果只把最后拆出来的那句干巴巴的 Subtask Prompt 丢给子 Agent,子 Agent 就丧失了此前所有的探索语境。这就引出了上下文工程的第一条黄金原则:共享上下文,而且必须共享完整的 Agent 执行轨迹(Full Agent Traces),绝不能只传递孤立的单条消息片段。
既然如此,我们不妨对架构做第一次升级:在启动 Subagent 1 和 Subagent 2 时,把主控 Agent 截至目前所有的对话历史与工具调用轨迹(Conversation & actions so far)完整地传递给每一个子 Agent;等它们干完活,再把各自的工作轨迹全部汇总回主控 Agent。
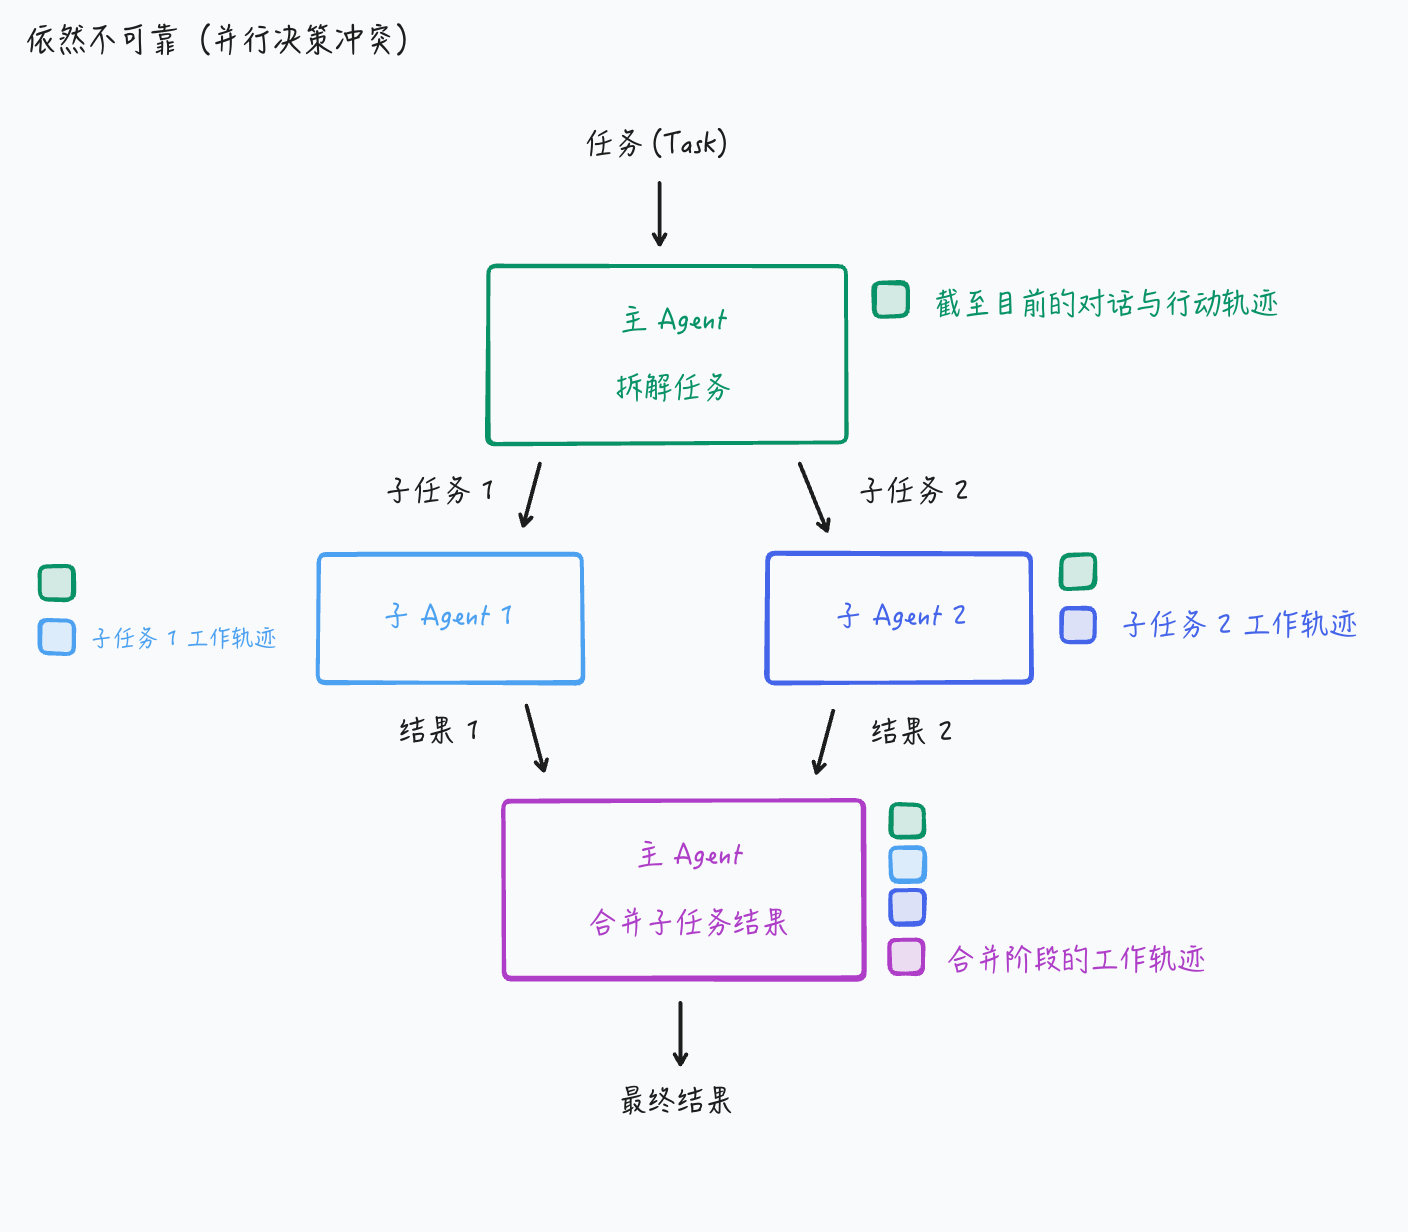
遗憾的是,即便做到了前置轨迹的完整共享,这套并发子 Agent 架构依然不可靠(Still Unreliable)。
回到《Flappy Bird》的任务。这一次,Subagent 1 和 Subagent 2 都完整读到了前置上下文,明确知道自己正在开发《Flappy Bird》。但是在它们各自独立编写代码的并发过程中,两者彼此看不到对方正在做什么:
Subagent 1在实现水管滚动时,自行决定采用60 FPS的固定帧率步进,将画布尺寸设定为400 × 600像素,把水管间距设为120px,并采用扁平化的复古8-bit像素画风;- 与此同时,
Subagent 2在编写小鸟物理逻辑时,自行决定采用基于时间戳差值(deltaTime)的物理积分,假设画布高度为1080px,给小鸟赋予了每次点击上升80px的跳跃力度,并采用了现代矢量的扁平圆润画风。
当两份代码再次汇合时,虽然它们都在写《Flappy Bird》,但小鸟的跳跃高度根本钻不过水管的缝隙,两边的物理时钟完全不同步,视觉画风更是格格不入。为什么会这样?因为它们在执行过程中做出的每一个具体动作,都包含着大量事先未曾在顶层指令中规定的隐性假设。
原则二:每一个动作都隐含着决策,相互冲突的隐性决策必然带来坏结果
在软件工程中,顶层规范永远不可能穷尽所有实现细节。当一个 Agent 写下一行代码、定义一个数据结构、或者选择一个坐标原点时,这个动作本身就已经拍板了数十个微观层面的架构决策。如果两个子 Agent 在同一时间各自独立采取行动,它们实际上是在并行地做出互不知情的隐性决策。
这就是上下文工程的第二条黄金原则:动作本身承载着隐性决策(Actions carry implicit decisions),而相互冲突的决策必然导致糟糕的结果。
Walden Yan 在文中给出了一个极为坚定的工程判断:原则一(共享完整轨迹)与原则二(避免隐性决策冲突)是如此根本,以至于在绝大多数场景下都不值得为了贪图并发而去违背它们。作为一条默认的架构纪律,你应当直接排除掉任何无法同时满足这两条原则的 Agent 架构。
听起来这像是一道紧箍咒,但实际上,在严格遵守这两条原则的前提下,我们依然拥有广阔的架构设计空间。
从单线程线性架构到「上下文压缩大模型」
遵守上述两条原则最简单、最直接的做法,就是彻底抛弃花哨的多 Agent 并发图,回归单线程线性 Agent(Single-threaded Linear Agent)。
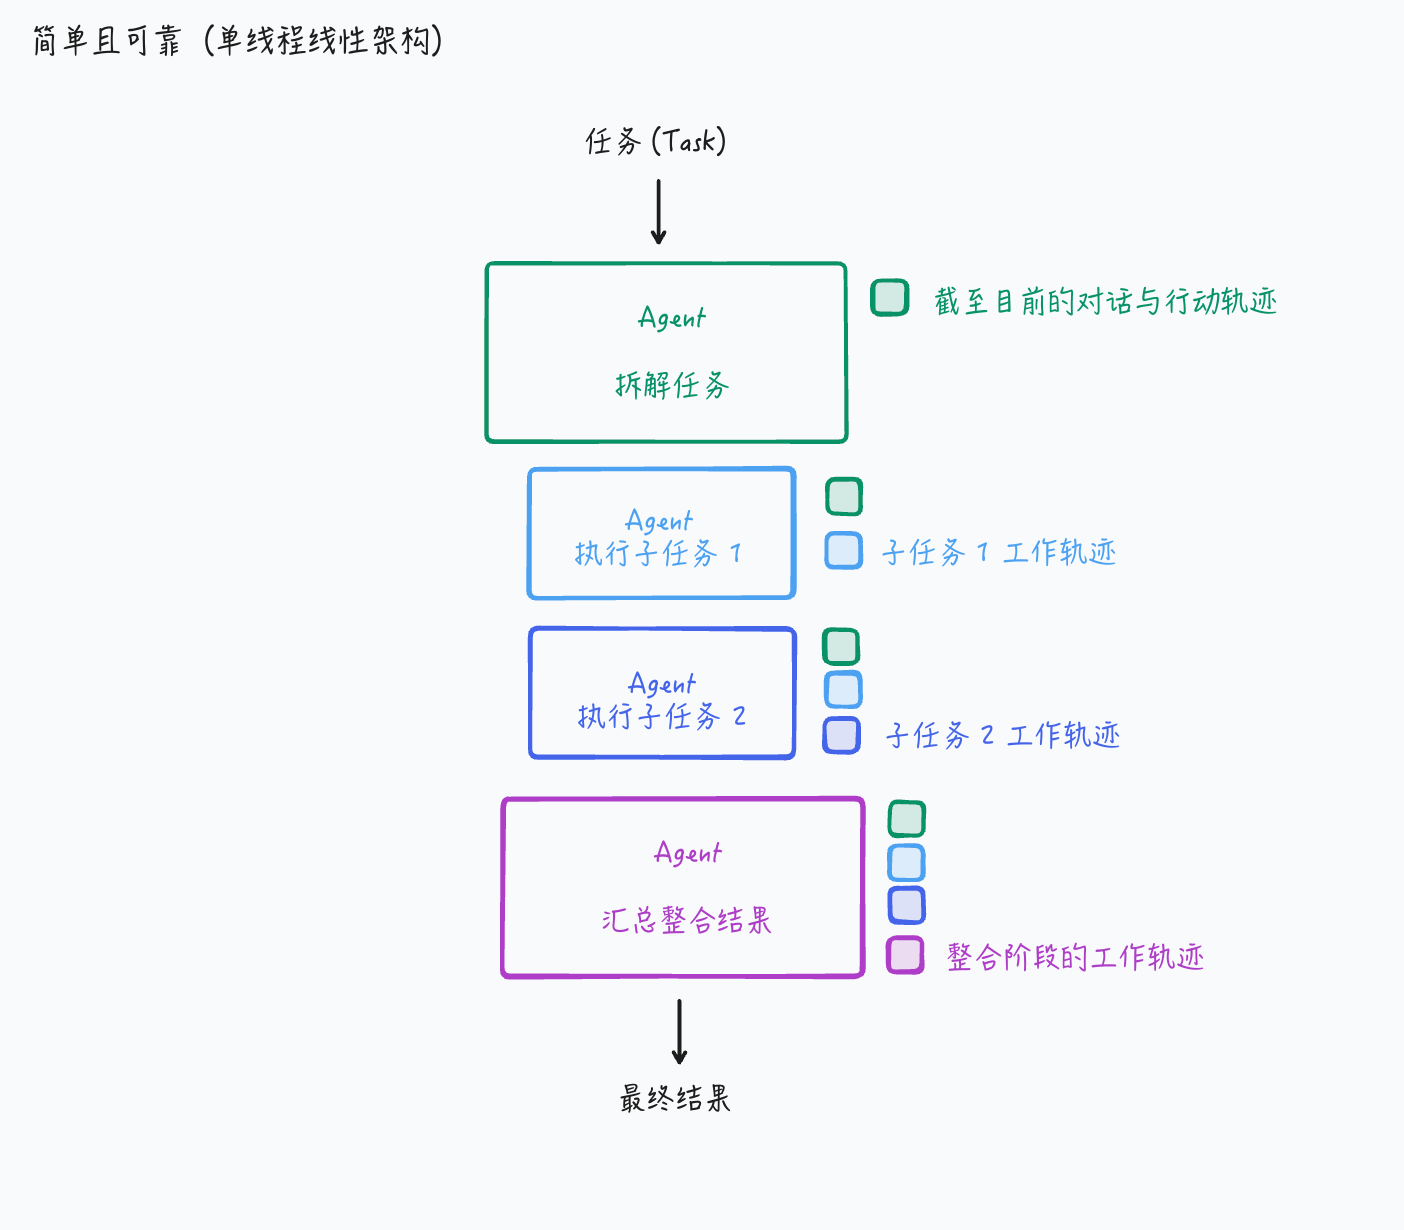
在单线程线性架构中,从拆解任务、执行子任务 1、执行子任务 2 到最终整合验证,自始至终都由同一个 Agent 沿着一条连续的时间线顺序推进:
- 当 Agent 开始执行「子任务 2(编写小鸟角色)」时,它的上下文窗口里不仅完整保留着最初的任务拆解轨迹,还完完整整地躺着刚刚执行完的「子任务 1(编写水管与背景)」的每一行代码、每一个参数选择和每一次工具调用结果。
- 它一眼就能看到子任务 1 已经把画布设为
400 × 600、水管间距设为120px、碰撞检测接口命名为checkPipeCollision(birdRect)。因此,它在写小鸟代码时,会自然而然地对齐同一套物理常量、坐标体系与视觉风格,彻底消除了隐性决策冲突。
对于绝大多数中短周期的工程任务,这套看似朴素的单线程线性架构不仅实现简单,而且可靠性远超复杂的多 Agent 编排。
然而,当任务规模继续扩大、执行周期拉长到数十个子阶段时,单线程线性架构会撞上一堵物理高墙:上下文窗口溢出(Context Overflow)。
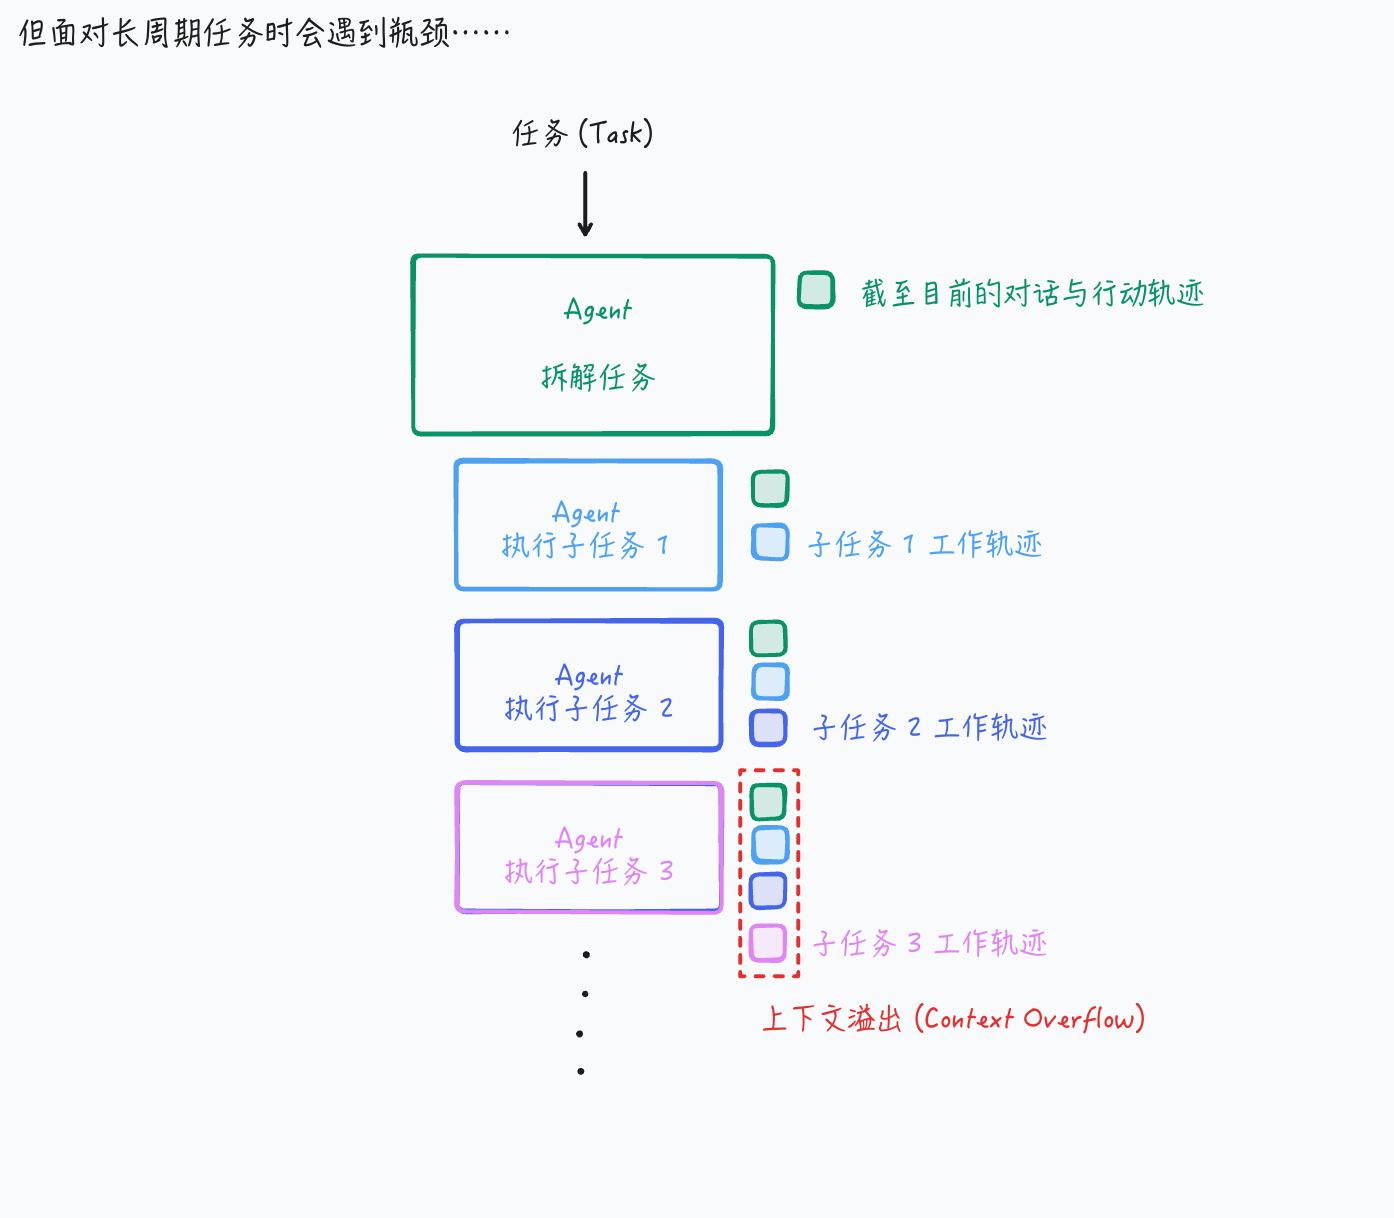
随着子任务 1、子任务 2、子任务 3……不断累积,工具返回的文件内容、终端报错日志与中间推理过程会迅速塞满 128K 甚至 200K 的上下文窗口。这不仅会导致推理延迟飙升、注意力涣散,最终还会直接触发模型的最大 Token 限制。
既然不能靠并发拆分子 Agent 来逃避上下文膨胀,真正面向长周期任务的生产级系统该怎么破局?Cognition 给出了一套经过实战检验的进阶架构:在单线程主干之上,引入专门的「上下文压缩大模型(Context Compression LLM)」。
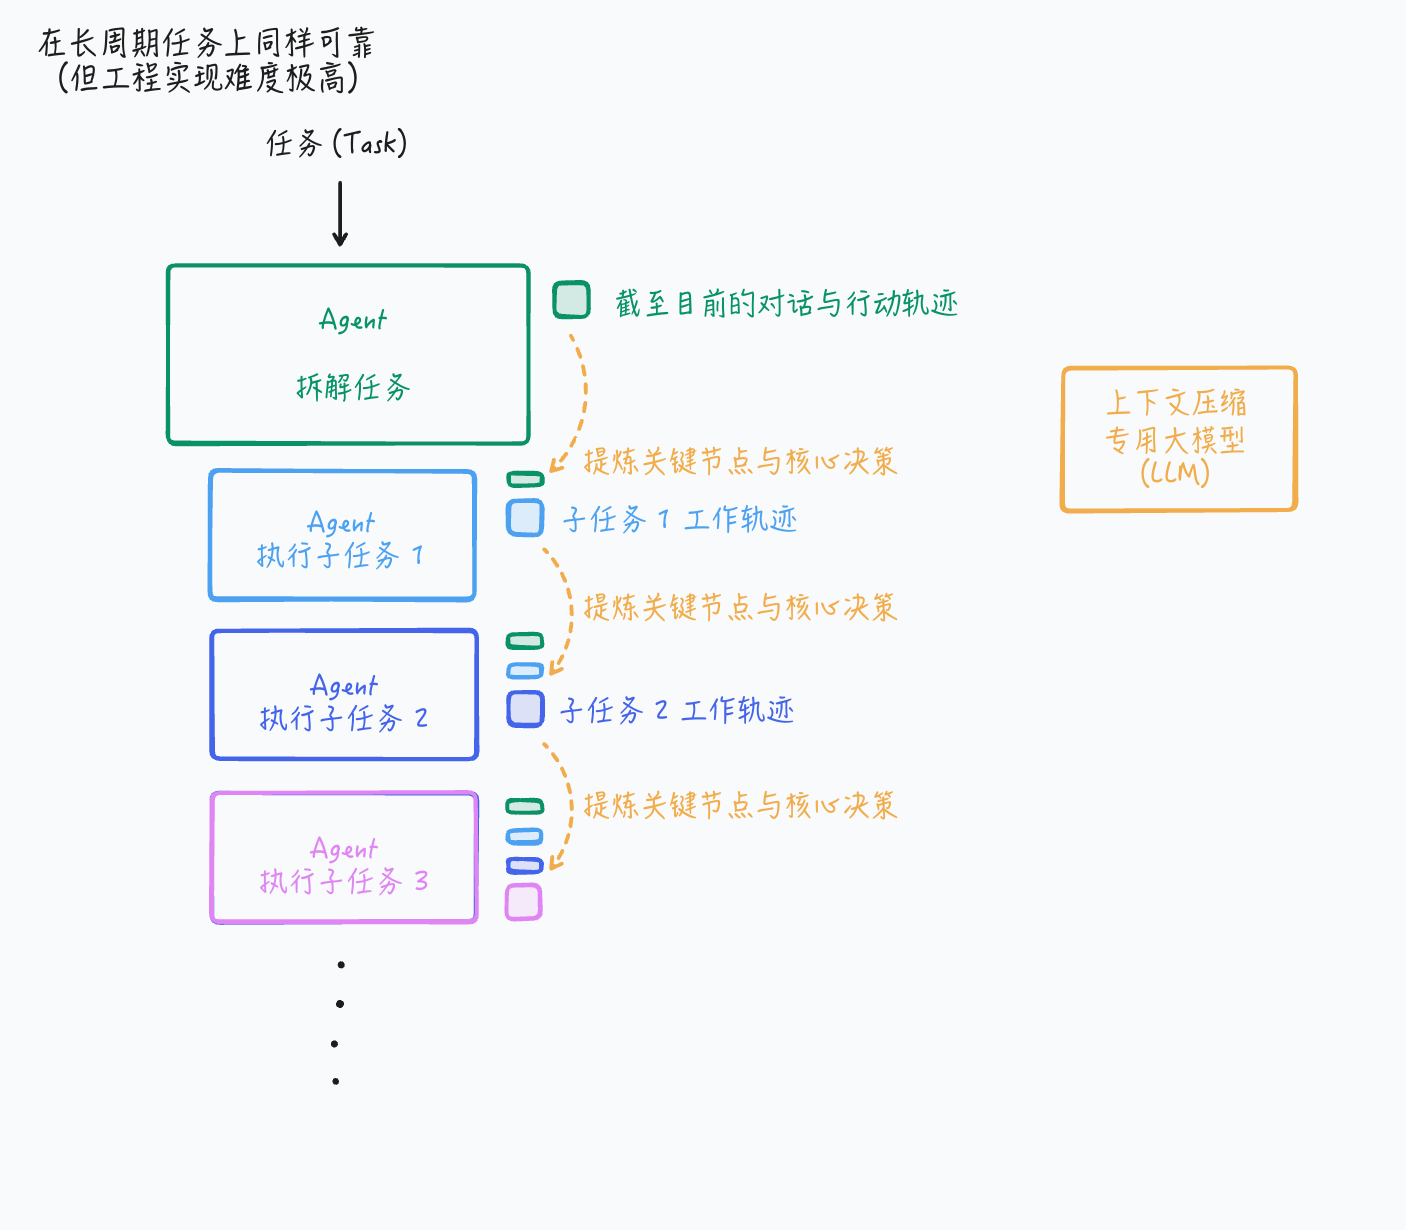
在这套架构中,Agent 的执行依然保持单线程线性推进,避免两个写入动作在互不知情时并发冲突;每完成一个阶段性子任务后,系统会调用专门负责上下文压缩的 Context Compression LLM,把此前冗长的原始对话和工具调用记录,提炼浓缩为高密度的「关键节点与核心决策(Key moments & decisions)」摘要块。
这样一来,当 Agent 进入下一个子任务时,它不需要背负前几个阶段成千上万行已经过时的终端调试输出,但前序阶段定下的所有关键接口契约、架构决策、全局常量与踩坑结论,都以极小体积的压缩态完整保留在上下文中。
Walden Yan 坦言,要把这个 Context Compression LLM 做好,工程难度极高(hard to get right)。你必须投入大量精力去界定:在特定业务领域里,究竟哪些信息属于「不可丢失的隐性决策」,哪些信息属于「用完即弃的搜寻噪音」。在 Cognition 内部开发 Devin 的过程中,团队甚至针对代码工程场景专门微调(Fine-tune)了定制的小尺寸模型来承担这项上下文压缩工作。
为了直观对比这四种架构在工程落地中的表现,我们可以将它们的核心特征整理如下:
| 架构模式 | 上下文传递机制 | 隐性决策一致性 | 长周期扩展性 | 生产环境可靠性评估 |
|---|---|---|---|---|
| 孤立并发子 Agent | 仅传递拆解后的单条子任务指令 | 极差(完全盲盒猜谜) | 高(天然隔离) | 几乎注定不可靠,仅适合毫无耦合的玩具级任务 |
| 共享前置历史的并发子 Agent | 共享分叉前的历史,分叉后彼此隔离 | 差(并发执行期假设冲突) | 中(分叉后各自累积) | 依然不可靠,合并阶段极易爆发接口与风格冲突 |
| 单线程线性 Agent | 全程连续追加完整对话与工具轨迹 | 极佳(后一步完全看见前一步) | 受限(长任务易触发 Context Overflow) |
简单且高度可靠,中短周期任务的默认首选架构 |
| 带上下文压缩的单线程架构 | 完整当前工作区 + 历史关键决策压缩块 | 优秀(核心决策链全程对齐) | 极佳(支持超长周期运行) | 长周期任务高度可靠,但压缩器研发与微调门槛极高 |
真实生产系统的印证:Claude Code 子 Agent 与 Edit Apply 模型的演进
如果不相信理论推导,我们不妨看看截至 2025 年年中,业界最顶尖的生产级编码 Agent 是如何在架构上践行这两条黄金原则的。Walden Yan 在文中举了两个极具代表性的工业界案例。
案例一:Claude Code 为什么从不让子 Agent 并行写代码?
用过 Anthropic 旗下终端编码工具 Claude Code 的开发者可能会注意到一个细节:Claude Code 内部确实存在拉起子 Agent(Subagent / Task tool)的机制。但这是否意味着 Claude Code 采用了多 Agent 协同编码架构?
恰恰相反。如果你仔细观察 Claude Code 的运行机制,会发现它严格遵守了两条铁律:
- 主 Agent 绝不与子 Agent 并行修改工作区;
- 子 Agent 几乎只被用于回答边界极其明确的只读探索问题(例如在大型代码库中搜索某个函数的定义位置或调用链路),绝不直接负责编写或修改业务代码。
为什么 Claude Code 的设计者要做出如此克制的限制?因为他们深刻理解上下文工程的边界:子 Agent 缺乏主 Agent 脑中完整的全局修改意图,如果让它直接动手改代码,必然会引入冲突的隐性决策;如果同时放出去多个并发写代码的子 Agent,整个代码库瞬间就会陷入合并地狱。
把子 Agent 严格限制为「只读侦探」,实际上是一种极其聪明的上下文卸载(Context Offloading)技巧。当主 Agent 需要搞清楚「项目中权限校验中间件在哪定义」时,子 Agent 可能需要执行十几次 grep 和文件读取才能找到答案。通过让只读子 Agent 去跑完这十几步大海捞针的搜索,最后只把一句确定的结论(「权限中间件位于 src/middleware/auth.ts 第 42 行」)返回给主 Agent,主 Agent 就避免了自己的主干上下文被十几屏无用的搜索中间过程污染。这实际上是用一种极简的工程方式,实现了我们在图 5 中提到的「上下文压缩」。
案例二:为什么「大模型写说明 + 小模型改文件」的 Edit Apply 架构正在消亡?
另一个极具说服力的历史教训,来自 2024 年各大 AI 编程工具(包括早期的 Devin、Cursor 早期版本以及各类 IDE 插件)普遍采用的 Edit Apply Model(编辑应用模型)架构。
在 2024 年,许多主力旗舰大模型虽然推理能力强,但在直接输出标准 diff 补丁或行号替换时经常算错行号、搞乱缩进。当时行业里通行的一种折中做法是「大小模型接力」:
- 先让聪明的大型主模型(如
GPT-4或Claude 3.5 Sonnet)阅读上下文,用自然语言Markdown加上代码片段的方式,写出一份「应该如何修改该文件」的修改说明; - 再把这份
Markdown修改说明连同原文件一起喂给一个速度快、成本低的小模型(Edit Apply Model),让小模型负责把整个文件重写一遍并落盘。
这其实就是一种微观层面的「双 Agent 接力架构」。而在真实的生产运行中,这套看似合理的流水线却成了故障重灾区。小模型因为没有参与主模型前序的多轮推理,根本看不到主模型做出修改决定时的完整轨迹;只要主模型输出的 Markdown 修改说明里有一丝一毫的指代模糊(比如写了一句 // ... keep existing validation logic ...),小模型就会频繁曲解主模型的意图,把不该删的代码删掉,或者把新逻辑插到错误的分支里。
到了 2025 年,随着基座模型工具调用与代码编辑能力的成熟,主流编码 Agent 纷纷废弃了这种「大模型口述、小模型代笔」的割裂模式,全面回归由同一个主模型在单次动作(One Action)中直接完成编辑决策与代码落盘。决策者与执行者合二为一,彻底消除了跨模型传话带来的上下文损耗。
为什么不让多个 Agent「互相开会商量」?
看到这里,依然会有不少偏爱多 Agent 架构的读者提出异议:「人类软件团队也是多个人并行写代码的呀!如果工程师 A 和工程师 B 的代码发生了逻辑冲突,大家坐下来开个会、拉个群把分歧聊透,达成共识不就解决了吗?为什么不能让多个子 Agent 之间也通过互相发消息来协商对齐呢?」
这正是许多学术论文与多 Agent 框架最喜欢描绘的愿景。但把人类团队的协作模式直接套用到 2025 年的大模型身上,忽略了一个致命的前提:人类在进行跨个体沟通时,拥有极高密度的元认知与重点提炼能力,而这恰恰是当前大模型最薄弱的短板。
当两名经验丰富的人类工程师对齐接口时,他们不需要把各自脑子里想过的每一行代码都背诵一遍,就能敏锐地捕捉到双方假设中可能冲突的那 3 个关键边界条件,并在几分钟的对话里达成契约。而今天的大模型既缺乏主动意识到「我的哪个隐性假设可能跟隔壁 Agent 冲突」的元认知能力,也无法在漫长的多方群聊中高效同步深层上下文。
如果你强行让两个分别拥有数万 Token 历史轨迹的子 Agent 通过自然语言对话来「协商解决冲突」,你会发现它们要么陷入客套而空洞的互相附和,要么在漫长的拉锯对话中双双迷失焦点,其最终可靠性远远比不上让一个单线程 Agent 从头到尾把两件事顺着干完。
Walden Yan 对多 Agent 的未来并没有持彻底的悲观态度。他认为,多 Agent 真正走向实用的前提,是「跨 Agent 的高保真上下文传递与主动协商」这一底层难题被攻克。而极具讽刺意味的是,目前行业里几乎没有人真正在死磕这个硬核的跨 Agent 上下文同步难题;大家只是在用简单的消息拼接搭建脆弱的多 Agent 玩具。
实际上,通往多 Agent 协作的钥匙,恰恰藏在单线程 Agent 的进化之中——只有当我们先把单个 Agent 与人类工程师之间的高密度沟通、主动澄清与上下文压缩做到极致时,Agent 与 Agent 之间的可靠协作才会水到渠成地自然解锁。
在此之前,当你着手构建下一个生产级 AI Agent 系统时,请先克制住画出一张庞大多 Agent 组织架构图的冲动:守住单线程的连续上下文,敬畏每一个动作背后的隐性决策,把 80% 的工程精力投入到上下文的筛选、卸载与压缩之中。
读完这一篇,记住这三件事
- 警惕「分而治之」的多 Agent 陷阱——在真实生产任务中,将任务简单拆给多个并行子 Agent 各自闭门造车,几乎注定会因为隐性假设不一致而产出一堆无法缝合的碎片。
- 死守上下文工程的两条黄金原则——第一,传递上下文时必须共享完整的执行轨迹(
Full Agent Traces),绝不能只传孤立的单条指令;第二,每一个动作都隐含着未言明的架构决策,必须从架构上杜绝多个写入动作在互不知情的情况下并行发生。 - 用「单线程主干 + 上下文压缩」替代盲目并发——优先采用单线程线性架构保证决策连续性;面对长周期任务的上下文溢出问题,可以通过只读子 Agent 卸载搜索噪音(如
Claude Code),或引入专门的Context Compression LLM提炼关键节点与核心决策。