哈喽大家好,我是欧呦,这篇文章将为大家分享我使用 AI 的四个高效习惯。
我现在几乎所有的事情都是由 AI 来处理的。但当这些操作变成每天的习惯之后,自己平时反而不觉得有什么特别,有时也不知道怎么把这些做法总结出来分享给大家。
所以你现在看到的这篇文章,本身就是用我日常最顺手的方式做出来的:我没有对着空白文档自己憋字,也没有让 AI 凭空替我编一篇教程,而是跟本地 AI Agent(比如 Codex、Claude Code 这类能直接读写电脑本地文件并执行操作的工具)说了一句「我想新增一篇使用 AI 的高效习惯,你可以开始采访我」,接着按住快捷键用语音聊了四轮,最后只让 AI 把我的原话整理成文。
整个过程里用到的动作,刚好串起了我每天高频使用 AI 的四个核心习惯——用实时语音快速输入上下文、让 AI 采访自己来写稿、挑最省事的方式给上下文与配环境,以及多话题并行和沉淀 Skill。下面我们就从最基础、也最能立竿见影改变沟通效率的「语音输入」开始一个个聊起。
习惯一:语音输入,不改错字
很多人平时跟 AI 协作还保留着手打字的习惯,但手打字太慢,往往在无形中限制了你给 AI 提供信息的质量。
为什么首选语音且不用改错别字?
我现在跟 AI 沟通几乎全部用语音输入,核心原因有两个:
第一,语音输入可以让我快速输入大量的上下文,让 AI 更加理解我的想法。比起手动打字要花很长时间,我嘴巴一说,在很短的时间里就可以说出很多很多的信息。平时大家觉得 AI 不懂自己、做出来的东西不对,往往是因为手打字太累,只愿意在输入框里敲短短一句话;而换成语音之后,你可以毫无负担地把背景、想法和要求一口气全倒给它。
第二,跟 AI 说话时,我根本就不会去改错别字。很多人不习惯用语音输入,是怕语音识别出现同音错字或者口语不够通顺,还得停下来手动删改。但对 AI 来说,一些错别字完全不影响它理解你的意思——比如在这篇文章的采访过程里,我用语音说出「闪电说」三个字时,输入法把它识别成了「闪电鼠」,句子中间还夹杂着「嗯」「啊」「呃」这样的口语停顿,我一个字都没改直接发出去,AI 依然能百分之百听懂。省掉「检查和修改错别字」这一步,语音输入的流畅度才会真正拉满。
配置方案:闪电说 + 阿里云实时模型
我自己日常用的是桌面端语音输入工具 闪电说(安装后按住快捷键说话,就能把语音直接转成文字输入到当前光标位置),再搭配 阿里云 的实时语音识别模型 qwen3-asr-flash-realtime,这套组合已经能够解决我大多数的需求了。
之所以用这套组合,而不用市面上那些主打 AI 的付费语音输入产品,主要是因为那些产品的价格太高了,动辄每个月十几美元订阅费;而且很多产品的卖点是「用大模型把你说的话二次改写润色后再上屏」,但在跟 AI Agent 说话的时候,我根本不需要它帮我去再次整理我的语音,我就希望它遵循我原始的这种语音输入就够了。保留最原始的语音输入,既不需要为多余的二次润色买单,也不会因为等待大模型改写而拖慢上屏速度。
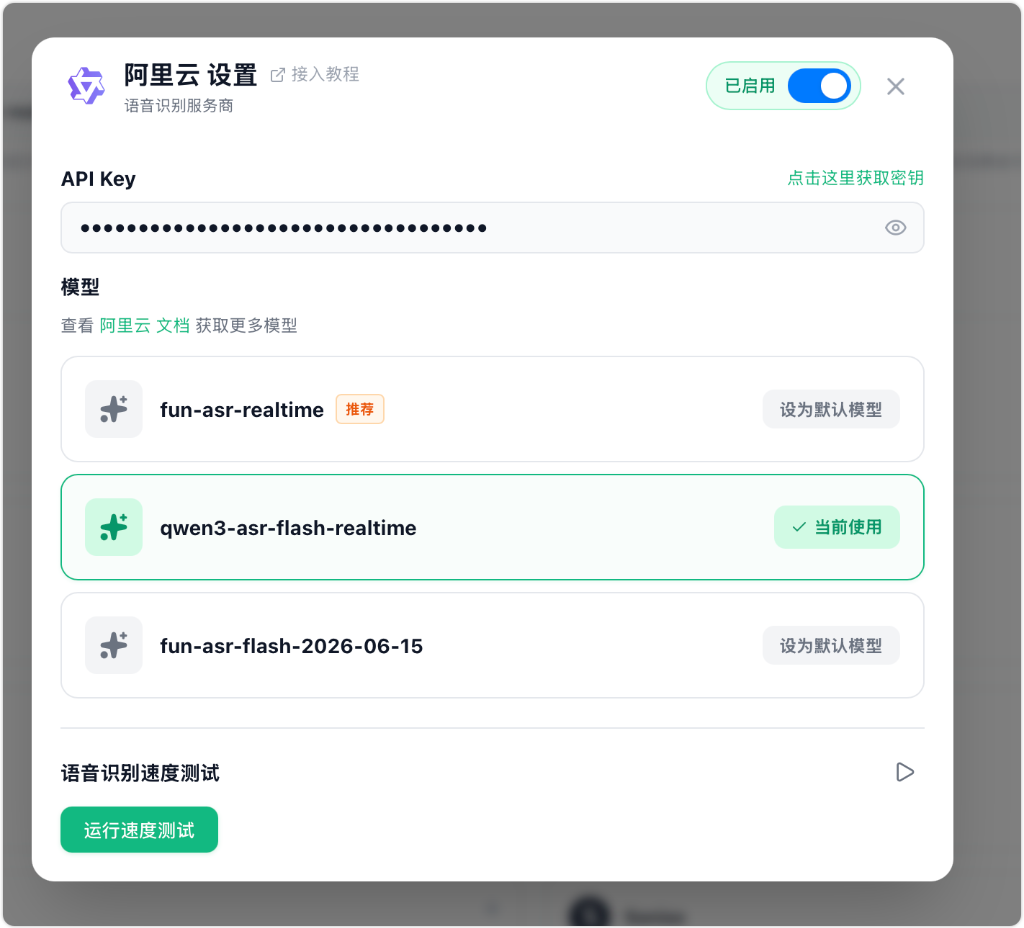
如果你想直接照着我的方案配一套,关键设置就三步:
- 接入阿里云语音识别服务:在闪电说的语音识别服务商里打开「阿里云 设置」,可以直接点界面右上角的「接入教程」或「点击这里获取密钥」,去阿里云后台获取一个 API Key 填进去并把右上角开关打开。
- 模型选择
qwen3-asr-flash-realtime:如上方截图所示,列表里有几个不同模型,我选择的是qwen3-asr-flash-realtime。之所以选这个模型,是因为我自己实测下来它的速度非常快,几乎是实时的;而且它的价格非常便宜,每天高频使用,一个月算下来可能也就几块钱。 - 把快捷键设在顺手的单键上:我给闪电说配置的快捷键是键盘右边的
Option键。平时右手大拇指顺手一按就能直接开口说话,说完松开就实时上屏发给 AI,全程不需要去记复杂的组合键。
习惯二:让 AI 采访自己,只整理原话
解决了「怎么用语音快速表达」之后,紧接着就会遇到第二个问题:当我们脑子里有一些实战经验,想写成一篇文章、整理成视频稿或者梳理成方案时,哪怕用语音,对着空白文档也很难一口气从头讲到尾。
为什么只让 AI 整理,不让它直接写?
遇到这种情况,我从来不会丢一个题目让 AI 直接去写。因为 AI 凭空写出来的东西一定是不符合我的预期的——它不知道我真实的经历和判断标准是什么,只能拿网上的套话来凑字数。
既然让 AI 凭空代写不行,自己对着空白文档又觉得千头万绪、不知道从哪下笔,最顺手的办法就是反过来让 AI 扮演采访者一步步向我提问,我自己用语音输入回答,最后只让 AI 来帮我整理原话。
怎么给 AI 定采访规则?
要想让 AI 采访得自然、最后整理出来的文章又不变成满篇 AI 味的脑补长文,关键是在开始前给它定好采访和整理的边界。如果只是随口对 AI 说一句「你来采访我」,它很容易一次甩出十几个大问题像审讯一样,或者到了最后成文时还是忍不住自己瞎编套话。
就拿我们现在看到的这篇文章来说,我在项目规范里给 AI 定好了明确的规则:开始采访后,AI 每次只问我 1 到 2 个问题,并且必须根据我上一轮的实际回答去动态思考下一个问题(比如我第一轮提到用了闪电说和阿里云模型,它第二轮就顺着追问我为什么选这个模型、平时改不改错别字)。在问答的同时,本地 Agent 会把每一轮的问题和我语音输入的原始原话一字不改地保存进本地的访谈原稿文件里;等四轮聊透之后,它先按文章脉络归拢出一份完全来自我原话的底稿让我确认,确认无误后才正式动笔,把我的口述原稿理顺成书面段落。
平时你想写文章、写复盘或者梳理方案时,可以直接把下面这四条规则发给你的 AI(如果你用的是网页版对话框,让它在对话结束归拢大纲前先记住你的原话即可;如果用的是本地 Agent,可以直接让它把原话存进一个 .md 文件里):
我想写一篇关于【主题】的内容,请担任采访者来采访我:
- 动态追问:每次只问我 1–2 个问题,不要一次列一堆问题;根据我上一轮的实际回答,替读者追问原因、具体做法和细节;
- 保留原话:我会用语音输入回答,里面可能有同音错别字或口语停顿,请直接理解原意,并把每一轮问答的我的原始输入一字不改保存下来;
- 先确认底稿:聊清楚后先别直接写长文,按文章脉络归拢一份 100% 来自我原话的底稿发给我确认;
- 只整理不脑补:确认后正式成文时,严格以我的原话为唯一底本,只做结构梳理和语句润色,绝不擅自脑补我没说过的观点。现在请开始问我第一个问题。
习惯三:用最省事的方式给上下文
前面两个习惯都是在解决「怎么把我们脑子里的想法高效地告诉 AI」;而在日常干活时,还有大量信息本来就已经在网页、屏幕或文档里了。这时候我的原则很简单:给 AI 提供信息时,永远选择更加方便传递的上下文,不要自己费口舌去转述。
链接、截图与 Selector 选元素
很多人跟 AI 描述问题时,习惯自己用文字去形容:「我打开了某某网页,上面第三段写了一个报错……」或者「页面中间偏右那个按钮下面有一行字看着怪怪的,帮我删掉……」。其实换一种更直接的传递方式,几秒钟就能交代清楚:
- 能看网页就直接给链接:如果 AI Agent 本身能够自己去看浏览器或读取网页,那我就直接把链接丢给它,绝不自己手动把网页内容复制粘贴过来;
- 看图更快就直接给截图:如果我当下发觉一张截图能够帮助 AI 更快定位问题(比如展示刚才那张闪电说的阿里云设置面板,或者某个弹窗报错),我就直接截张图甩给它;
- 改网页具体位置就用
Selector点选粘贴:平时在 Vibe Coding(做网页或前端界面)时,如果我想要快速选择页面上的某一个具体元素让 AI 修改,我会用自己开发的一个小工具叫做 Selector(oil-oil.github.io/selector)。把它安装到浏览器书签栏之后,每当我想修改页面上的某一个具体位置,只要点一下书签打开这个小工具、在页面上直接点选那个位置,它就会自动把该元素的选择器路径复制下来。比如刚才我审阅这篇文章的初稿页面时,想让 AI 把图片底部的图注删掉,我就是直接用 Selector 点了一下那行字,粘贴给 AI Agent:
Page: http://127.0.0.1:8765/reader.html?state=chapter-coding-3

1. figcaption "把上下文一口气说出来 手打字费时费力、往往只敲出简短一句…" <figcaption>
   selector: #illustrated-01-voice-vs-typing-v1 > figcaption
   inside: main "我使用 AI 的四个高效习惯"
连同语音说一句「把类似这种图片里的描述全部移除」,AI 就能零误差地定位到代码里的具体标签,完全不需要自己去翻源码或用文字描述位置。
复杂环境配置直接甩链接给 Agent
「直接给链接」不仅能用来让 AI 查资料,还能彻底省掉你在电脑上装软件、配复杂环境的时间。以前在电脑上下载开发工具、配置复杂的运行环境,大家习惯先去搜教程,然后自己打开终端一行行复制粘贴命令,报错了再去搜报错。
现在既然本地 Agent 自己就能读网页链接、跑终端命令,我的做法是:我所有的电脑环境、下载软件,只要是复杂配置,一般都直接把官方文档链接抛给本地的 Agent,直接让它操作就好了。 比如你可以直接把安装文档的网址丢给本地 Agent,跟它说一句:
这是官方文档链接:<文档地址>,请直接帮我把这套环境下载并配置好,怎么方便怎么来。
现在的本地 Agent 本身就能在终端里调用命令,如果再配合浏览器自动化或电脑自动化工具,它还能自己打开网页或操作界面。把文档链接丢给它之后,它认为怎么样的方式最方便,就让它自己去做,我自己不再去手动折腾这些繁琐的配置步骤。
习惯四:多话题并行与沉淀 Skill
当你习惯了像上面这样把写稿、改代码、配环境全都甩给本地 Agent 之后,很快就会遇到一个新的情况:Agent 在读取文档、配置环境或修改代码时,往往需要自己在后台执行好几分钟。怎么利用好这段时间、以及怎么避免明天再重复交代同样的事情,就引出了我的第四个习惯。
多话题并行推进,不在单窗口干等
如果每次交代完任务都盯着一个窗口等它跑完再做下一件事,人就会把大量时间浪费在看进度条上。
所以我日常都是在客户端里并行开很多个话题(Threads,也就是多个独立的对话窗口)去同时执行任务的。比如第一个话题里 Agent 正在帮我配置新的电脑环境,我马上切到第二个话题用语音安排另一个项目的代码修改,同时第三个话题里让 Agent 帮我处理今天视频的素材。人只需要在各个话题之间轮流用语音给上下文、看一眼执行结果即可。
每天重复做的事,提炼成 Skill
除了在当下并行推进多个任务,我日常工作里更看重的一个准则是:我今天做的很多工作,都是为了节省后续工作的时间。
只要我有每天都要重复做的事情,我一定不会让自己每天都重新跟 AI 交代一遍,而是一定会把它提炼成 Skill。比如说我日常需要做自媒体,我每天都需要给视频做封面、每天都需要给视频做字幕,那我把这套做封面、加字幕的流程带着 AI 跑通一次之后,立刻就会让 AI 把它沉淀成固定的 Skill 和配套脚本(如果你还不了解什么是 Skill、或者想知道怎么从零写一个好用的 Skill,可以直接看前面的《从 0 到 1 学懂与用好 Skill》和《如何从 0 到 1 写一个好用的 Skill》)。
一旦把每天重复做的动作封装成 Skill,以后再做同样的事情就不需要重新交代步骤了。不妨今天就从第一个习惯开始试试:装上语音输入工具、绑好右边的 Option 键,开口跟你的 Agent 说第一段话,体验一下不用打字、不用改错别字的高密度协作感。